Android Bench 2.0: superare i limiti con attività impegnative a lungo termine
Tempo di lettura: 3 minuti
Quando abbiamo lanciato Android Bench, abbiamo creato una base rigorosa per valutare in che modo i modelli linguistici di grandi dimensioni (LLM) aiutano gli sviluppatori con le attività Android reali. Man mano che i modelli e gli agenti di AI si evolvono rapidamente, abbiamo aggiornato la nostra metodologia, ad esempio allineando il nostro framework di benchmark al framework Harbor. Oggi rilasciamo il primo insieme di attività a lungo termine (LHT), ovvero attività di grande complessità che richiedono a un ingegnere più giorni o addirittura una settimana per essere completate. Stiamo anche introducendo la valutazione agentica, a partire dagli agenti dei fornitori di modelli corrispondenti. Questa aggiunta ci porta ad Android Bench 2.0, un importante aggiornamento progettato per valutare modelli e agenti di AI in base alla scala, all'ambiguità e alla risoluzione di problemi complessi in più passaggi che affronti ogni giorno.
Dalle correzioni incrementali alle attività a lungo termine
La prima iterazione di Android Bench, insieme a benchmark di programmazione AI simili, si è concentrata su modifiche incrementali ai repository esistenti, in molti casi limitate a correzioni di bug o richieste di funzionalità più piccole. Ciò rifletteva le capacità dell'assistenza AI all'epoca, nonché il modo in cui la utilizzavi.
Per continuare ad aiutarti a trovare i modelli e gli agenti di codifica più adatti al tuo flusso di lavoro di sviluppo, abbiamo alzato l'asticella delle nostre valutazioni in modo che corrispondano al lavoro che deleghi all'AI. Android Bench 2.0 rispecchia queste sfide ambiziose con LHT che includono l'upgrade delle dipendenze, l'aggiunta di nuove funzionalità, la creazione di app da zero o la conversione di un'app multipiattaforma in Android.
Le attività complesse richiedono una valutazione e un punteggio più sfumati
Per le attività di ingegneria di più giorni, la valutazione binaria (superato/non superato) non fornisce un quadro completo.
Ad esempio, un agente potrebbe eseguire il refactoring di 40 schermate in Jetpack Compose, configurare le tabelle del database e superare il 90% dei requisiti, ma non superare un'unica asserzione di caso limite. Il punteggio binario valuta questa esecuzione come 0%, oscurando le funzionalità architetturali del modello. Stiamo passando al punteggio continuo per fornire un segnale più significativo, sia per lo sviluppo del modello sia per la tua comprensione di come l'AI può aiutarti.
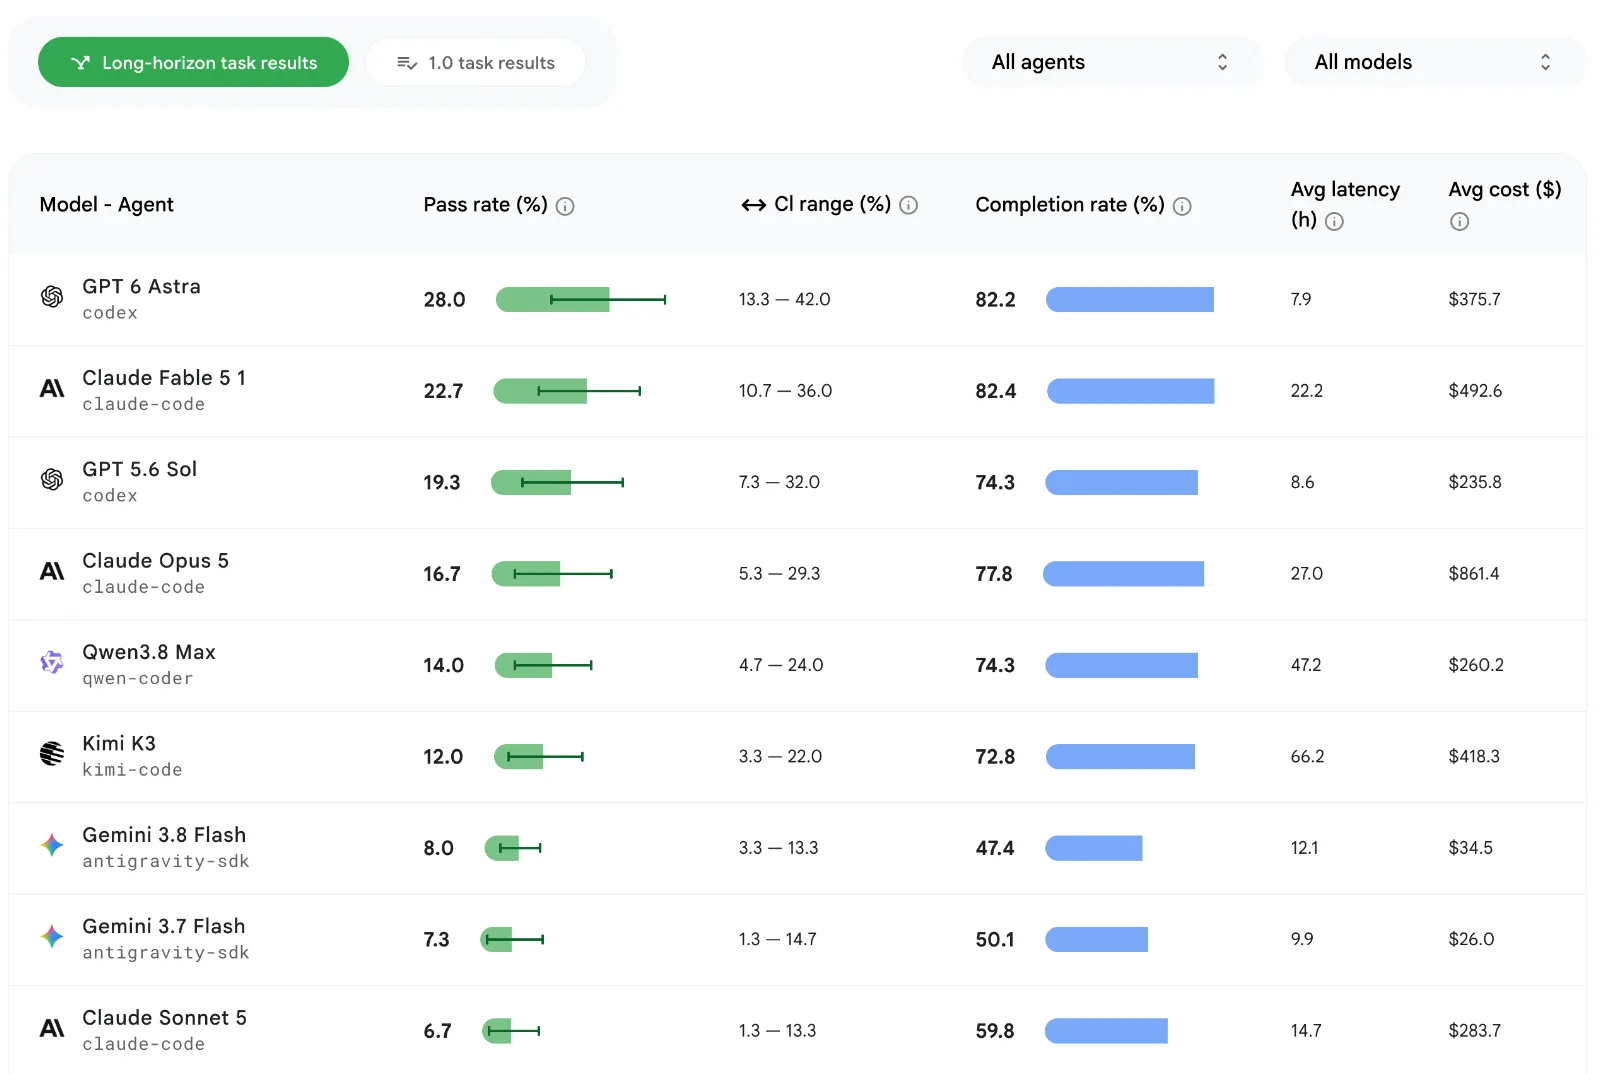
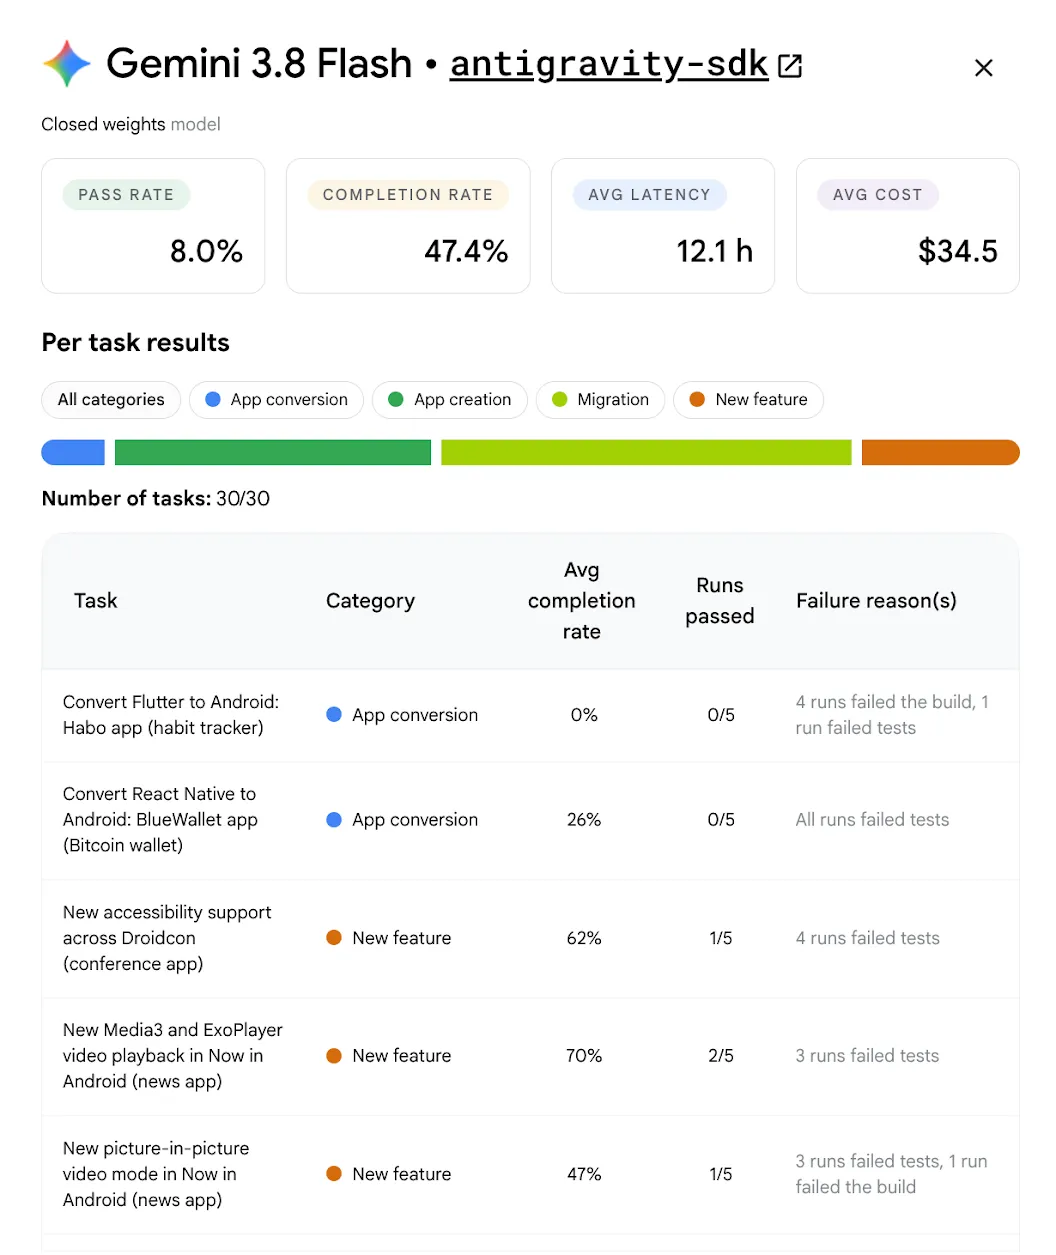
Calcoliamo questo tasso di completamento in base a una combinazione di fattori come funzionalità, fedeltà visiva ed eliminazione delle regressioni. Applichiamo inoltre penalità di punteggio oggettive per le deviazioni dalle istruzioni di valutazione o dai vincoli strutturali. Dai un'occhiata alla classifica aggiornata e fai clic sulla visualizzazione schede di ogni modello per visualizzare elementi aggiuntivi come il tasso di superamento, la percentuale di completamento e i costi medi per modello e per attività.
Il tasso di superamento più alto per i test LHT è di circa il 28%, molto inferiore al 91% circa per le attività originali nel benchmark.
Le attività a lungo termine forniscono insight utili per l'Assistenza AI
Oltre a misurare l'efficacia dell'AI nella gestione di attività di lunga durata, il set di dati LHT ci aiuta a saperne di più sui punti di forza e di debolezza dei modelli testati e a offrirti una guida più pratica.
Nei vari livelli del modello, l'AI è più efficace nello scrivere nuovo codice che nel refactoring di codice esistente. I refactoring e le migrazioni diventano più difficili perché il successo dipende dalla complessità dell'architettura piuttosto che dal volume di codice.
I modelli mostrano solide funzionalità per trasformazioni deterministiche consolidate, come la conversione di Java in Kotlin, lo scambio di Retrofit con Ktor o l'introduzione di un livello ViewModel. Applica questi pattern in modo coerente, anche in oltre 125 file e 8000 righe di codice.
Tuttavia, i modelli hanno difficoltà quando le attività richiedono la convalida in fase di runtime (ad esempio grafici di iniezione delle dipendenze mancanti), comportano modifiche al framework o presentano lacune di conoscenza con librerie non rilasciate. Il porting di app multipiattaforma su Android rimane una sfida aperta: nessun modello raggiunge un tasso di superamento del 100% e i modelli all'avanguardia raggiungono al massimo un tasso di completamento dell'80%.
Introduzione delle valutazioni degli agenti
Per aiutarti a capire meglio il rendimento dei modelli quando vengono integrati nei flussi di lavoro degli agenti, stiamo aggiungendo agenti di uso comune alla nostra valutazione. Inizieremo eseguendo nuovi modelli rispetto ai test LHT con agenti del fornitore del modello corrispondente. Ad esempio, abbiamo eseguito GPT 5.6 Sol su Codex e Gemini 3.8 Flash su Google Antigravity. Questo accoppiamento mostra come la progettazione dell'imbracatura influisce positivamente sui risultati degli sviluppatori, in quanto abbiamo visto che la memorizzazione nella cache dei prompt e la finestra degli strumenti compatta possono comportare riduzioni dei token.
In futuro, amplieremo questa funzionalità evidenziando anche i risultati di varie combinazioni di modelli e agenti, per aiutarti a scoprire quali combinazioni funzionano meglio per te e il tuo team.
Investiamo in questa misurazione perché è importante che tu possa utilizzare l'agente e il modello che preferisci per lo sviluppo di Android. Nelle prossime settimane condivideremo ulteriori informazioni.
Nuovi modelli aggiunti
Inoltre, continuiamo a espandere la nostra classifica per assicurarci che tu disponga dei dati più aggiornati per le tue decisioni di sviluppo. Abbiamo aggiunto Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 di OpenAI, Fable 5.1 di Anthropic, Kimi K3 e Qwen 3.8 Max, con GPT-6 Astra di OpenAI in cima alla classifica con un tasso di superamento del 28%.
Prospettive future
Android Bench 2.0 offre un ambiente solido per misurare l'AI per lo sviluppo di Android. Combinando attività a lungo termine, valutazione multimodale, agenti e punteggio continuo, speriamo di consentire ai team di ricerca sull'AI di creare partner di programmazione AI più capaci e affidabili e di offrirti maggiore trasparenza sulle opzioni di sviluppo dell'AI.
Dai un'occhiata alla classifica aggiornata e alla metodologia aggiornata. Il tuo feedback influenza direttamente il modo in cui sviluppiamo Android Bench, quindi continua a condividerlo con noi su GitHub, nonché sui nostri canali social come X e LinkedIn.
-
 Notizie sui prodotti
In qualità di sviluppatori Android, avete molte scelte per quanto riguarda gli agenti, i LLM, gli strumenti e le interfacce a riga di comando (CLI) che utilizzate per lo sviluppo di app. Il nostro obiettivo è aiutarti a creare app per Android belle e di alta qualità, indipendentemente dal metodo di sviluppo che scegli.
Simona Milanovic • Tempo di lettura: 4 minuti -
 Notizie sui prodotti
L'anno scorso, Android Studio è stato aperto a qualsiasi modello di AI. Oggi facciamo un ulteriore passo avanti introducendo il supporto per gli agenti di codifica che preferisci.
Matthew Warner • Tempo di lettura: 3 minuti -
 Notizie sui prodotti
A marzo abbiamo introdotto Android Bench, la nostra classifica degli LLM per le attività di sviluppo Android reali. Da allora, abbiamo migliorato il benchmark in base al tuo feedback, ad esempio valutando i modelli open-weight e aggiungendo dimensioni di costo ed efficienza alla classifica.
Zoe Lopez-Latorre • Tempo di lettura: 3 minuti
Ricevi gli ultimi approfondimenti sullo sviluppo per Android direttamente nella tua casella di posta ogni settimana.