Android Bench 2.0: pokonywanie kolejnych granic dzięki wymagającym zadaniom długoterminowym
Czas czytania: 3 minuty
Gdy po raz pierwszy wprowadziliśmy Android Bench, stworzyliśmy solidne podstawy do oceny, w jaki sposób duże modele językowe (LLM) pomagają programistom w wykonywaniu rzeczywistych zadań związanych z Androidem. W miarę szybkiego rozwoju modeli i agentów AI aktualizujemy naszą metodologię, np. dostosowujemy ramy porównawcze do ram Harbor. Dziś udostępniamy pierwszy zestaw zadań długoterminowych (LHT), czyli bardzo złożonych zadań, których wykonanie zajmuje inżynierowi kilka dni, a nawet tydzień. Wprowadzamy też ocenę agentów, zaczynając od agentów od odpowiednich dostawców modeli. Dzięki temu testowi mamy teraz Android Bench 2.0 – to znaczące ulepszenie, które pozwala oceniać modele i agenty AI pod kątem skali, niejednoznaczności i złożonego, wieloetapowego rozwiązywania problemów, z którymi stykasz się na co dzień.
Od drobnych poprawek po zadania długoterminowe
Pierwsza wersja Android Bench, podobnie jak inne wczesne testy porównawcze dotyczące kodowania z użyciem AI, koncentrowała się na przyrostowych zmianach w istniejących repozytoriach, w wielu przypadkach ograniczonych do poprawek błędów lub mniejszych próśb o dodanie funkcji. Odzwierciedlało to możliwości pomocy AI w tamtych czasach, a także sposób, w jaki z niej korzystałeś(-aś).
Aby nadal pomagać Ci w znajdowaniu modeli i agentów do kodowania, które najlepiej pasują do Twojego procesu programowania, podnieśliśmy poprzeczkę naszych ocen, aby odpowiadały one pracy, którą delegujesz do AI. Android Bench 2.0 odzwierciedla te ambitne wyzwania w ramach LHT, które obejmują aktualizację zależności, dodawanie nowych funkcji, tworzenie aplikacji od podstaw lub konwertowanie aplikacji na wielu platformach na Androida.
Złożone zadania wymagają bardziej szczegółowej oceny i punktacji
W przypadku zadań inżynieryjnych trwających kilka dni ocena binarna (zdane/niezdane) nie oddaje pełnego obrazu sytuacji.
Na przykład pracownik może przekształcić 40 ekranów na Jetpack Compose, skonfigurować tabele bazy danych i spełnić 90% wymagań, ale nie spełnić jednego warunku w przypadku skrajnym. Ocena binarna przypisuje temu uruchomieniu 0%, co zaciemnia możliwości architektury modelu. Przechodzimy na ciągłe ocenianie, aby dostarczać bardziej wartościowe sygnały zarówno na potrzeby rozwoju modelu, jak i Twojego zrozumienia, jak AI może Ci pomóc.
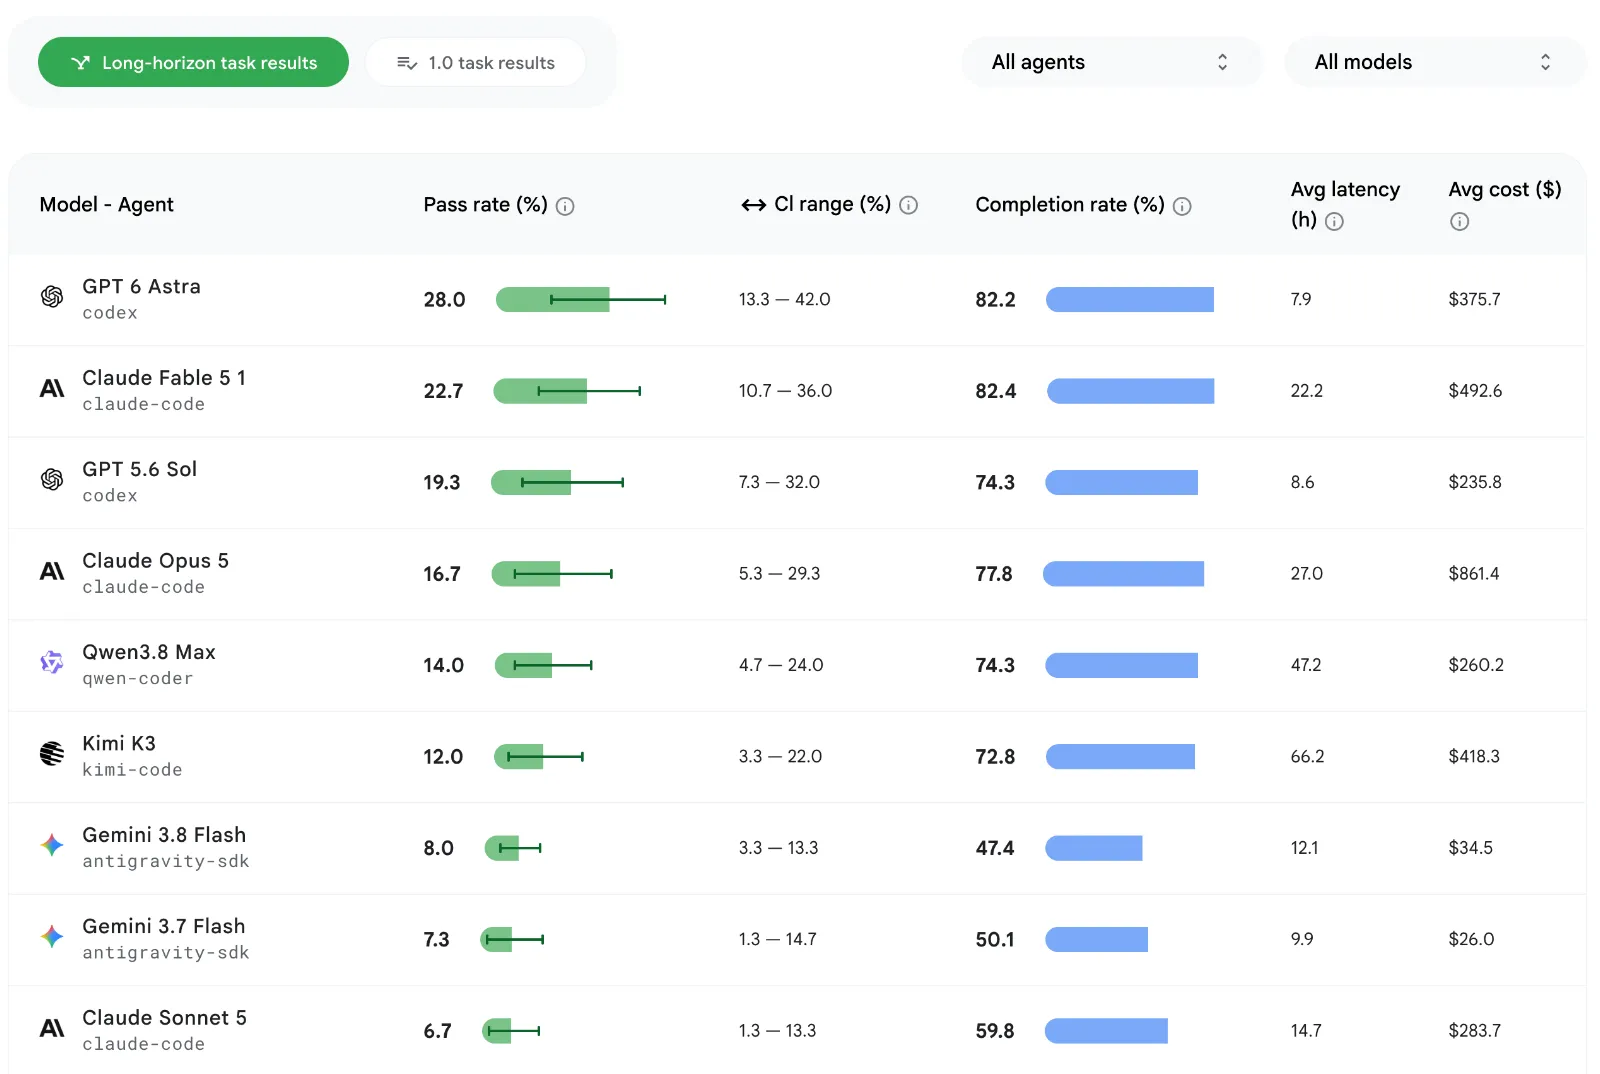
Obliczamy ten wskaźnik ukończenia na podstawie różnych czynników, takich jak funkcjonalność, wierność wizualna i unikanie regresji. Stosujemy też obiektywne kary punktowe za odchylenia od instrukcji oceny lub ograniczeń strukturalnych. Sprawdź zaktualizowaną tabelę wyników i kliknij kartę każdego modelu, aby wyświetlić dodatkowe elementy, takie jak odsetek zaliczeń, odsetek ukończeń i średnie koszty według modelu i zadania.
Najwyższy odsetek poprawnych odpowiedzi w przypadku testów LHT wynosi około 28%, czyli znacznie mniej niż w przypadku pierwotnych zadań w teście porównawczym (~91%).
Zadania długoterminowe dostarczają pomocnych statystyk dla pomocy AI
Zbiór danych LHT pozwala nam nie tylko mierzyć, jak dobrze AI radzi sobie z długotrwałymi zadaniami, ale też lepiej poznawać mocne i słabe strony testowanych modeli, dzięki czemu możemy oferować bardziej praktyczne wskazówki.
Na wszystkich poziomach modeli AI lepiej radzi sobie z pisaniem nowego kodu niż z refaktoryzacją istniejącego. Refaktoryzacja i migracja stają się trudniejsze, ponieważ sukces zależy od złożoności architektury, a nie od ilości kodu.
Modele wykazują duże możliwości w przypadku dobrze znanych, deterministycznych przekształceń, takich jak konwersja z Javy na Kotlin, zamiana Retrofit na Ktor czy wprowadzenie warstwy ViewModel. Stosują te wzorce konsekwentnie, nawet w przypadku ponad 125 plików i ponad 8000 wierszy kodu.
Modele mają jednak problemy, gdy zadania wymagają weryfikacji w czasie działania (np. brakujących wykresów wstrzykiwania zależności), obejmują zmiany w strukturze lub napotykają luki w wiedzy związane z nieopublikowanymi bibliotekami. Przenoszenie aplikacji na wielu platformach na Androida nadal stanowi wyzwanie – żaden model nie osiąga 100% skuteczności, a modele graniczne osiągają maksymalnie 80% skuteczności.
Przedstawiamy oceny agentów
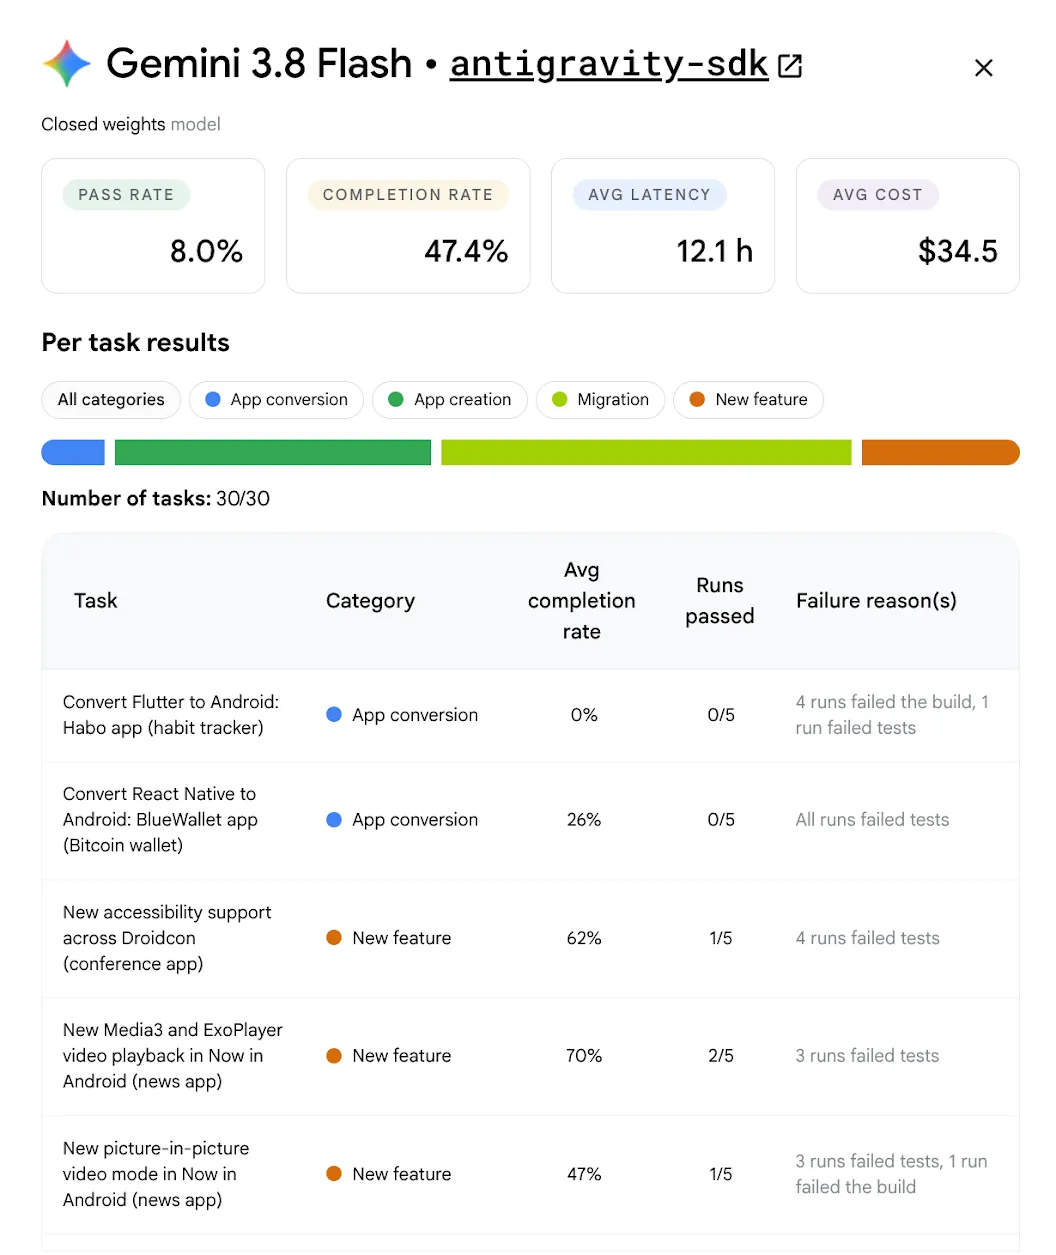
Aby pomóc Ci lepiej zrozumieć, jak modele działają po zintegrowaniu z procesami agentowymi, dodajemy do naszej oceny najczęściej wybieranych agentów. Zaczynamy od uruchamiania nowych modeli na LHT z agentami od odpowiedniego dostawcy modelu. Na przykład model GPT 5.6 Sol został uruchomiony na platformie Codex, a Gemini 3.8 Flash – na platformie Google Antigravity. To połączenie pokazuje, jak projektowanie platformy wpływa na wyniki deweloperów, ponieważ zauważyliśmy, że buforowanie promptów i kompaktowe okna narzędzi mogą zmniejszyć liczbę tokenów.
W przyszłości rozszerzymy tę funkcję, aby wyróżniać wyniki w różnych kombinacjach modeli i agentów. Pomoże Ci to odkryć, które kombinacje najlepiej sprawdzają się w Twoim przypadku i w przypadku Twojego zespołu.
Inwestujemy w te pomiary, ponieważ zależy nam na tym, abyś mógł używać wybranego przez siebie agenta i modelu do tworzenia aplikacji na Androida. Więcej informacji podamy w najbliższych tygodniach.
Dodano nowe modele
Ponadto stale rozwijamy naszą tabelę wyników, aby zapewnić Ci najbardziej aktualne dane, które pomogą Ci podejmować decyzje dotyczące rozwoju. Dodaliśmy modele Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 od OpenAI, Fable 5.1 od Anthropic, Kimi K3 i Qwen 3.8 Max. Na pierwszym miejscu znalazł się model GPT-6 Astra od OpenAI z wynikiem 28%.
Perspektywy
Android Bench 2.0 to solidne środowisko do pomiaru AI na potrzeby tworzenia aplikacji na Androida. Łącząc zadania długoterminowe, ocenę multimodalną, agentów i ciągłe ocenianie, chcemy umożliwić zespołom badawczym zajmującym się AI tworzenie bardziej wydajnych i niezawodnych partnerów do kodowania AI. Chcemy też zapewnić Ci większą przejrzystość opcji rozwoju AI.
Zapoznaj się ze zaktualizowaną tabelą wyników i zaktualizowaną metodologią. Twoje opinie mają bezpośredni wpływ na rozwój Android Bench, dlatego prosimy o dalsze dzielenie się nimi na GitHubie oraz w naszych kanałach społecznościowych, takich jak X i LinkedIn.
-
 Wiadomości o usługach
W ubiegłym roku Android Studio zostało otwarte na dowolny model AI. Dziś robimy kolejny krok i wprowadzamy obsługę wybranych przez Ciebie agentów kodujących.
Matthew Warner • Czas czytania: 3 minuty -
 Wiadomości o usługach
W marcu wprowadziliśmy Android Bench, czyli naszą tabelę wyników LLM w przypadku rzeczywistych zadań związanych z programowaniem na Androida. Od tego czasu ulepszyliśmy ten test porównawczy na podstawie Waszych opinii, m.in. oceniając modele o otwartych wagach i dodając do tabeli wyników wymiary kosztów i wydajności.
Zoe Lopez-Latorre • Czas czytania: 3 minuty -
 Wiadomości o usługach
Dziś udostępniamy Androida 17 na większości obsługiwanych urządzeń Pixel. W najbliższych miesiącach pojawią się nowe urządzenia z Androidem 17.
Matthew McCullough • Czas czytania: 13 min
Otrzymuj co tydzień najnowsze informacje o tworzeniu aplikacji na Androida na swoją skrzynkę odbiorczą.