早在 3 月,我们就推出了 Android Bench,这是我们的大语言模型排行榜,用于评估其在实际 Android 开发任务中的表现。我们的目标是提高 Android 开发中模型功能的透明度,并鼓励改进模型,以便为您提供更实用的 AI 选项,让您在日常工作流程中受益。此后,我们根据您的反馈意见对基准进行了改进,包括评估开放权重模型,以及在排行榜中添加费用和效率维度。
但 AI 功能在不断发展,衡量也需要跟上步伐。在 7 月版本中,我们采用了 Harbor 框架,其中包括用于评估模型的基准测试代理的更新版本。
除了更改评估方法之外,在此 7 月版本中,我们还向排行榜添加了 8 个新模型(Claude Fable 5、Claude Sonnet 5、Claude Opus 4.8、GLM 5.2、Kimi K2.7 Code、MiniMax M3、Qwen 3.7 Plus 和 Qwen 3.7 Max)。我们还为 Android 开发者社区的成员提供了参与基准测试的机会。
使用 Harbor 框架升级方法
在设计 Android Bench 时,我们以当时领先的行业标准为基础来制定方法。我们使用了通用基准测试代理 mini-swe-agent v1,并根据 Android 开发的细微差别对其进行了调整,以便为模型在常见 Android 开发任务中的能力提供基准衡量标准。
为了继续为您提供先进的评估,准确衡量最新模型在 Android 开发方面的能力,我们将基准标准化为 Harbor 框架。Harbor 定义了标准和集成,让任何人都可以轻松运行基准测试、评估其首选设置或分享结果,从而为您提供更高的透明度和可见性。
此次升级使我们能够更严格地评估模型及其功能,并且我们重新对所有模型运行了基准测试,以建立更新后的基准。这意味着评分会略有变化,但您仍然可以在我们网站上的归档文件中查看历史得分。
我们希望确保 Android Bench 对您有所帮助,因此会随着评估和行业的发展不断更新它。
新增 8 个模型,扩大排行榜
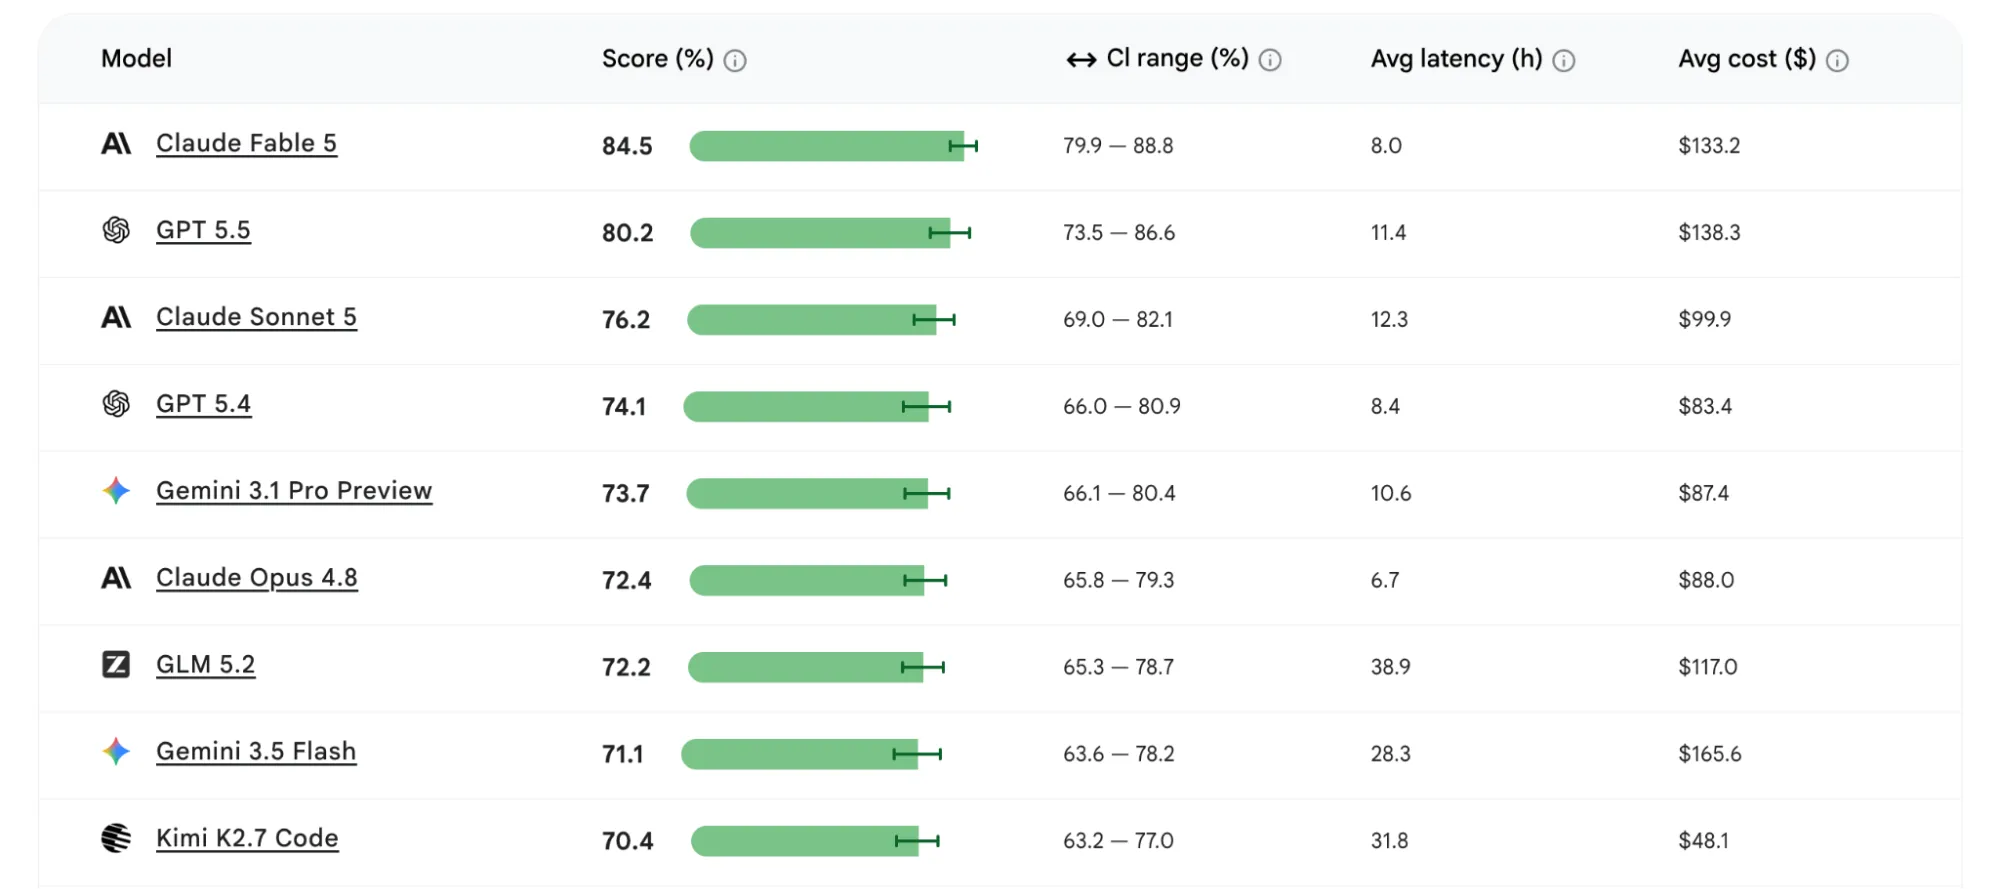
为了确保排行榜上的数据始终是最新的,我们已将 Claude Fable 5、Claude Sonnet 5、Claude Opus 4.8、GLM 5.2、Kimi K2.7 Code、MiniMax M3、Qwen 3.7 Plus 和 Qwen 3.7 Max 添加到 Android Bench 排行榜中。
您会看到,Claude Fable 5 以 84.5 分位居排行榜榜首,GPT 5.5 以 80.2 分紧随其后,Claude Sonnet 5 以 76.2 分位列第三。
如果仅比较开放权重模型,GLM 5.2 以 72.2 的得分位居榜首,其次是得分为 70.4 的 Kimi K2.7 Code。
您可以查看更新后的排行榜,了解这些新模型和旧模型在应对 Android 特有的挑战(例如 Jetpack Compose 迁移、穿戴式设备联网和平台 API 更新)方面的性能和效率指标。
向社区开放 Android Bench 贡献
从一开始,我们就非常重视开放透明的方法,因此我们在 GitHub 上公开提供了原始方法和测试框架。您一直希望我们提供一种方式来反馈数据集,因此现在我们更进一步,让 Android 开发者社区有机会参与 Android Bench 的开发。
从今天起,您可以通过以下两种方式为 Android Bench 做出贡献:
- 设计并提交您自己的 Android 开发任务,以评估模型在您关心的场景中的表现。
- 亲自运行并分享基准评估结果,根据我们的数据集或您自己的自定义任务测试您偏好的模型。
我们会审核提交的任务,并评估是否将其添加到基准中。我们希望打造一个真正反映全球 Android 开发者社区多样化日常现实的基准。
未来计划
随着智能体开发选项越来越多,保持领先的基准可确保您依赖的 AI 辅助功能不断变得更智能、更实用、更高效。前往我们的 GitHub 代码库查看任务。欢迎您向我们的团队提交任务以供审核,您还可以访问 Harbor Hub 来探索数据集或提交评估。
-
 产品资讯
现在,Android 上的无线调试比以往更快、更可靠,设置也更简单。在 ADB Wi-Fi 2.0 中,我们引入了新的服务器堆栈和更智能的网络处理,以直接解决开发者针对易用性差距提出的反馈。
Steven Jenkins, Sherif Eid, Fabien Sanglard • 阅读用时:1 分钟 -
 产品资讯
这是 Android Studio Quail 的最终稳定版。借助 Android Studio 中的新功能,您可以高效、有效地构建优质 AI 应用。
Amman Asfaw • 阅读用时:5 分钟 -
 产品资讯
维护健康的 Android 生态系统是一项共同的承诺,每款应用和游戏都应发挥自己的作用。
Raghavendra Hareesh Pottamsetty • 阅读用时:4 分钟
每周通过电子邮件接收最新的 Android 开发洞见。