El equipo de Android Runtime (ART) redujo el tiempo de compilación en un 18% sin comprometer el código compilado ni las regresiones de memoria máxima. Esta mejora formó parte de nuestra iniciativa de 2025 para mejorar el tiempo de compilación sin sacrificar el uso de memoria ni la calidad del código compilado.
Optimizar la velocidad del tiempo de compilación es fundamental para ART. Por ejemplo, cuando se realiza la compilación justo a tiempo (JIT), se afecta directamente la eficiencia de las aplicaciones y el rendimiento general del dispositivo. Las compilaciones más rápidas reducen el tiempo antes de que se apliquen las optimizaciones, lo que genera una experiencia del usuario más fluida y responsiva. Además, tanto para JIT como para la compilación anticipada (AOT), las mejoras en la velocidad del tiempo de compilación se traducen en un menor consumo de recursos durante el proceso de compilación, lo que beneficia la duración de la batería y la temperatura del dispositivo, en especial en los dispositivos de gama baja.
Algunas de estas mejoras de velocidad en el tiempo de compilación se lanzaron en la versión de Android de junio de 2025, y el resto estará disponible en la versión de Android de fin de año. Además, todos los usuarios de Android con versiones 12 y posteriores pueden recibir estas mejoras a través de las actualizaciones de Mainline.
Optimiza el compilador de optimización
Optimizar un compilador siempre implica hacer concesiones. No puedes obtener velocidad de forma gratuita; tienes que renunciar a algo. Nos propusimos un objetivo muy claro y desafiante: hacer que el compilador sea más rápido, pero sin introducir regresiones de memoria y, lo que es más importante, sin degradar la calidad del código que produce. Si el compilador es más rápido, pero las apps se ejecutan más lento, fallamos.
El único recurso que estábamos dispuestos a gastar era nuestro propio tiempo de desarrollo para profundizar, investigar y encontrar soluciones inteligentes que cumplieran con estos criterios estrictos. Analicemos más de cerca cómo trabajamos para encontrar áreas de mejora, así como las soluciones adecuadas para los diversos problemas.
Cómo encontrar optimizaciones posibles que valgan la pena
Antes de comenzar a optimizar una métrica, debes poder medirla. De lo contrario, nunca podrás saber con certeza si lo mejoraste o no. Por suerte, la velocidad del tiempo de compilación es bastante constante, siempre y cuando tomes algunas precauciones, como usar el mismo dispositivo que usas para medir antes y después de un cambio, y asegurarte de no limitar térmicamente el dispositivo. Además, también tenemos mediciones determinísticas, como las estadísticas del compilador, que nos ayudan a comprender lo que sucede de forma interna.
Como el recurso que sacrificábamos para estas mejoras era nuestro tiempo de desarrollo, queríamos poder iterar lo más rápido posible. Esto significa que tomamos un puñado de apps representativas (una combinación de apps propias, apps de terceros y el propio sistema operativo Android) para crear prototipos de soluciones. Luego, verificamos que la implementación final valiera la pena con pruebas manuales y automatizadas de forma generalizada.
Con ese conjunto de APKs seleccionados, activamos una compilación manual de forma local, obtenemos un perfil de la compilación y usamos pprof para visualizar dónde invertimos nuestro tiempo.
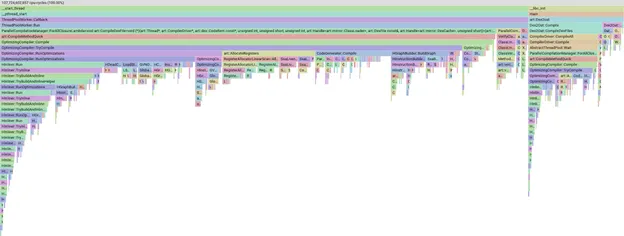
Ejemplo de un gráfico tipo llama de un perfil en pprof
La herramienta pprof es muy potente y nos permite segmentar, filtrar y ordenar los datos para ver, por ejemplo, qué fases o métodos del compilador tardan más tiempo. No entraremos en detalles sobre pprof; solo debes saber que, si la barra es más grande, significa que la compilación tardó más tiempo.
Una de estas vistas es la de “abajo hacia arriba”, en la que puedes ver qué métodos tardan más tiempo. En la siguiente imagen, podemos ver un método llamado Kill, que representa más del 1% del tiempo de compilación. Algunos de los otros métodos principales también se analizarán más adelante en la entrada de blog.
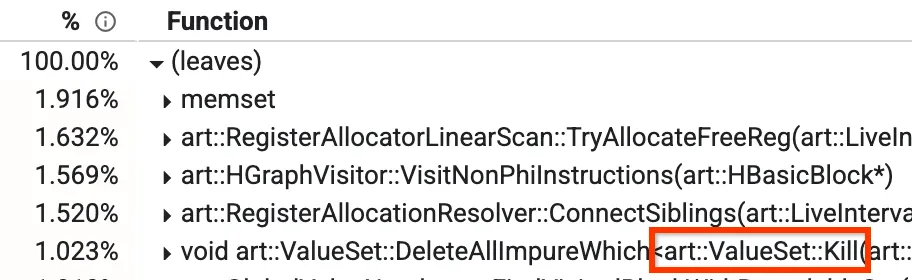
Vista de abajo hacia arriba de un perfil
En nuestro compilador de optimización, hay una fase llamada numeración de valores globales (GVN). No tienes que preocuparte por lo que hace en su totalidad, pero la parte relevante es saber que tiene un método llamado "Kill" que borrará algunos nodos según un filtro. Esto lleva mucho tiempo, ya que debe iterar por todos los nodos y verificar uno por uno. Notamos que hay algunos casos en los que sabemos de antemano que la verificación será falsa, sin importar los nodos que tengamos activos en ese momento. En estos casos, podemos omitir la iteración por completo, lo que reduce el porcentaje de 1.023% a ~0.3% y mejora el tiempo de ejecución de GVN en un ~15%.
Implementar optimizaciones que valgan la pena
Explicamos cómo medir y detectar dónde se invierte el tiempo, pero esto es solo el comienzo. El siguiente paso es optimizar el tiempo que se dedica a la compilación.
Por lo general, en un caso como el de "Kill" que se muestra arriba, analizaríamos cómo iteramos los nodos y lo haríamos más rápido, por ejemplo, realizando tareas en paralelo o mejorando el algoritmo en sí. De hecho, eso es lo que intentamos al principio y, solo cuando no pudimos encontrar nada que hacer, tuvimos un momento de "Espera un minuto…" y vimos que la solución era (en algunos casos) no iterar en absoluto. Cuando se realizan este tipo de optimizaciones, es fácil perder de vista el panorama general.
En otros casos, usamos algunas técnicas diferentes, como las siguientes:
- Usar heurística para decidir si una optimización no producirá resultados que valgan la pena y, por lo tanto, se puede omitir
- usar estructuras de datos adicionales para almacenar en caché los datos calculados
- cambiar las estructuras de datos actuales para aumentar la velocidad
- calcular los resultados de forma diferida para evitar ciclos en algunos casos
- Usa la abstracción correcta: las funciones innecesarias pueden ralentizar el código.
- evitar seguir un puntero de uso frecuente a través de muchas cargas
¿Cómo sabemos si vale la pena implementar las optimizaciones?
Esa es la mejor parte: no tienes que hacerlo. Después de detectar que un área consume mucho tiempo de compilación y de dedicar tiempo de desarrollo para intentar mejorarla, a veces no puedes encontrar una solución. Tal vez no haya nada que hacer, la implementación tardará demasiado, hará que otra métrica retroceda significativamente, aumentará la complejidad de la base de código, etc. Por cada optimización exitosa que puedas ver en esta entrada de blog, ten en cuenta que hay muchas otras que simplemente no se concretaron.
Si te encuentras en una situación similar, intenta estimar cuánto mejorarás la métrica con la menor cantidad de trabajo posible. Esto significa, en orden, lo siguiente:
- Estimar con una métrica que ya recopilaste o solo con una intuición
- Estimación con un prototipo rápido y básico
- Implementa una solución.
No olvides considerar estimar las desventajas de tu solución. Por ejemplo, si vas a depender de estructuras de datos adicionales, ¿cuánta memoria estás dispuesto a usar?
Sigue explorando
Sin más preámbulos, veamos algunos de los cambios que implementamos.
Implementamos un cambio para optimizar un método llamado FindReferenceInfoOf. Este método realizaba una búsqueda lineal de un vector para encontrar una entrada. Actualizamos esa estructura de datos para que se indexe por el ID de la instrucción, de modo que FindReferenceInfoOf sea O(1) en lugar de O(n). Además, preasignamos el vector para evitar cambiar el tamaño. Aumentamos un poco la memoria, ya que tuvimos que agregar un campo adicional que contaba cuántas entradas insertamos en el vector, pero fue un pequeño sacrificio, ya que la memoria máxima no aumentó. Esto aceleró nuestra fase de LoadStoreAnalysis en un 34% a 66%, lo que, a su vez, mejora el tiempo de compilación en un 0.5% a 1.8%.
Tenemos una implementación personalizada de HashSet que usamos en varios lugares. La creación de esta estructura de datos llevaba mucho tiempo y descubrimos por qué. Hace muchos años, esta estructura de datos se usaba solo en algunos lugares que usaban HashSets muy grandes y se modificó para optimizarla para eso. Sin embargo, hoy en día se usaba en la dirección opuesta con solo unas pocas entradas y con una vida útil corta. Esto significaba que estábamos desperdiciando ciclos creando este HashSet enorme, pero solo lo usábamos para unas pocas entradas antes de descartarlo. Con este cambio, mejoramos entre un 1.3% y un 2% del tiempo de compilación. Como beneficio adicional, el uso de memoria disminuyó entre un 0.5% y un 1%, ya que no usábamos estructuras de datos tan grandes como antes.
Mejoramos entre un 0.5% y un 1% del tiempo de compilación pasando estructuras de datos por referencia a la lambda para evitar copiarlas. Esto se pasó por alto en la revisión original y permaneció en nuestra base de código durante años. Gracias a que analizamos los perfiles en pprof, notamos que estos métodos creaban y destruían muchas estructuras de datos, lo que nos llevó a investigarlas y optimizarlas.
Aceleramos la fase que escribe el resultado compilado mediante el almacenamiento en caché de los valores calculados, lo que se tradujo en una mejora de entre el 1.3% y el 2.8% del tiempo de compilación total. Lamentablemente, la contabilidad adicional fue excesiva y nuestras pruebas automatizadas nos alertaron sobre la regresión de memoria. Más adelante, volvimos a revisar el mismo código y, luego, implementamos una versión nueva que no solo se encargó de la regresión de memoria, sino que también mejoró el tiempo de compilación en un 0.5% a 1.8% más. En este segundo cambio, tuvimos que refactorizar y reimaginar cómo debería funcionar esta fase para deshacernos de una de las dos estructuras de datos.
Tenemos una fase en nuestro compilador de optimización que intercala llamadas a funciones para obtener un mejor rendimiento. Para elegir qué métodos intercalar, usamos ambas heurísticas antes de realizar cualquier cálculo y, luego, hacemos verificaciones finales después de realizar el trabajo, pero justo antes de finalizar la intercalación. Si alguno de ellos detecta que no vale la pena intercalar (por ejemplo, si se agregarían demasiadas instrucciones nuevas), no intercalamos la llamada de método.
Movimos dos verificaciones de la categoría “verificaciones finales” a la categoría “heurística” para estimar si una inserción intercalada tendrá éxito o no antes de realizar cualquier cálculo que requiera mucho tiempo. Como se trata de una estimación, no es perfecta, pero verificamos que nuestra nueva heurística abarca el 99.9% de lo que se intercalaba antes sin afectar el rendimiento. Una de estas heurísticas nuevas se relacionaba con los registros DEX necesarios (mejora de ~0.2% a 1.3%), y la otra, con la cantidad de instrucciones (mejora de ~2%).
Tenemos una implementación personalizada de un BitVector que usamos en varios lugares. Reemplazamos la clase BitVector de tamaño variable por una BitVectorView más simple para ciertos vectores de bits de tamaño fijo. Esto elimina algunas indirecciones y verificaciones de rango en el tiempo de ejecución, y acelera la construcción de los objetos de vector de bits.
Además, la clase BitVectorView se convirtió en una plantilla en el tipo de almacenamiento subyacente (en lugar de usar siempre uint32_t como el antiguo BitVector). Esto permite que algunas operaciones, como Union(), procesen el doble de bits juntos en plataformas de 64 bits. Las muestras de las funciones afectadas se redujeron en más de un 1% en total cuando se compiló el SO Android. Esto se hizo a través de varios cambios [1, 2, 3, 4, 5, 6]
Si habláramos en detalle sobre todas las optimizaciones, estaríamos aquí todo el día. Si te interesan más optimizaciones, consulta algunos de los otros cambios que implementamos:
- Agrega contabilidad para mejorar los tiempos de compilación en un ~0.6% a 1.6%.
- Calcula los datos de forma diferida para evitar ciclos, si es posible.
- Refactorizar nuestro código para omitir el trabajo de procesamiento previo cuando no se usará
- Evita algunas cadenas de carga dependientes cuando el asignador se pueda obtener fácilmente de otros lugares.
- Otro caso de agregar una verificación para evitar trabajo innecesario.
- Evita la ramificación frecuente en el tipo de registro (núcleo/FP) en el asignador de registros.
- Asegúrate de que algunos arrays se inicialicen en el tiempo de compilación. No dependas de clang para hacerlo.
- Limpia algunos bucles. Usa bucles de rango que clang pueda optimizar mejor, ya que no necesita volver a cargar los punteros internos del contenedor debido a los efectos secundarios del bucle. Evita llamar a la función virtual `HInstruction::GetInputRecords()` en el bucle a través de la función intercalada `InputAt(.)` para cada entrada.
- Evita las funciones Accept() para el patrón de visitante aprovechando una optimización del compilador.
Conclusión
Nuestra dedicación para mejorar la velocidad del tiempo de compilación de ART generó mejoras significativas, lo que hace que Android sea más fluido y eficiente, y, al mismo tiempo, contribuye a mejorar la duración de la batería y la temperatura del dispositivo. Identificando e implementando optimizaciones con diligencia, demostramos que es posible obtener mejoras sustanciales en el tiempo de compilación sin comprometer el uso de memoria ni la calidad del código.
Nuestro recorrido incluyó la creación de perfiles con herramientas como pprof, la disposición a iterar y, a veces, incluso a abandonar las vías menos fructíferas. Los esfuerzos colectivos del equipo de ART no solo redujeron el tiempo de compilación en un porcentaje notable, sino que también sentaron las bases para futuros avances.
Todas estas mejoras están disponibles en la actualización de Android de fin de año de 2025 y para Android 12 y versiones posteriores a través de las actualizaciones de Mainline. Esperamos que este análisis detallado de nuestro proceso de optimización proporcione información valiosa sobre las complejidades y las recompensas de la ingeniería de compiladores.
-
 Novedades de productos
Las apps que se orienten a la próxima versión de Android ya no podrán escribir directamente en los contactos con el permiso WRITE_CONTACTS.
Roxanna Aliabadi Walker • Lectura de 6 min -
 Novedades de productos
A medida que se acelera el desarrollo basado en agentes, la ingeniería de Android alcanza una nueva y emocionante frontera: pasar de la finalización de código asistida a agentes que ejecutan tareas de extremo a extremo bajo tu dirección. Tienes total libertad y flexibilidad para elegir los modelos y agentes que usas.
Jason Buchel • Lectura de 3 min -
 Novedades de productos
Hoy, compartimos cómo estamos llevando nuestra visión de “más que una tienda” al siguiente nivel. Desde la pestaña Tú, que ahora es la base personal de más de 250 millones de usuarios activos por mes, hasta nuestra plataforma de juegos unificada que conecta a más de 700 millones de perfiles de gamer, Google Play llega a los usuarios dondequiera que estén.
Paul Feng • Lectura de 3 min
Recibe la información más reciente sobre el desarrollo de Android en tu bandeja de entrada todas las semanas.