ตั้งแต่ AGP 9.2.0 เป็นต้นไป R8 จะเพิ่มประสิทธิภาพการเรียกใช้ Atomic*FieldUpdater ส่วนใหญ่ให้เป็นตัวแปร Unsafe ซึ่งทำงานได้ดีกว่า 2-4 เท่าในการดำเนินการทั่วไป ซึ่งส่งผลกระทบอย่างมากต่อไลบรารี kotlinx.atomicfu ที่ใช้การดำเนินการแบบอะตอมสำหรับ kotlinx.coroutines ทำให้การเปิดและยกเลิกโครูทีนเร็วขึ้นสูงสุด 2 เท่า โปรดอัปเดต AGP เป็น 9.2.0 ขึ้นไปเพื่อรับสิทธิประโยชน์
เนื่องจากแอป Android ส่วนใหญ่ใช้ Kotlin เป็นภาษาหลัก kotlinx.coroutines จึงกลายเป็นมาตรฐานโดยพฤตินัยสำหรับการเขียนโปรแกรมแบบอะซิงโครนัส ไลบรารีนี้มีวิธีจัดการโฟลว์พร้อมกันที่ออกแบบและจัดโครงสร้างมาอย่างดีซึ่งเป็นของ Kotlin โดยเฉพาะ Jetpack Compose ก็เช่นกัน โดยใช้โครูทีนเพื่อจัดการเหตุการณ์ของเคอร์เซอร์ ภาพเคลื่อนไหว และการโต้ตอบอื่นๆ ในขณะที่เขียนนี้ API ที่ทำงานพร้อมกันส่วนใหญ่ใน Compose จะเรียกใช้ฟังก์ชัน suspend ภายใต้การทำงาน และจะเปิดใช้และ/หรือยกเลิกโครูทีนเพื่อจัดการการอัปเดต
เมื่อทีม Compose เริ่มตรวจสอบประสิทธิภาพ ก็พบว่าโครูทีนเป็นจุดคอขวดสำหรับการดำเนินการหลายอย่างที่เกิดขึ้นนอก Composition ตัวอย่างเช่น 80% ของเวลาที่ใช้ในการสร้างและอัปเดต Modifier.clickable หมดไปกับการเปิดและยกเลิกโครูทีนภายในที่จัดการการอัปเดต InteractionSource จากการสังเกตการณ์ดังกล่าว งานด้านประสิทธิภาพในช่วงแรกๆ จึงมุ่งเน้นไปที่การนำโครูทีนออกจากเส้นทางเริ่มต้นและชะลอการเริ่มต้นจนกว่าจะจำเป็น
ค่าใช้จ่ายของโครูทีน
วิธีที่ง่ายที่สุดในการวิเคราะห์ลักษณะการทำงานภายในของฟังก์ชันใน Android คือการบันทึกร่องรอยเมธอดของ Android Runtime (ART) ร่องรอยเมธอด ART เป็นเครื่องมือที่บันทึกลำดับการดำเนินการของแอป โดยจะแสดงเมธอดที่เรียกใช้ ลำดับ และระยะเวลาที่ใช้ในแต่ละเมธอดอย่างแม่นยำ เพื่อให้นักพัฒนาแอปสามารถระบุจุดคอขวดด้านประสิทธิภาพได้ สำหรับLaunchedEffect { }ที่ว่างเปล่า คำขอจะมีลักษณะดังนี้
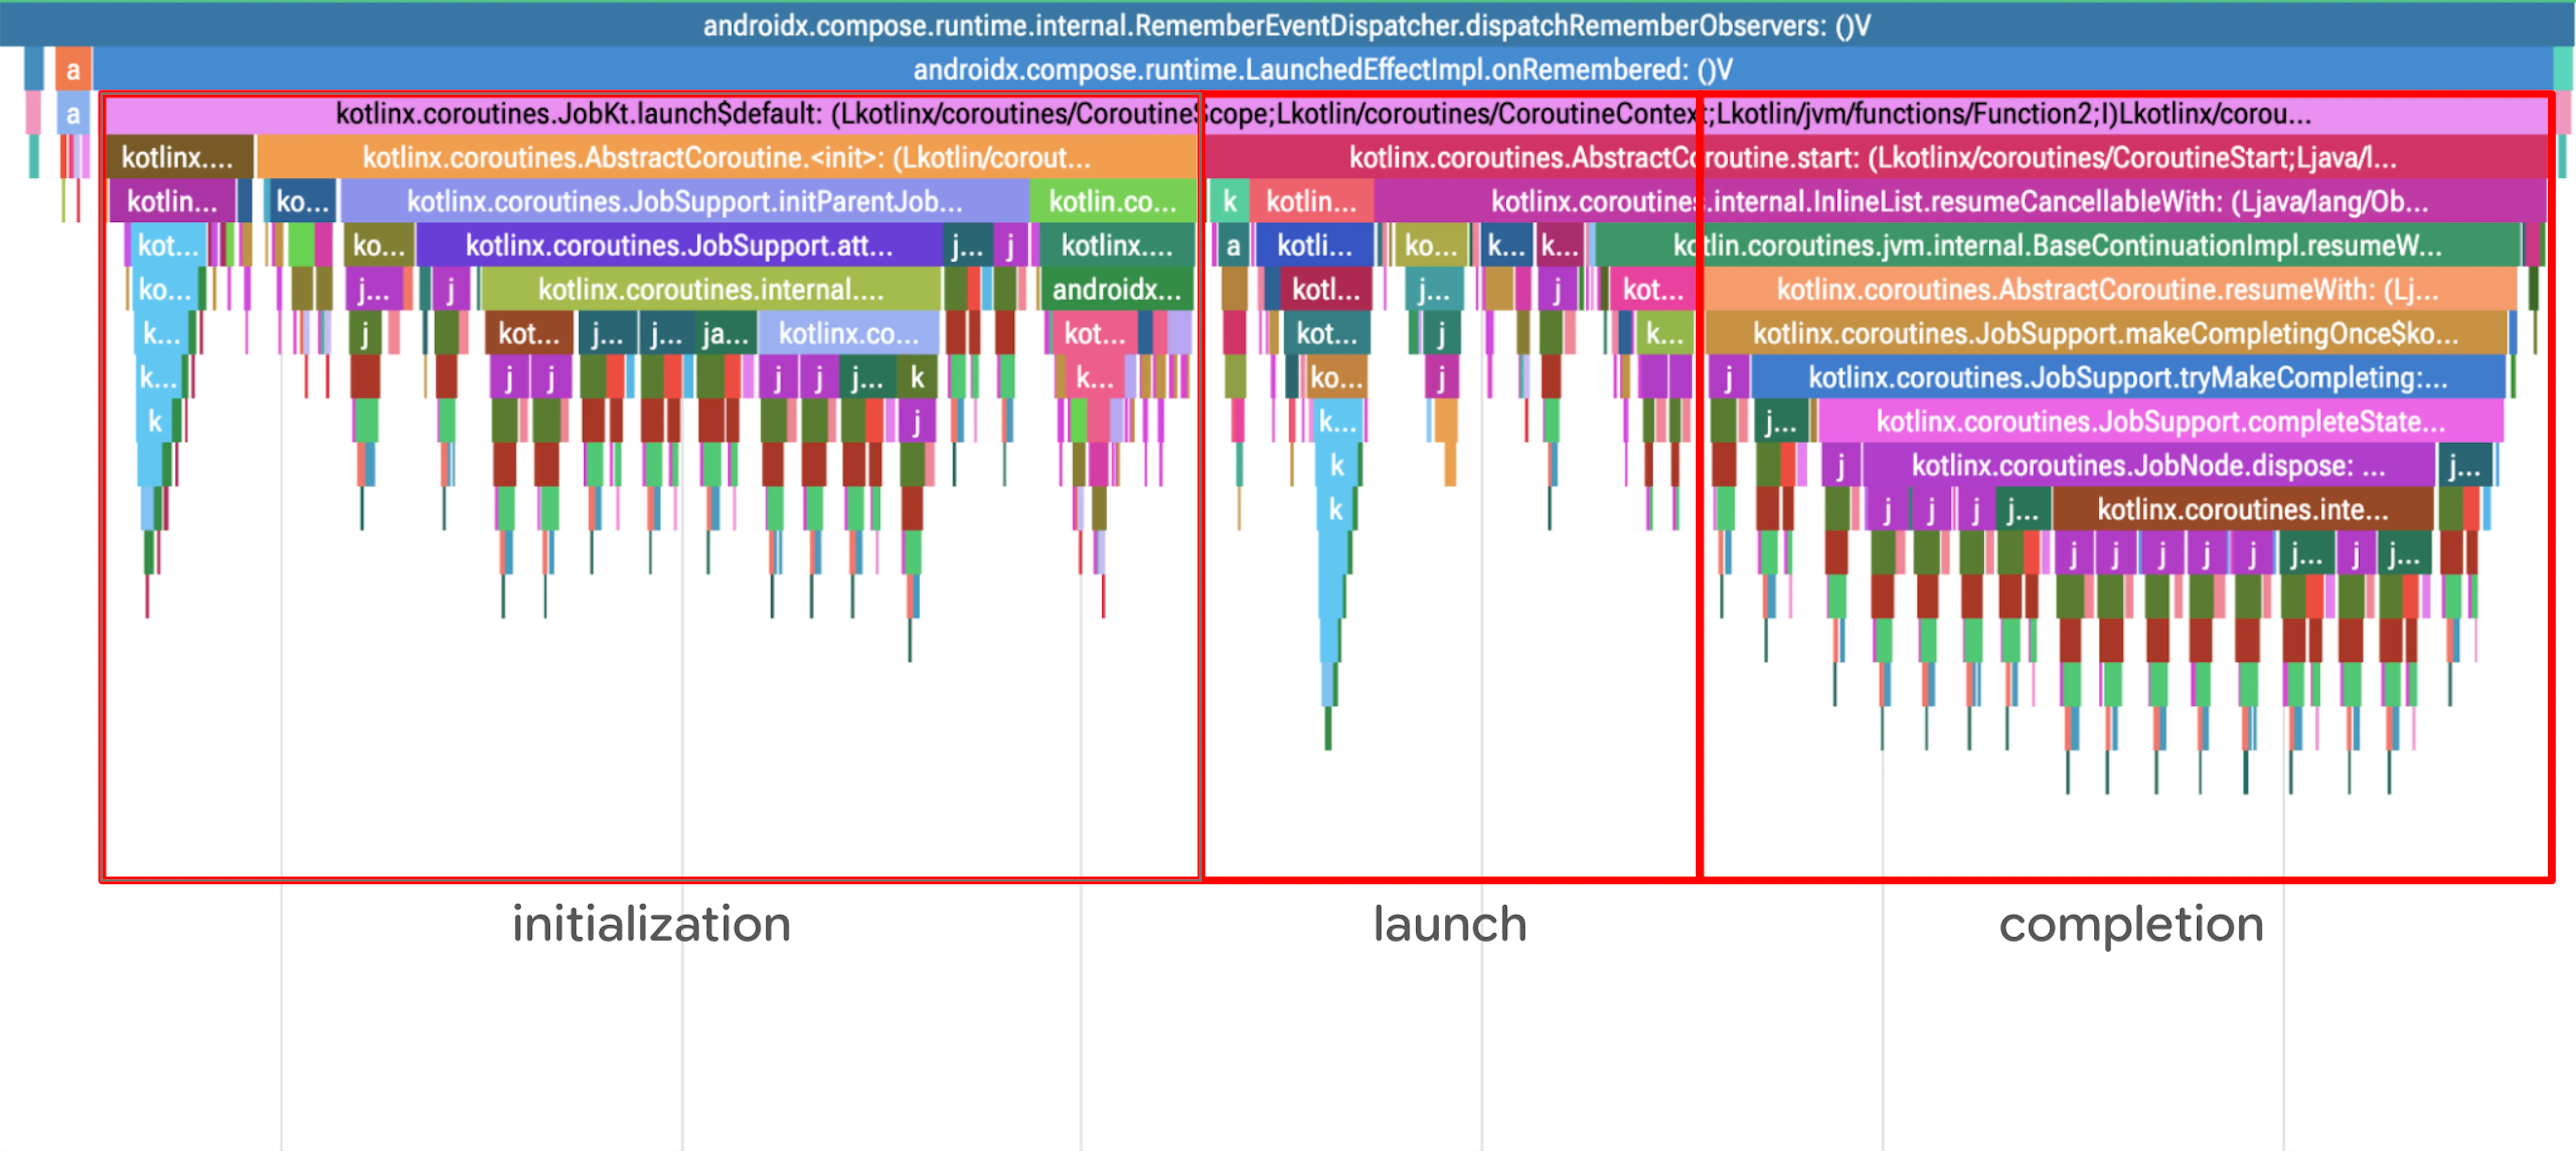
ร่องรอยเมธอดด้านบนสามารถแบ่งออกเป็น 3 ส่วนดังนี้
- การเริ่มต้นโครูทีนใหม่
- การเริ่มโครูทีน
- โครูทีนเสร็จสมบูรณ์ (เนื่องจากออกทันที)
การยกเลิก LaunchedEffect คล้ายกับการดำเนินการให้เสร็จสมบูรณ์ตามปกติ ยกเว้นว่าจะสร้าง CancellationException ด้วย
จากโปรไฟล์ด้านบน สิ่งหนึ่งที่น่าสงสัยทันทีคือการโทรไปยัง java.util.concurrent.AtomicReferenceFieldUpdater บ่อยครั้ง (กล่องสีม่วงหรือสีเขียวที่มีป้ายกำกับ j…) แม้ว่าการเรียกแต่ละครั้งจะค่อนข้างเร็ว แต่ความถี่ก็เป็นเรื่องที่น่ากังวล เนื่องจากค่าใช้จ่ายที่ไม่ควรมองข้ามซึ่งกระจายอยู่ในการเรียกใช้หลายครั้งอาจส่งผลให้เกิดการถดถอยที่เห็นได้ชัด การซูมเข้าในการโทรเผยให้เห็นว่าเวลาส่วนใหญ่ใช้ไปกับการตรวจสอบภาพสะท้อน
โครูทีนใช้โครงสร้างแบบต้นไม้ที่ไม่มีการล็อกสำหรับความสัมพันธ์หลัก-ย่อย ซึ่งทำให้การทำงานพร้อมกันแบบมีโครงสร้างเป็นไปได้ ปรากฏว่า kotlinx.atomicfuไลบรารีใช้การดำเนินการแบบอะตอมที่ไม่มีการล็อกโดยใช้ JVM Primitive ที่รู้จักกันดีอย่าง AtomicReferenceFieldUpdater โปรแกรมอัปเดตใช้การอ้างอิงคลาสและชื่อฟิลด์เพื่อดำเนินการแบบอะตอมในรันไทม์ และต้องเรียกใช้การตรวจสอบความปลอดภัยแบบรีเฟลกทีฟหลายครั้งเพื่อให้แน่ใจว่ามีฟิลด์และเข้าถึงได้ การดำเนินการแต่ละอย่างในโครูทีน (เริ่มต้น ระงับ ยกเลิก เสร็จสมบูรณ์) จะเรียกใช้การดำเนินการแบบอะตอมอย่างน้อย 1 รายการ ดังนั้นหากการดำเนินการช้า โครูทีนก็จะทำงานได้ไม่ดี
การตรวจสอบ AtomicReferenceFieldUpdater
แต่เรามาดูกันทีละขั้น AtomicReferenceFieldUpdater ได้รับการเพิ่มประสิทธิภาพอย่างดีใน JVM มานานกว่า 10 ปีแล้ว และการติดตามเมธอดอาจบันทึกค่าใช้จ่ายที่ VM ระดับการเพิ่มประสิทธิภาพได้นำออกไปโดยสมบูรณ์ นั่นคือการคอมไพล์แบบ Just-In-Time (JIT) หรือ Ahead-Of-Time (AOT) มาเขียนการเปรียบเทียบ 2-3 รายการเพื่อวัดความแตกต่างระหว่างการอ้างอิงแบบอะตอมจาก kotlinx.atomicfu กับ java.util.concurrent.atomic เพื่อยืนยันประสิทธิภาพกัน
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
การเรียกใช้การทดสอบประสิทธิภาพนี้ใน Pixel 5 (ขณะที่ตรวจสอบว่า AtomicReferenceFieldUpdater#compareAndSet ได้รับการคอมไพล์ JIT ในระหว่างการวอร์มอัป) จะให้ผลลัพธ์ต่อไปนี้ใน Pixel 5 (API 33)
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
การวัดผลยืนยันถึงความแตกต่าง โดยkotlinx.atomicfu ช้ากว่าประมาณ 2.7 เท่าอย่างชัดเจน ซึ่งยืนยันว่า ART ไม่ได้ทำการเพิ่มประสิทธิภาพที่ซ่อนอยู่ และการตรวจสอบการเข้าถึงแบบรีเฟลกทีฟจะเพิ่มค่าใช้จ่ายจริงในระหว่างรันไทม์
เมื่อย้อนกลับไปดูร่องรอยเมธอดเดิม งานที่มีความหมายเพียงอย่างเดียวที่ AtomicReferenceFieldUpdater ดำเนินการคือการเรียกภายในไปยัง Unsafe.getObjectVolatile ซึ่งจะดำเนินการการดำเนินการระดับย่อยพื้นฐานจริงๆ ในกรณีส่วนใหญ่ ตัวเริ่มต้นโปรแกรมอัปเดตจะเป็นแบบคงที่ และพิสูจน์ได้ว่าถูกต้องเสมอตามโครงสร้างของคลาสโดยรอบ ดังนั้นจึงสามารถวิเคราะห์การใช้งาน AtomicReferenceFieldUpdater ส่วนใหญ่แบบคงที่และแทนที่ด้วยตัวแปร Unsafe ภายในระหว่างการคอมไพล์ นอกจากนี้ Toolchain ของเครื่องมือบิลด์ Android ยังมีคอมไพเลอร์เพิ่มประสิทธิภาพของตัวเองที่ทำสิ่งนี้ได้
การเพิ่มประสิทธิภาพด้วย R8
Atomic*FieldUpdater คลาสรองรับการใช้งานที่ละเอียดอ่อน ไดนามิก และอิงตามการสะท้อน แต่ก็มักใช้ในรูปแบบที่เห็นได้ชัดแบบคงที่ ซึ่งอธิบายได้ทั้งประสิทธิภาพพื้นฐานที่ช้าและการต้องการเพิ่มประสิทธิภาพ R8 เป็นคอมไพเลอร์ที่เพิ่มประสิทธิภาพโปรแกรมทั้งหมดและเหมาะอย่างยิ่งที่จะใช้ดูรูปแบบที่ง่ายกว่าเพื่อลดค่าใช้จ่ายในการตรวจสอบความปลอดภัยแบบรีเฟลกทีฟ R8 จะรับ JVM bytecode หลังจากคอมไพเลอร์ Java หรือ Kotlin แต่เพื่อให้ง่ายต่อการอ่าน ตัวอย่างเหล่านี้จึงแสดงในไวยากรณ์ Java ด้วยเหตุนี้จึงไม่มีอาร์กิวเมนต์ประเภทสำหรับ AtomicReferenceFieldUpdater
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
ตัวอย่างพื้นฐานจะสร้างโปรแกรมอัปเดตสุดท้ายแบบคงที่ซึ่งเข้าถึงฟิลด์ที่เปลี่ยนแปลงได้ด้วยอาร์กิวเมนต์ค่าคงที่แบบง่ายสำหรับผู้ถือ ประเภท และชื่อของฟิลด์ การสะท้อนแสงที่ใช้มีความโปร่งใสโดยสิ้นเชิง คุณจะเห็นได้ชัดเจนว่าโปรแกรมอัปเดตนี้อ้างอิงฟิลด์ที่ถูกต้อง และเว็บไซต์ที่สร้างโปรแกรมอัปเดตมีสิทธิ์เข้าถึงฟิลด์ดังกล่าว
โดยพื้นฐานแล้ว Atomic*FieldUpdater คือ Wrapper รอบออฟเซ็ตฟิลด์และการเรียกใช้ Unsafe กรณีที่ดีที่สุดสำหรับการเพิ่มประสิทธิภาพคือการแทนที่ฟิลด์โปรแกรมอัปเดตด้วยฟิลด์ออฟเซ็ต และแทนที่การเรียกโปรแกรมอัปเดตด้วยการเรียก Unsafe
การเพิ่มประสิทธิภาพ Atomic*FieldUpdater
การเพิ่มประสิทธิภาพจะดำเนินการใน 3 ส่วน ได้แก่ การวัดผล การแทนที่ และการล้างข้อมูล
การใช้เครื่องมือ
ขั้นตอนแรกคือการแนะนำฟิลด์ออฟเซ็ตควบคู่ไปกับฟิลด์ตัวอัปเดตเพื่ออำนวยความสะดวกในการเข้าถึงโดยตรงผ่านUnsafe การเรียก
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
โดยจะเข้าถึงฟิลด์ผ่านการสะท้อน และใช้ Unsafe เพื่อดึงข้อมูลออฟเซ็ตของฟิลด์ในคลาส โค้ดนี้แสดงโครงสร้างภายในของ Atomic*FieldUpdater หากคุณไม่สนใจการตรวจสอบการสะท้อน แต่ระบบจะติดตามประเภทตัวยึดของโปรแกรมอัปเดตและประเภทฟิลด์ของฟิลด์ที่เปลี่ยนแปลงได้แบบคงที่ในคอมไพเลอร์
โปรดทราบว่าระบบจะปล่อยให้ฟิลด์เดิมและการเริ่มต้นของฟิลด์เป็นไปตามเดิม กระบวนการเพิ่มประสิทธิภาพจะช่วยอำนวยความสะดวกและเพิ่มประสิทธิภาพการใช้งานอย่างเต็มที่ แล้วจึงล้างข้อมูลในภายหลัง วิธีนี้เป็นแนวทางที่เรียบง่ายในการติดตั้งใช้งาน แต่ก็ยังช่วยให้เพิ่มประสิทธิภาพฟิลด์ของโปรแกรมอัปเดตได้บางส่วน โดยจะปล่อยให้การใช้งานบางอย่างเป็นไปตามเดิมในขณะที่เพิ่มประสิทธิภาพการใช้งานอื่นๆ
การแทนที่
ในจุดนี้ในคอมไพเลอร์ หลังจากจุดรวมการทำงานพร้อมกันที่เหมาะสม เราจะมีรายการฟิลด์ตัวอัปเดตที่วัดผล ซึ่งหมายความว่าเราสามารถเพิ่มประสิทธิภาพเว็บไซต์ที่โทรแต่ละแห่งได้ทีละแห่งตามเงื่อนไข 2-3 ข้อ ลองดูตัวอย่างการเรียกใช้
updater.compareAndSet(holder, expectedValue, newValue);
เงื่อนไขที่ Atomic*FieldUpdater กำหนดมีดังนี้
updaterมาจากฟิลด์ที่วัดค่าใช่ไหม กล่าวคือ การวิเคราะห์แบบคงที่สามารถติดตามค่าของออบเจ็กต์กลับไปยังการอ่านฟิลด์ของเครื่องมืออัปเดตได้หรือไม่holderเป็นคลาสเดียวกันหรือเป็นคลาสย่อยของประเภทผู้ถือที่กำหนดไว้เดิมnewValueเป็นคลาสเดียวกันหรือเป็นคลาสย่อยของประเภทฟิลด์ที่กำหนดไว้เดิม
หากเป็นไปตามเงื่อนไขทั้งหมด ระบบจะแทนที่การเรียกด้วยการเรียกไปยัง Unsafe โดยไม่มีการตรวจสอบการสะท้อน
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
การเรียกใหม่นี้รวดเร็วและง่ายกว่า แต่แตกต่างจากการเรียกเดิมในเรื่องการจัดการค่า Null ใน updater และ holder ระบบจะแทรกการตรวจสอบค่า Null สำหรับทั้ง 2 รายการ เว้นแต่จะมีการยกเว้นแบบคงที่
การจัดระเบียบ
ในตอนนี้ คลาสที่ถือครองจะมีฟิลด์ Updater เดิมและฟิลด์ออฟเซ็ตใหม่ พร้อมด้วยตำแหน่งการเรียกใช้ที่อาจใช้ฟิลด์ใดฟิลด์หนึ่ง หากไม่ได้เพิ่มประสิทธิภาพเว็บไซต์ที่โทร ระบบควรนำช่องออฟเซ็ตออก และหากเพิ่มประสิทธิภาพเว็บไซต์ที่โทรทั้งหมดแล้ว ระบบควรนำช่องอัปเดตเตอร์ออก ในทั้ง 2 กรณี คุณควรลบการเรียกใช้การเริ่มต้นด้วย การลบฟิลด์ที่ไม่ได้ใช้และการนำโค้ดที่ไม่ได้ใช้งานออกได้ดำเนินการในคอมไพเลอร์แล้ว แต่การนำโค้ดการเริ่มต้นออกที่นี่ต้องใช้เทคนิคเพิ่มเติมอีกเล็กน้อย
ทั้งการเรียกใช้ newUpdater และ getDeclaredField อาจมีผลข้างเคียงเนื่องจากอาจทำให้เกิดข้อยกเว้น (และเราไม่ทราบการใช้งานเนื่องจากขึ้นอยู่กับเวอร์ชัน API) ซึ่งหมายความว่าการเพิ่มประสิทธิภาพทั่วไปจะนำออกอย่างปลอดภัยไม่ได้ ดังนั้นการล้างข้อมูลนี้จึงต้องพิจารณาฟิลด์ที่ใช้เครื่องมืออย่างชัดเจน เนื่องจากฟิลด์เหล่านั้นทราบกันดีว่าไม่มีข้อยกเว้น
ในตอนท้าย ตัวอย่างโปรแกรมอัปเดตอย่างง่ายที่แสดงด้านบนจะมีลักษณะดังนี้หลังจากการเพิ่มประสิทธิภาพ
ผลลัพธ์
หลังจากการเพิ่มประสิทธิภาพเหล่านี้ kotlinx.atomicfu และการใช้ AtomicInt/Long/ReferenceFieldUpdater อย่างชัดเจนส่วนใหญ่จะตรงกับประสิทธิภาพ AtomicReference เมื่อใช้ R8 ในความเป็นจริงแล้ว kotlinx.atomicfu ยังเร็วกว่าในเกณฑ์มาตรฐานบางอย่างด้วย โดยมีปลั๊กอินคอมไพเลอร์ที่สามารถแทรกอินสแตนซ์ atomic ลงในฟิลด์ได้ ซึ่งจะช่วยลดการจัดสรรที่จำเป็นในการสร้างฟิลด์ที่อัปเดตแบบอะตอม
Jetpack Compose เป็นผู้รับประโยชน์หลักจากงานนี้ รันไทม์ของ Compose มีการทดสอบประสิทธิภาพระดับไมโครหลายรายการที่ติดตามประสิทธิภาพของโครูทีนอย่างใกล้ชิดเพื่อตรวจหาการถดถอยของประสิทธิภาพตั้งแต่เนิ่นๆ เมื่ออัปเดตการเปรียบเทียบเป็น R8 เวอร์ชันใหม่ เราพบว่าประสิทธิภาพดีขึ้น 2 เท่าเมื่อเปิดและยกเลิกโครูทีนใน LaunchedEffect
นอกจากนี้ ทีม ART ยังใช้การเพิ่มประสิทธิภาพเหล่านี้ในระดับ VM โดยตรง หากแอปกำหนดเป้าหมายเป็น API 36 และทำงานบน Android เวอร์ชันล่าสุด อุปกรณ์อาจเพิ่มประสิทธิภาพโครูทีนในลักษณะที่คล้ายกันอยู่แล้ว การทดสอบประสิทธิภาพของโครูทีนข้างต้นพบว่าประสิทธิภาพดีขึ้นประมาณ 15% หลังจากอัปเดต JIT ใน ART เวอร์ชันล่าสุด
แอปจะได้รับการเพิ่มประสิทธิภาพนี้โดยค่าเริ่มต้นเมื่ออัปเกรดเป็น AGP 9.2.0 หรือใช้ R8 9.2.0 โดยตรง ดูข้อมูลเพิ่มเติมได้ที่D8 dexer และ R8 shrinker
-
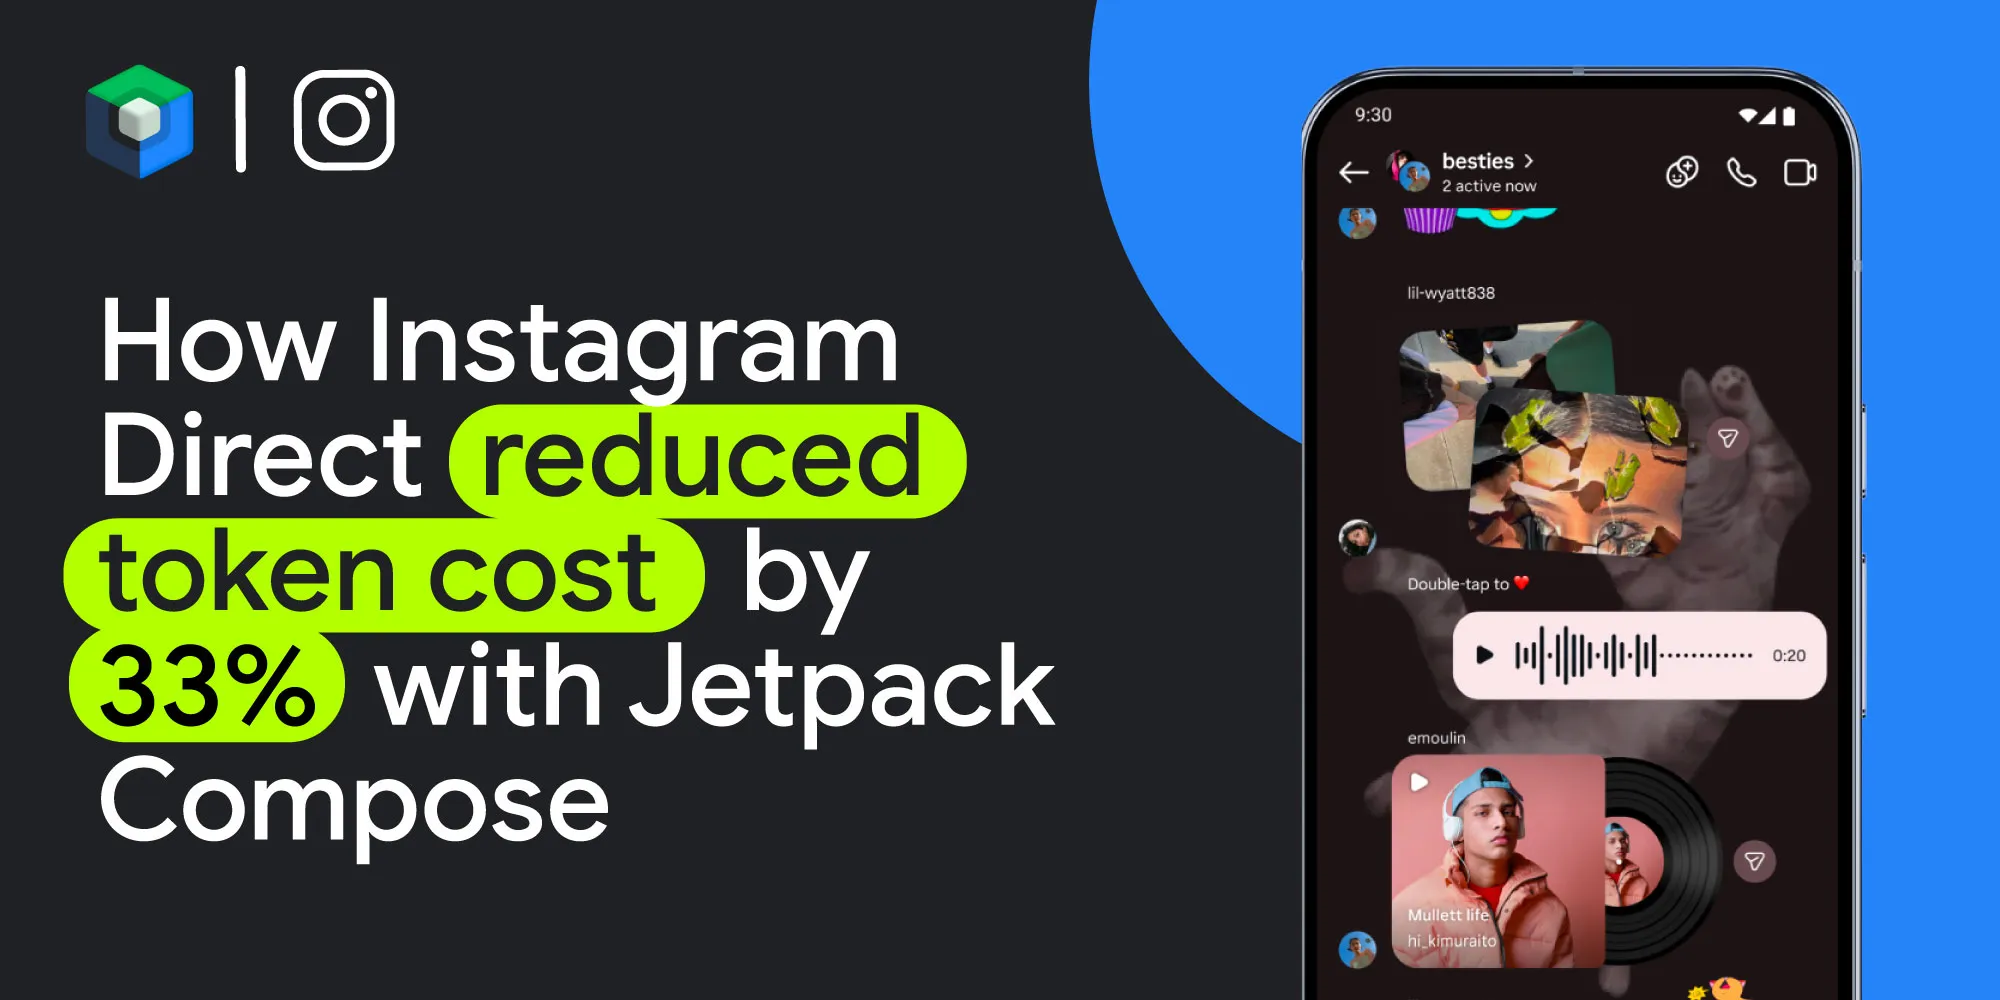 กรณีศึกษา
ทีมได้สร้างฐานของโค้ด UI ที่สร้างขึ้นโดยใช้ AI ซึ่งมีขนาดเล็กกว่าการติดตั้งใช้งานเดิม 50% ขณะเดียวกันก็ลดเวลาการทำงานของ AI Agent ได้ 35% ลดการแลกเปลี่ยนระหว่างวิศวกรกับ Agent ได้ 32% และลดต้นทุนโทเค็นได้ 33%
Pavlo Stavytskyi, Rebecca Franks • อ่าน 11 นาที -
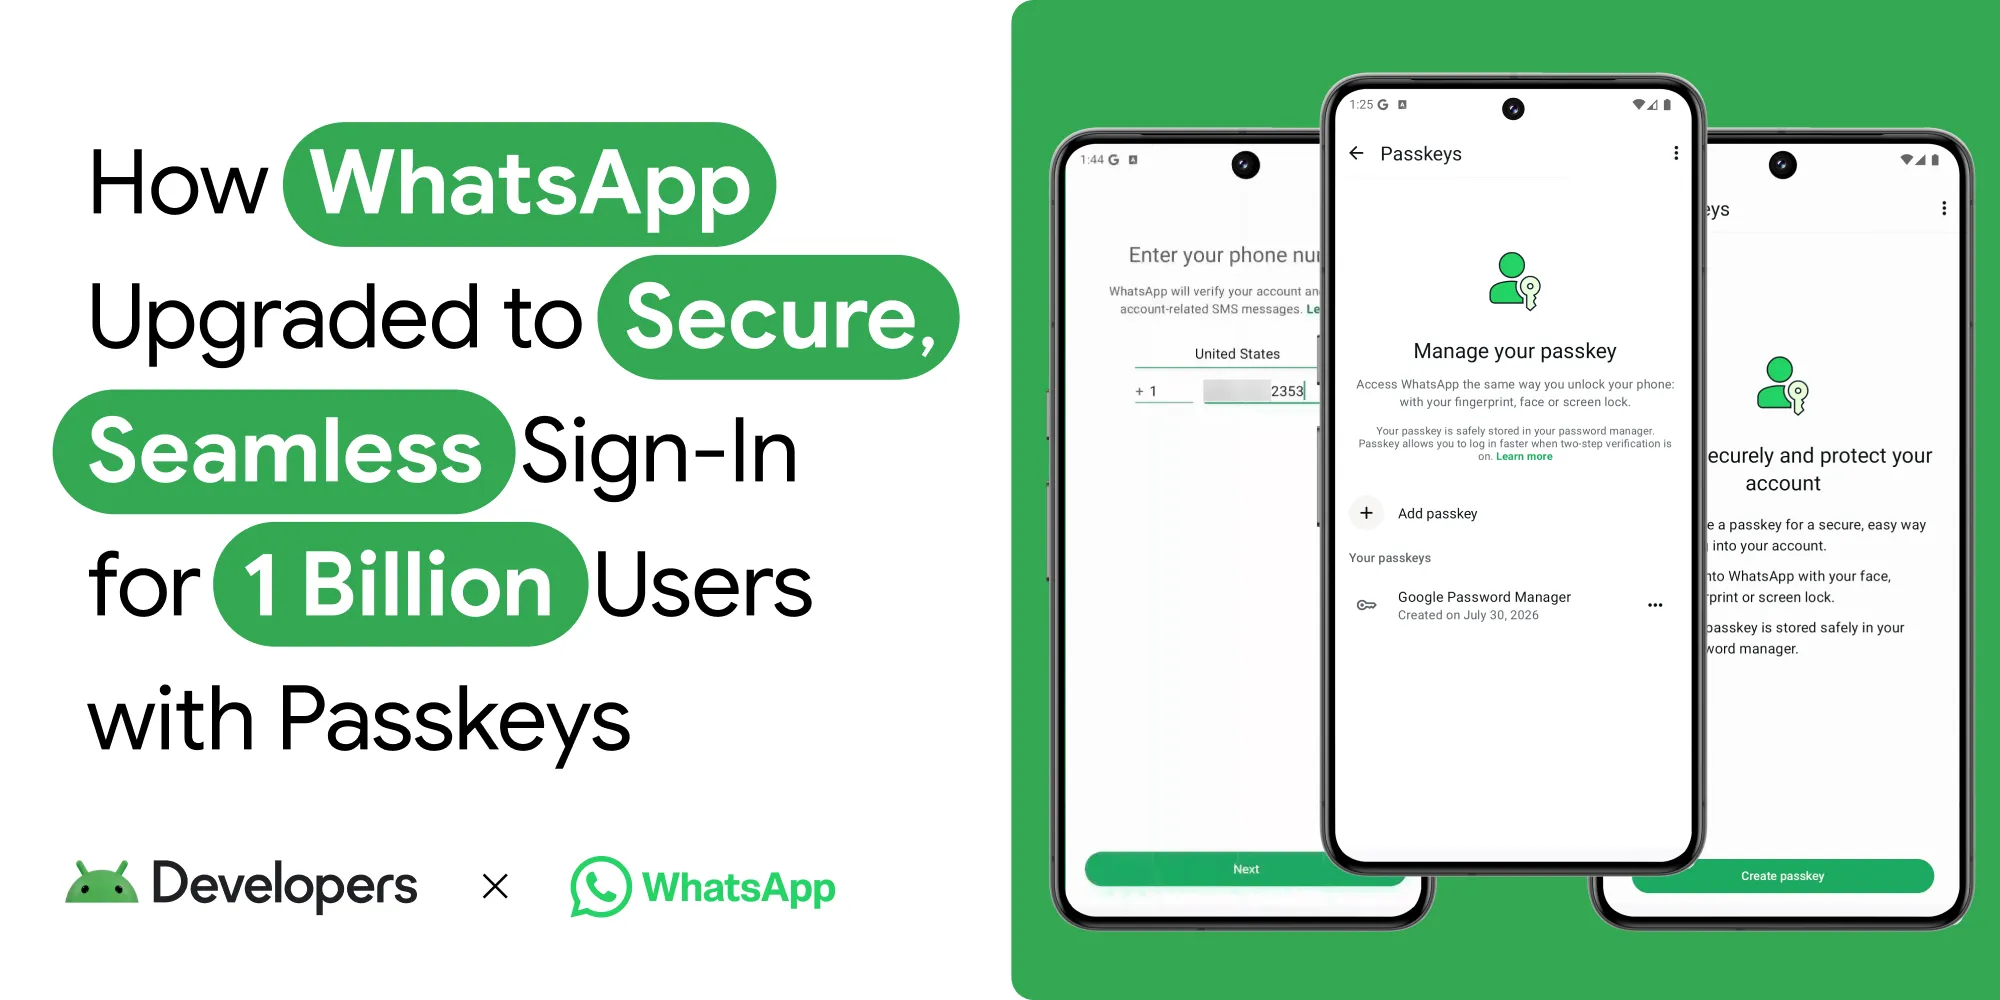 กรณีศึกษา
WhatsApp เป็นแพลตฟอร์มการรับส่งข้อความที่ใหญ่ที่สุดในโลก โดยให้บริการแก่ผู้ใช้หลายพันล้านคนทั่วโลก โดยเป็นเครื่องมือสื่อสารเริ่มต้นสำหรับผู้คนในภูมิภาคต่างๆ ซึ่งเชื่อมต่อผู้ใช้ผ่านการรับส่งข้อความส่วนตัวที่เชื่อถือได้และปลอดภัย
Niharika Arora, Tracy Agyemang, Mayank Jain • ใช้เวลาอ่าน 8 นาที -
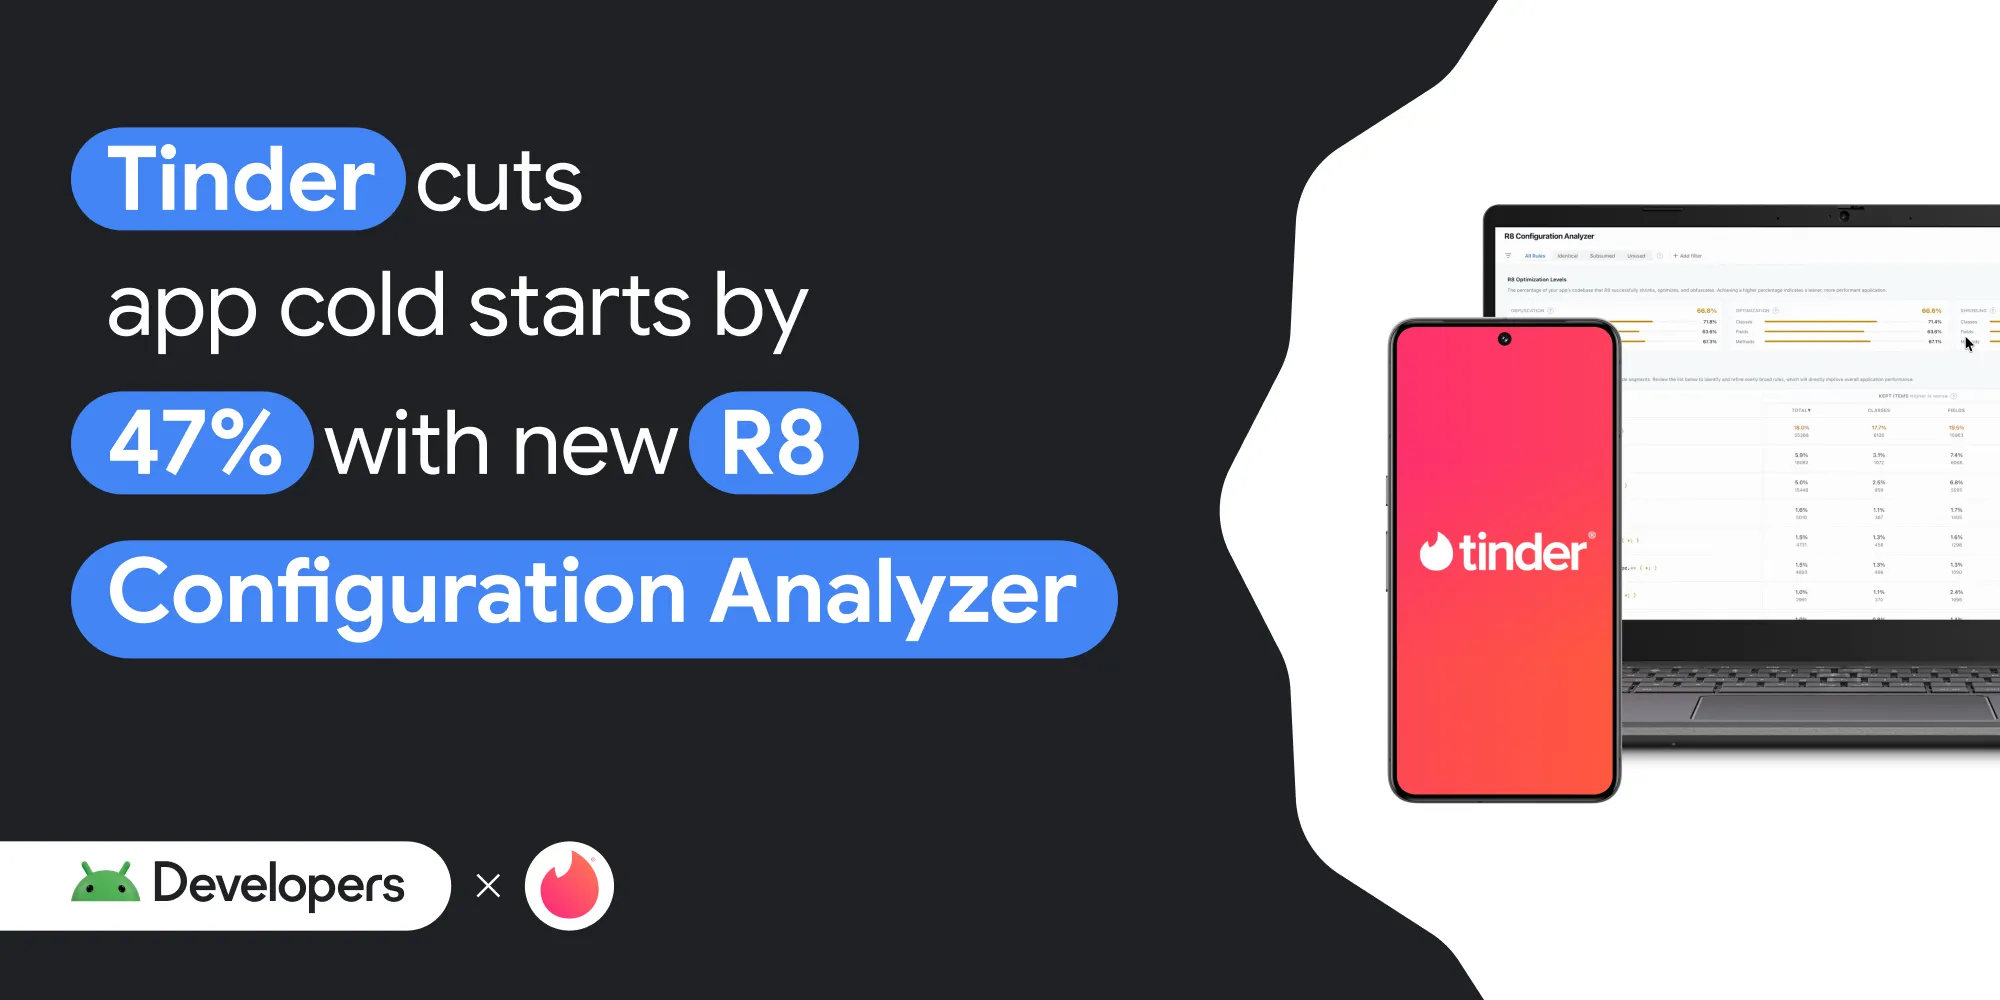 กรณีศึกษา
Tinder มีพันธกิจในการเสริมสร้างและสร้างแรงบันดาลใจให้เกิดความสัมพันธ์ที่แท้จริงด้วยการทำให้การพบปะเป็นเรื่องง่ายและสนุกสำหรับคนโสดรุ่นใหม่ทุกคน
Ajesh Pai, Ulises Uriel Verduzco Díaz , Tracy Agyemang • อ่าน 4 นาที
รับข้อมูลเชิงลึกด้านการพัฒนา Android ล่าสุดส่งตรงถึงกล่องจดหมายของคุณทุกสัปดาห์