Wie R8 Kotlin-Koroutinen unter Android doppelt so schnell gemacht hat
Lesezeit: 7 Minuten
Ab AGP 9.2.0 optimiert R8 die meisten Atomic*FieldUpdater-Aufrufe in Unsafe-Varianten, die bei gängigen Vorgängen zwei- bis viermal besser abschneiden. Dies hat besonders große Auswirkungen auf die kotlinx.atomicfu-Bibliothek, die Atomics für kotlinx.coroutines implementiert. Dadurch können Coroutinen bis zu zweimal schneller gestartet und abgebrochen werden. Wenn Sie diese Vorteile nutzen möchten, aktualisieren Sie Ihr AGP auf Version 9.2.0 oder höher.
Da die meisten Android-Apps Kotlin als Hauptsprache verwenden, ist kotlinx.coroutines zum De-facto-Standard für die asynchrone Programmierung geworden. Die Bibliothek bietet eine gut konzipierte und strukturierte Möglichkeit, gleichzeitige Abläufe zu verwalten, die nativ in Kotlin sind. Jetpack Compose ist da keine Ausnahme. Hier werden Koroutinen für die Verwaltung von Zeigerereignissen, Animationen und anderen Interaktionen verwendet. Zum Zeitpunkt der Erstellung dieses Artikels rufen die meisten gleichzeitigen APIs in Compose im Hintergrund suspend-Funktionen auf und starten und/oder brechen Koroutinen ab, um Aktualisierungen zu verarbeiten.
Als das Compose-Team die Leistung untersuchte, stellte sich heraus, dass Koroutinen ein Engpass für viele Vorgänge sind, die außerhalb der Komposition stattfinden. Beispielsweise wurden 80% der Zeit, die für das Erstellen und Aktualisieren von Modifier.clickable aufgewendet wurde, für das Starten und Abbrechen interner Koroutinen verwendet, die InteractionSource-Aktualisierungen verarbeiteten. Auf Grundlage dieser Beobachtungen konzentrierte sich ein Großteil der frühen Leistungsarbeit darauf, Coroutinen aus dem Standardpfad zu entfernen und die Initialisierung so lange wie möglich zu verzögern.
Die Kosten einer Koroutine
Am einfachsten lässt sich das interne Verhalten einer Funktion unter Android analysieren, indem ein Methoden-Trace der Android Runtime (ART) erfasst wird. Ein ART-Methoden-Trace ist ein Tool, das den Ausführungsablauf einer App aufzeichnet. Es zeigt genau, welche Methoden aufgerufen werden, in welcher Reihenfolge und wie viel Zeit für jede Methode aufgewendet wird. So können Entwickler Leistungsengpässe identifizieren. Für einen leeren LaunchedEffect { }-Aufruf würde das in etwa so aussehen:
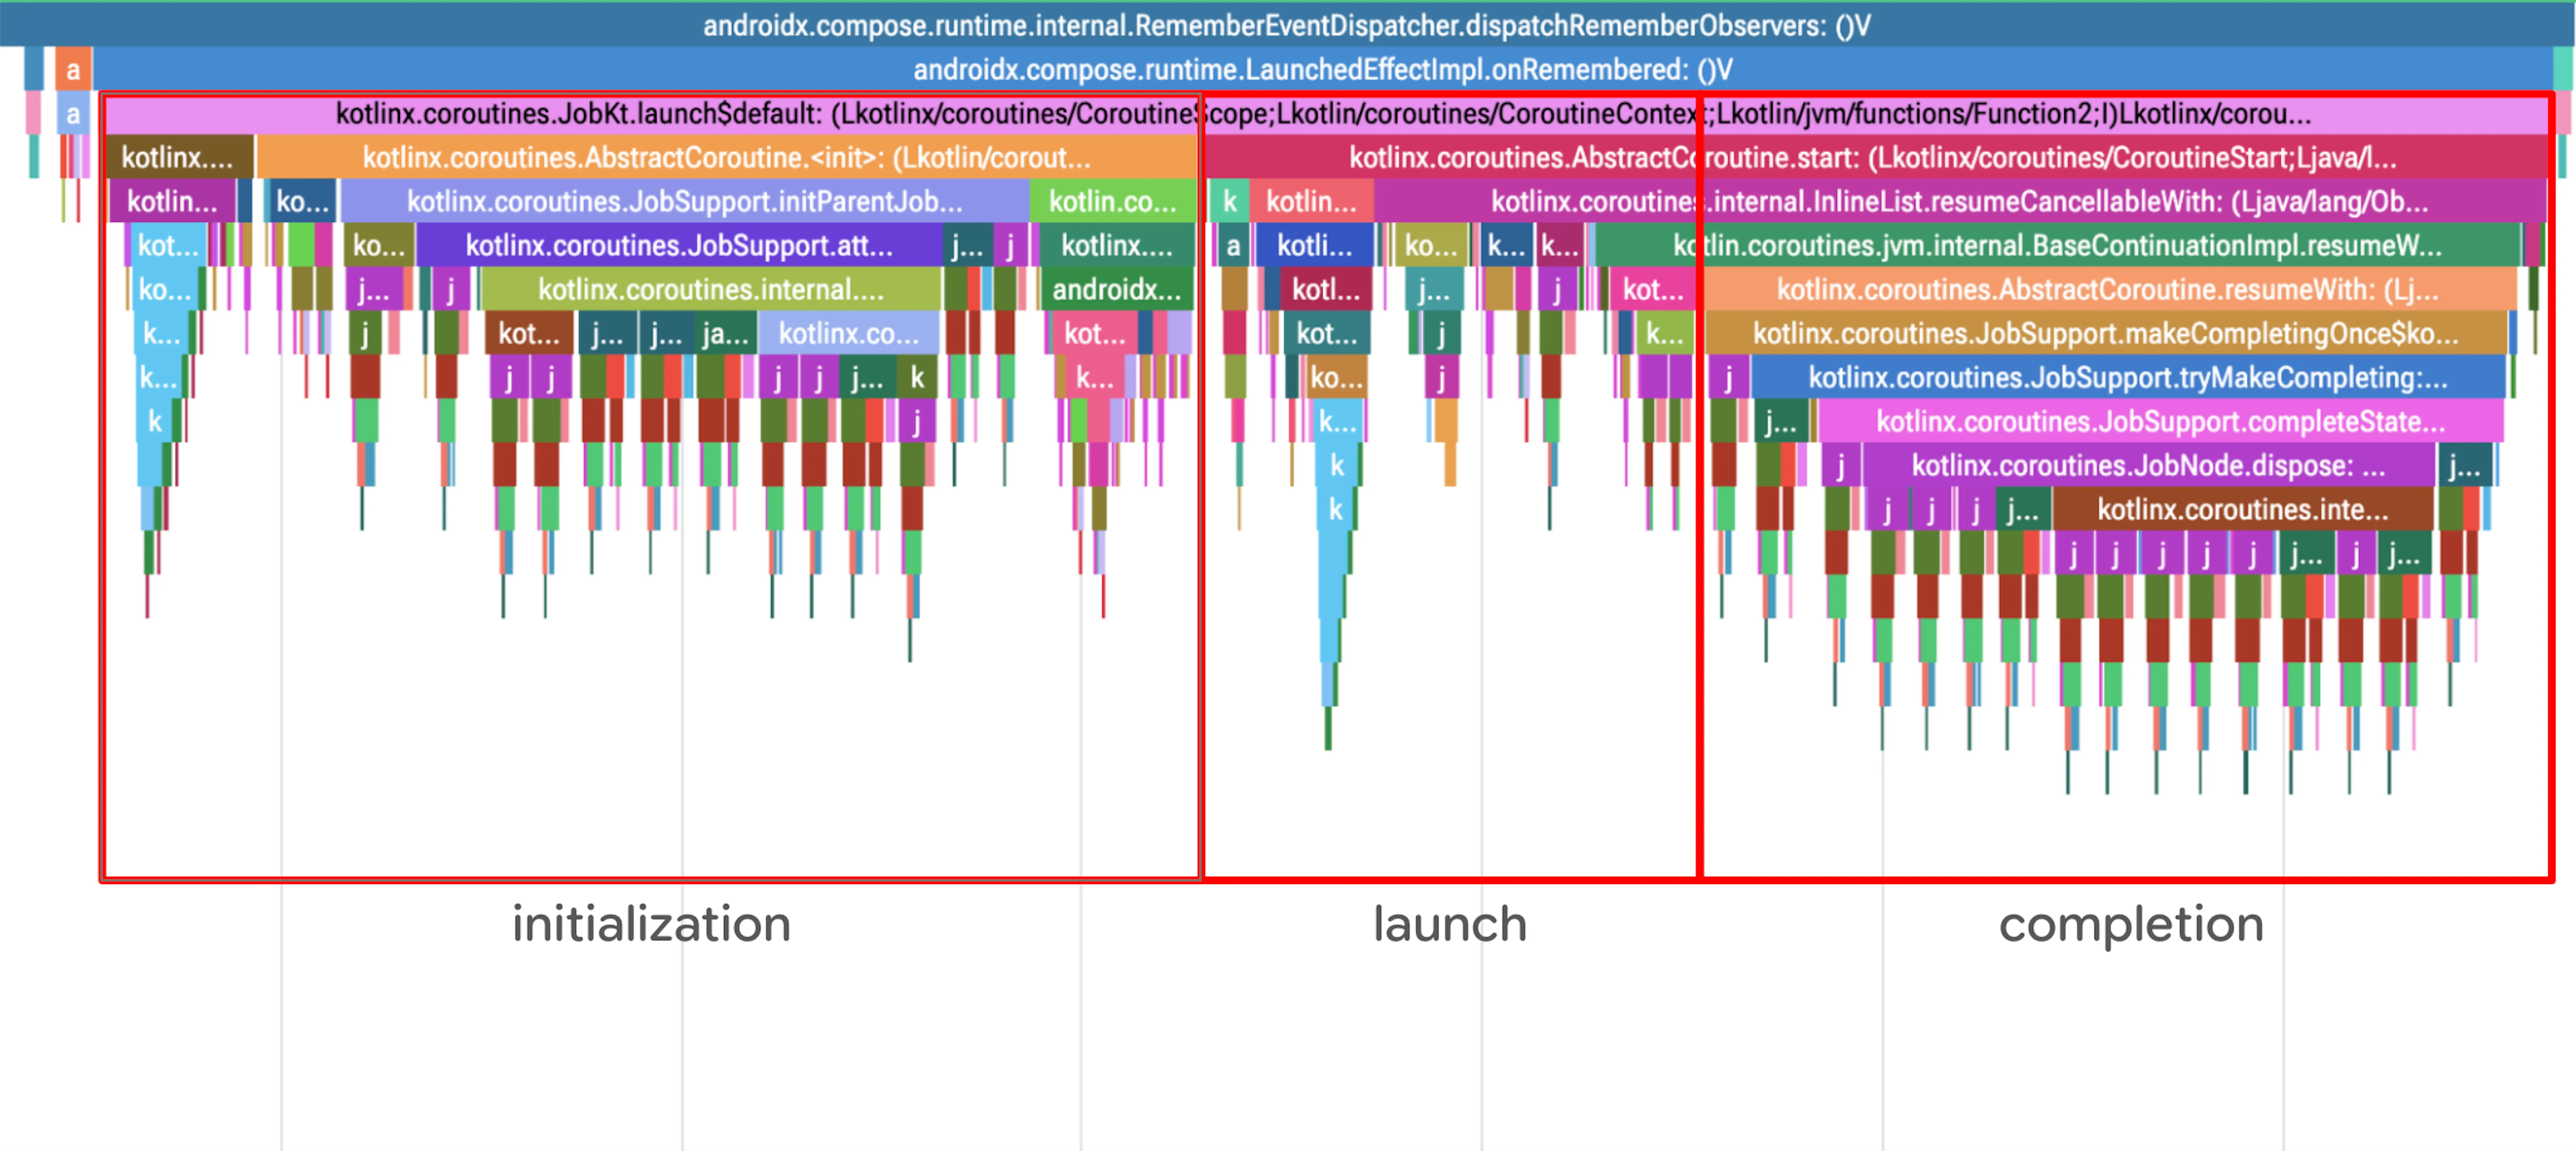
Der obige Methoden-Trace kann in drei Teile unterteilt werden:
- Neue Koroutine wird initialisiert
- Koroutine starten
- Koroutine wird abgeschlossen (da sie sofort beendet wird)
Das Abbrechen von LaunchedEffect ähnelt dem normalen Abschluss, es wird jedoch auch ein CancellationException erstellt.
Im obigen Profil sind die häufigen Aufrufe von java.util.concurrent.AtomicReferenceFieldUpdater (violette oder grüne Felder mit j…-Labels) sofort verdächtig. Jeder Aufruf ist zwar relativ schnell, aber die Häufigkeit ist besorgniserregend. Jeder nicht zu vernachlässigende Overhead, der auf mehrere Aufrufe verteilt ist, kann zu einer spürbaren Regression führen. Wenn wir uns einen Aufruf genauer ansehen, stellen wir fest, dass die meiste Zeit für… Reflexionsprüfungen aufgewendet wird?
Koroutinen implementieren eine sperrenfreie Baumstruktur für über- und untergeordnete Beziehungen, die eine strukturierte Nebenläufigkeit ermöglicht. Es stellt sich heraus, dass die kotlinx.atomicfu-Bibliothek sperrenfreie atomare Vorgänge mit einem bekannten JVM-Primitiv implementiert, AtomicReferenceFieldUpdater. Der Updater verwendet eine Klassenreferenz und einen Feldnamen, um atomare Vorgänge zur Laufzeit auszuführen. Außerdem muss er mehrere reflektive Sicherheitsprüfungen durchführen, um sicherzustellen, dass das Feld vorhanden und zugänglich ist. Jeder Vorgang in Koroutinen (Starten, Aussetzen, Abbrechen, Abschließen) ruft mindestens einen atomaren Vorgang auf. Wenn dieser langsam ist, ist die Leistung der Koroutinen nicht gut.
AtomicReferenceFieldUpdater untersuchen
Aber eines nach dem anderen. AtomicReferenceFieldUpdater ist auf der JVM seit über 10 Jahren gut optimiert und Methoden-Traces können Overhead erfassen, der durch eine Optimierung auf VM-Ebene vollständig entfernt wird: JIT- (Just-in-Time) oder AOT-Kompilierungen (Ahead-of-Time). Um die Leistung zu überprüfen, schreiben wir ein paar Benchmarks, um den Unterschied zwischen atomaren Referenzen von kotlinx.atomicfu und java.util.concurrent.atomic zu messen.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
Wenn Sie diesen Benchmark auf einem Pixel 5 ausführen und dabei sicherstellen, dass AtomicReferenceFieldUpdater#compareAndSet während des Warm-ups Just-in-time-kompiliert wird, erhalten Sie auf dem Pixel 5 (API 33) die folgenden Ergebnisse:
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
Die Messungen bestätigen die Lücke, wobei die kotlinx.atomicfu-Version etwa 2,7-mal langsamer ist. Dies bestätigt, dass ART keine versteckte Optimierung durchführt und dass Prüfungen des reflektierenden Zugriffs während der Laufzeit einen echten Mehraufwand verursachen.
Wenn wir uns den ursprünglichen Methoden-Trace noch einmal ansehen, ist die einzige sinnvolle Arbeit, die von AtomicReferenceFieldUpdater ausgeführt wird, der interne Aufruf von Unsafe.getObjectVolatile, der die zugrunde liegende atomare Operation tatsächlich ausführt. In den meisten Fällen ist der Updater-Initialisierer statisch und kann anhand der Struktur der umgebenden Klasse als immer korrekt nachgewiesen werden. Daher könnte man die meisten AtomicReferenceFieldUpdater-Verwendungen statisch analysieren und sie während der Kompilierung durch eine interne Unsafe-Variante ersetzen. Zufälligerweise hat die Android-Build-Toolchain einen eigenen optimierenden Compiler, der genau das kann.
Optimierung mit R8
Die Atomic*FieldUpdater -Klassen unterstützen eine subtile, dynamische und reflexionsbasierte Verwendung, werden aber oft in statisch offensichtlichen Mustern verwendet. Das erklärt sowohl die langsame Baseline-Leistung als auch den Wunsch nach Optimierung. R8 ist ein optimierender Compiler für das gesamte Programm und eignet sich gut, um die einfacheren Muster zu durchschauen und den Overhead der reflektiven Sicherheitsprüfungen zu reduzieren. R8 empfängt JVM-Bytecode nach dem Java- oder Kotlin-Compiler. Zur besseren Lesbarkeit werden diese Beispiele jedoch in Java-Syntax dargestellt. Deshalb gibt es keine Typargumente für AtomicReferenceFieldUpdater.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
Im Basisbeispiel wird ein statischer finaler Updater erstellt, der auf ein flüchtiges Feld mit einfachen konstanten Argumenten für den Inhaber, den Typ und den Namen des Felds zugreift. Die verwendete Reflexion ist vollständig transparent. Es ist klar zu erkennen, dass dieser Updater auf ein gültiges Feld verweist und dass die Website, auf der der Updater erstellt wurde, gültigen Zugriff auf das Feld hat.
Im Wesentlichen ist Atomic*FieldUpdater ein Wrapper für einen Feld-Offset und Aufrufe von Unsafe. Im besten Fall wird das Updater-Feld durch ein Offset-Feld und die Updater-Aufrufe durch Aufrufe von Unsafe ersetzt.
Atomic*FieldUpdater optimieren
Die Optimierung erfolgt in drei Schritten: Instrumentierung, Ersetzung und Bereinigung.
Instrumentierung
Der erste Schritt besteht darin, neben dem Updater-Feld Offset-Felder einzuführen, um den direkten Zugriff über den Aufruf Unsafe zu ermöglichen.
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
Auf das Feld wird über Reflexion zugegriffen und Unsafe wird verwendet, um den Feld-Offset für die Klasse zu extrahieren. Dieser Code stellt die internen Abläufe von Atomic*FieldUpdater dar, wenn Sie die Reflexionsvalidierung ignorieren. Stattdessen werden der Inhabertyp des Updaters und der Feldtyp des flüchtigen Felds statisch im Compiler verfolgt.
Das ursprüngliche Feld und seine Initialisierung bleiben unverändert. Der Optimierungsprozess erleichtert und optimiert die Verwendung und bereinigt sie später. Dies ist ein einfacher Ansatz für die Implementierung, der aber auch eine teilweise Optimierung von Aktualisierungsfeldern ermöglicht, bei der einige Verwendungen unverändert bleiben, während andere optimiert werden.
Ersetzen
An dieser Stelle im Compiler, nach einem geeigneten Concurrency-Join-Point, haben wir eine Liste von instrumentierten Updater-Feldern. Das bedeutet, dass wir jede Aufrufstelle einzeln anhand einiger Bedingungen optimieren können. Beispielaufruf:
updater.compareAndSet(holder, expectedValue, newValue);
Für Atomic*FieldUpdater gelten die folgenden Bedingungen:
- Stammt
updateraus einem instrumentierten Feld? Das heißt, kann die statische Analyse den Wert des Objekts auf ein Feld zurückführen, das von einem instrumentierten Updater gelesen wurde? - Ist
holderdieselbe Klasse oder eine Unterklasse des ursprünglich definierten Inhabertyps? - Ist
newValuedieselbe Klasse oder eine Unterklasse des ursprünglich definierten Feldtyps?
Wenn alle Bedingungen erfüllt sind, wird der Aufruf durch einen Aufruf von Unsafe ersetzt, ohne dass die Reflexionsprüfungen durchgeführt werden.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
Dieser neue Aufruf ist schneller und einfacher, unterscheidet sich aber vom ursprünglichen Aufruf in Bezug auf die Verarbeitung von Nullwerten in updater und holder. Sofern nicht statisch ausgeschlossen, werden für beide Null-Prüfungen eingefügt.
Klären
An diesem Punkt enthält die Holding-Klasse das ursprüngliche Updater-Feld und das neue Offset-Feld sowie Aufrufstellen, die eines der beiden Felder verwenden können. Wenn keine der Aufrufstellen optimiert wurde, sollte das Feld „offset“ entfernt werden. Wenn alle Aufrufstellen optimiert wurden, sollte das Feld „updater“ entfernt werden. In beiden Fällen sollte auch der Initialisierungsaufruf gelöscht werden. Das Löschen nicht verwendeter Felder und das Entfernen von totem Code erfolgt bereits im Compiler. Das Entfernen des Initialisierungscodes erfordert jedoch einige weitere Tricks.
Sowohl der Aufruf von newUpdater als auch der von getDeclaredField können Nebenwirkungen haben, da sie Ausnahmen auslösen können. Außerdem ist ihre Implementierung unbekannt, da sie von der API-Version abhängt. Das bedeutet, dass sie durch eine allgemeine Optimierung nicht sicher entfernt werden können. Diese Bereinigung erforderte also eine explizite Berücksichtigung der instrumentierten Felder, da diese statisch als frei von Ausnahmen bekannt sind.
Das oben gezeigte einfache Updater-Beispiel sieht nach der Optimierung so aus:
Ergebnisse
Nach diesen Optimierungen entsprechen kotlinx.atomicfu und die meisten expliziten Verwendungen von AtomicInt/Long/ReferenceFieldUpdater jetzt der Leistung von AtomicReference, wenn R8 angewendet wird. Tatsächlich ist es in einigen Benchmarks sogar schneller. kotlinx.atomicfu hat ein Compiler-Plug-in, mit dem atomic-Instanzen in Felder eingefügt werden können. Dadurch werden die Zuweisungen reduziert, die zum Erstellen eines atomar aktualisierten Felds erforderlich sind.
Jetpack Compose war der Hauptnutznießer dieser Arbeit. Die Compose-Laufzeit umfasst eine Reihe von Mikro-Benchmarks, mit denen die Leistung von Koroutinen sehr genau verfolgt wird, um Leistungseinbußen frühzeitig zu erkennen. Als die Benchmarks auf eine neue Version von R8 aktualisiert wurden, haben wir beim Starten und Abbrechen von Koroutinen in LaunchedEffect eine zweifache Verbesserung festgestellt.
Darüber hinaus implementiert das ART-Team diese Optimierungen nativ auf VM-Ebene. Wenn Ihre App auf API 36 ausgerichtet ist und auf einer aktuellen Android-Version ausgeführt wird, werden Koroutinen auf Ihrem Gerät möglicherweise bereits auf ähnliche Weise optimiert. Bei den oben genannten Coroutine-Benchmarks wurde nach JIT-Updates in den aktuellen ART-Versionen eine Leistungsverbesserung von etwa 15% festgestellt.
Ihre App wird standardmäßig optimiert, wenn Sie auf AGP 9.2.0 upgraden oder R8 9.2.0 direkt verwenden. Weitere Informationen finden Sie unter D8-Dexer und R8-Shrinker.
-
 Fallstudien
Grab ist die führende Super-App in Südostasien. Sie bietet Millionen von Nutzern in acht Ländern Liefer-, Mobilitäts- und Finanzdienstleistungen über eine einzige App.
Ajesh Pai, Nguyen Van Minh, Tracy Agyemang • Lesezeit: 5 Minuten -
 Fallstudien
Das Team entwickelte eine KI-native UI-Codebasis, die 50% kleiner als die ursprüngliche Implementierung ist. Gleichzeitig wurde die Ausführungszeit des KI-Agenten um 35% reduziert, die Anzahl der Interaktionen zwischen Entwicklern und Agenten um 32% gesenkt und die Tokenkosten um 33% verringert.
Pavlo Stavytskyi, Rebecca Franks • Lesezeit: 11 Minuten -
 Fallstudien
WhatsApp ist die weltweit größte Messaging-Plattform mit Milliarden von Nutzern weltweit. Es ist das Standardkommunikationstool für Menschen in verschiedenen Regionen und verbindet Nutzer über private, zuverlässige und sichere Nachrichten.
Niharika Arora, Tracy Agyemang, Mayank Jain • Lesezeit: 8 Minuten
Lassen Sie sich Woche für Woche die neuesten Informationen zur Android-Entwicklung zusenden.