AGP 9.2.0 से, R8, ज़्यादातर Atomic*FieldUpdater कॉल को Unsafe वैरिएंट में ऑप्टिमाइज़ करता है. ये वैरिएंट, सामान्य कार्रवाइयों में 2 से 4 गुना बेहतर परफ़ॉर्म करते हैं. इसका असर खास तौर पर kotlinx.atomicfu लाइब्रेरी पर पड़ता है. यह लाइब्रेरी, kotlinx.coroutines के लिए एटॉमिक लागू करती है. इससे को-रूटीन को लॉन्च और रद्द करने की प्रोसेस, दो गुना तेज़ी से होती है. इन फ़ायदों को पाने के लिए, अपने एजीपी को 9.2.0 या इसके बाद के वर्शन पर अपडेट करें.
ज़्यादातर Android ऐप्लिकेशन, Kotlin को अपनी मुख्य भाषा के तौर पर इस्तेमाल कर रहे हैं. इसलिए, kotlinx.coroutines एसिंक्रोनस प्रोग्रामिंग के लिए एक डिफ़ॉल्ट स्टैंडर्ड बन गया है. यह लाइब्रेरी, एक साथ कई फ़्लो को मैनेज करने का एक बेहतरीन और व्यवस्थित तरीका उपलब्ध कराती है. यह Kotlin के लिए नेटिव है. Jetpack Compose भी इससे अलग नहीं था. इसमें पॉइंटर इवेंट, ऐनिमेशन, और अन्य इंटरैक्शन को मैनेज करने के लिए को-रूटीन का इस्तेमाल किया गया. इस लेख को लिखते समय, Compose में मौजूद ज़्यादातर कॉंकरेंट एपीआई, बैकग्राउंड में suspend फ़ंक्शन को कॉल करते हैं. साथ ही, अपडेट को मैनेज करने के लिए, को-रूटीन लॉन्च और/या रद्द करते हैं.
जब Compose टीम ने परफ़ॉर्मेंस की जांच शुरू की, तो पता चला कि कंपोज़िशन के बाहर होने वाले कई ऑपरेशनों के लिए, कोरूटीन एक बॉटलनेक (काम में रुकावट) है. उदाहरण के लिए, Modifier.clickable को बनाने और अपडेट करने में लगने वाले समय का 80% हिस्सा, InteractionSource अपडेट को मैनेज करने वाली इंटरनल को-रूटीन को लॉन्च करने और रद्द करने में खर्च हुआ. इन ऑब्ज़र्वेशन के आधार पर, शुरुआती परफ़ॉर्मेंस को बेहतर बनाने के लिए किए गए ज़्यादातर काम में, डिफ़ॉल्ट पाथ से कोरूटीन को हटाना और ज़रूरी होने तक इनिशियलाइज़ेशन में देरी करना शामिल था.
को-रूटीन की लागत
Android पर किसी फ़ंक्शन के इंटरनल व्यवहार का विश्लेषण करने का सबसे आसान तरीका है, Android Runtime (ART) के तरीके को ट्रेस करना. एआरटी मेथड ट्रेस, एक ऐसा टूल है जो किसी ऐप्लिकेशन के एक्ज़ीक्यूशन फ़्लो को रिकॉर्ड करता है. इससे यह पता चलता है कि कौनसे तरीके कॉल किए गए, उनका क्रम क्या है, और हर तरीके में कितना समय लगा. इससे डेवलपर को परफ़ॉर्मेंस से जुड़ी समस्याओं की पहचान करने में मदद मिलती है. बिना डेटा वाली LaunchedEffect { } कॉल के लिए, यह कुछ इस तरह दिखेगा:
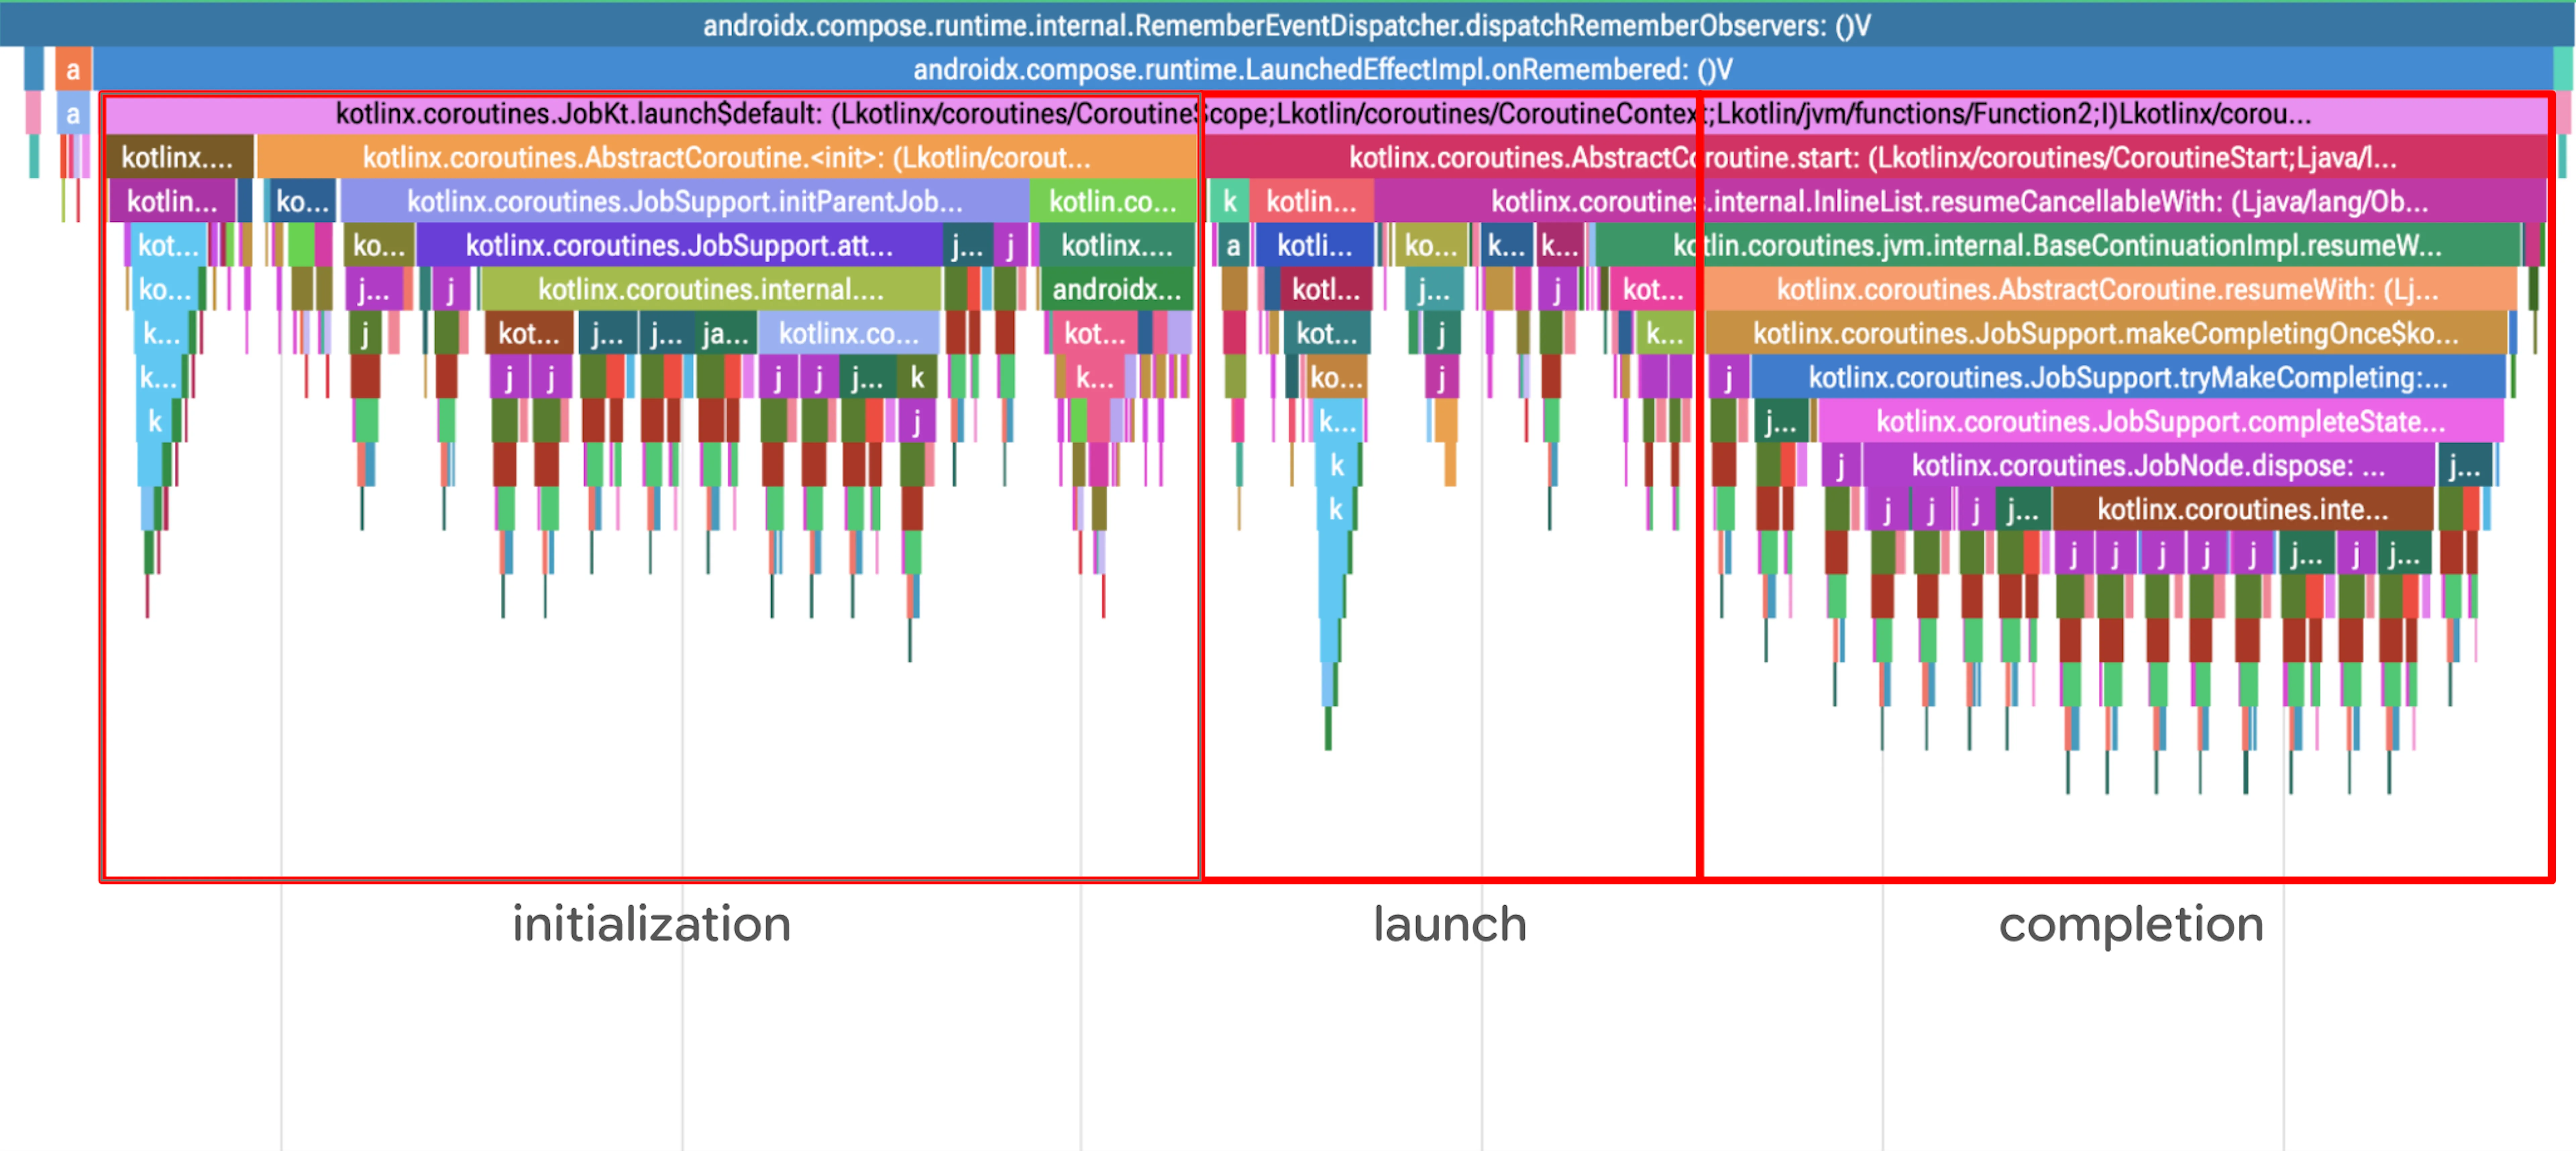
ऊपर दिए गए तरीके के ट्रेस को तीन हिस्सों में बांटा जा सकता है:
- नई को-रूटीन शुरू की जा रही है
- कोरूटीन शुरू हो रही है
- को-रूटीन पूरा हो रहा है (क्योंकि यह तुरंत बंद हो जाता है)
LaunchedEffect को रद्द करना, सामान्य तौर पर पूरा करने जैसा ही है. हालांकि, इससे एक CancellationException भी बनता है.
ऊपर दी गई प्रोफ़ाइल में, एक चीज़ तुरंत संदिग्ध लगती है. वह है java.util.concurrent.AtomicReferenceFieldUpdater (j… लेबल वाले बैंगनी या हरे बॉक्स) को बार-बार कॉल करना. हर कॉल में कम समय लगता है, लेकिन कॉल की फ़्रीक्वेंसी चिंता का विषय है. अगर कई बार कॉल करने पर, थोड़ा-बहुत भी ओवरहेड होता है, तो इससे परफ़ॉर्मेंस में काफ़ी गिरावट आ सकती है. कॉल को ज़ूम इन करने पर पता चलता है कि ज़्यादातर समय... रिफ़्लेक्शन की जांच में लगता है?
को-रूटीन, पैरंट-चाइल्ड रिलेशनशिप के लिए लॉक-फ़्री ट्री स्ट्रक्चर लागू करते हैं. इससे स्ट्रक्चर्ड कंकरेंसी मुमकिन हो पाती है. kotlinx.atomicfu लाइब्रेरी, लॉक-फ़्री ऐटॉमिक ऑपरेशनों को लागू करती है. इसके लिए, यह जेवीएम प्रिमिटिव AtomicReferenceFieldUpdater का इस्तेमाल करती है. अपडेटर, क्लास के रेफ़रंस और फ़ील्ड के नाम का इस्तेमाल करके, रनटाइम के दौरान ऐटम ऑपरेशन करता है. साथ ही, इसे कई रिफ़्लेक्टिव सुरक्षा जांचें करनी होती हैं, ताकि यह पक्का किया जा सके कि फ़ील्ड मौजूद है और इसे ऐक्सेस किया जा सकता है. को-रूटीन में हर ऑपरेशन (शुरू करना, रोकना, रद्द करना, पूरा करना) कम से कम एक ऐटॉमिक ऑपरेशन को कॉल करता है. इसलिए, अगर यह धीमा है, तो को-रूटीन ठीक से काम नहीं करेंगे.
AtomicReferenceFieldUpdater की जांच करना
हालांकि, हमें अभी से ही नतीजे के बारे में नहीं सोचना चाहिए. AtomicReferenceFieldUpdater को पिछले 10 सालों से JVM पर अच्छी तरह से ऑप्टिमाइज़ किया गया है. साथ ही, ऐसा हो सकता है कि मेथड ट्रेस, वीएम लेवल के ऑप्टिमाइज़ेशन से पूरी तरह से हटाए गए ओवरहेड को कैप्चर करें: जैसे, जस्ट-इन-टाइम (JIT) या ऐड-ऑफ-टाइम (AOT) कंपाइलेशन. परफ़ॉर्मेंस की पुष्टि करने के लिए, आइए कुछ बेंचमार्क लिखें. इनसे kotlinx.atomicfu और java.util.concurrent.atomic के एटॉमिक रेफ़रंस के बीच के अंतर का आकलन किया जा सकेगा.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
Pixel 5 पर इस बेंचमार्क को चलाने पर, ये नतीजे मिलते हैं. इस दौरान, यह पक्का किया जाता है कि वार्मअप के दौरान AtomicReferenceFieldUpdater#compareAndSet को JIT कंपाइल किया गया हो. ये नतीजे Pixel 5 (API 33) पर मिले हैं:
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
मेज़रमेंट से इस अंतर की पुष्टि होती है. साथ ही, यह भी पता चलता है कि kotlinx.atomicfu वर्शन, 2.7 गुना ज़्यादा समय लेता है. इससे पुष्टि होती है कि एआरटी, कोई भी छिपा हुआ ऑप्टिमाइज़ेशन नहीं करता है. साथ ही, रिफ़्लेक्टिव ऐक्सेस की जांच करने से, रनटाइम के दौरान असली ओवरहेड जुड़ जाता है.
ओरिजनल तरीके के ट्रेस पर वापस जाने पर, AtomicReferenceFieldUpdater ने सिर्फ़ एक काम किया है. वह यह है कि उसने Unsafe.getObjectVolatile को इंटरनल कॉल किया है. यही कॉल, एटॉमिक ऑपरेशन को असल में लागू करता है. ज़्यादातर मामलों में, अपडेटर इनिशियलाइज़र स्टैटिक होता है. साथ ही, इसे आस-पास की क्लास के स्ट्रक्चर के आधार पर हमेशा सही साबित किया जा सकता है. इसलिए, कंपाइलेशन के दौरान AtomicReferenceFieldUpdater के ज़्यादातर इस्तेमाल का स्टैटिक विश्लेषण किया जा सकता है. साथ ही, उन्हें Unsafe के इंटरनल वैरिएंट से बदला जा सकता है. Android बिल्ड टूलचेन में, ऑप्टिमाइज़ करने वाला कंपाइलर होता है. यह कंपाइलर, इस काम को आसानी से कर सकता है.
R8 की मदद से ऑप्टिमाइज़ेशन
Atomic*FieldUpdater क्लास, रिफ़्लेक्शन पर आधारित डाइनैमिक और बारीकी से इस्तेमाल करने की सुविधा देती हैं. हालांकि, इनका इस्तेमाल अक्सर स्टैटिक तौर पर दिखने वाले पैटर्न में किया जाता है. इससे, बेसलाइन परफ़ॉर्मेंस के कम होने और ऑप्टिमाइज़ेशन की ज़रूरत के बारे में पता चलता है. R8, पूरे प्रोग्राम को ऑप्टिमाइज़ करने वाला कंपाइलर है. यह आसान पैटर्न को समझने के लिए सबसे सही है. इससे रिफ़्लेक्टिव सुरक्षा जांचों के ओवरहेड को कम किया जा सकता है. R8 को Java या Kotlin कंपाइलर के बाद JVM बाइटकोड मिलता है. हालांकि, इन उदाहरणों को Java सिंटैक्स में दिखाया गया है, ताकि इन्हें आसानी से पढ़ा जा सके. इसलिए, AtomicReferenceFieldUpdater के लिए कोई टाइप आर्ग्युमेंट नहीं है.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
इस बुनियादी उदाहरण में, एक स्टैटिक फ़ाइनल अपडेटर बनाया गया है. यह होल्डर, टाइप, और फ़ील्ड के नाम के लिए, सामान्य कॉन्स्टेंट आर्ग्युमेंट के साथ एक अस्थिर फ़ील्ड को ऐक्सेस करता है. इस्तेमाल किया गया रिफ़्लेक्शन पूरी तरह से पारदर्शी है. अपडेटर, मान्य फ़ील्ड का रेफ़रंस देता है. साथ ही, अपडेटर बनाने वाली साइट के पास फ़ील्ड का मान्य ऐक्सेस है.
असल में, Atomic*FieldUpdater, फ़ील्ड ऑफ़सेट और Unsafe को कॉल करने के लिए एक रैपर है. ऑप्टिमाइज़ेशन के लिए सबसे सही तरीका यह है कि अपडेटर फ़ील्ड को ऑफ़सेट फ़ील्ड से बदल दिया जाए. साथ ही, अपडेटर कॉल को Unsafe के कॉल से बदल दिया जाए.
Optimizing Atomic*FieldUpdater
ऑप्टिमाइज़ेशन को तीन हिस्सों में लागू किया जाता है: इंस्ट्रुमेंटेशन, रिप्लेसमेंट, और क्लीन-अप.
इंस्ट्रुमेंटेशन
पहला चरण, अपडेटर फ़ील्ड के साथ-साथ ऑफ़सेट फ़ील्ड को भी शामिल करना है, ताकि Unsafe कॉल के ज़रिए सीधे तौर पर ऐक्सेस किया जा सके.
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
इस फ़ील्ड को रिफ़्लेक्शन के ज़रिए ऐक्सेस किया जाता है. साथ ही, क्लास में फ़ील्ड ऑफ़सेट निकालने के लिए Unsafe का इस्तेमाल किया जाता है. अगर रिफ़्लेक्शन की पुष्टि को अनदेखा किया जाता है, तो यह कोड Atomic*FieldUpdater के इंटरनल को दिखाता है. इसके बजाय, अपडेटर के होल्डर टाइप और अस्थिर फ़ील्ड के फ़ील्ड टाइप को कंपाइलर में स्टैटिक तौर पर ट्रैक किया जाता है.
ध्यान दें कि ओरिजनल फ़ील्ड और उसके इनिशियलाइज़ेशन को पहले जैसा ही रखा जाता है. ऑप्टिमाइज़ेशन प्रोसेस, इस्तेमाल को बेहतर बनाने और ऑप्टिमाइज़ करने में मदद करती है. इसके बाद, इसे क्लीन अप कर देती है. यह अपडेट लागू करने का एक आसान तरीका है. हालांकि, इससे अपडेटर फ़ील्ड को आंशिक रूप से ऑप्टिमाइज़ किया जा सकता है. इसमें कुछ फ़ील्ड को पहले जैसा ही रखा जाता है, जबकि कुछ को ऑप्टिमाइज़ किया जाता है.
प्रतिस्थापन
कंपाइलर में इस पॉइंट पर, एक साथ कई काम करने की सुविधा वाले सही जॉइन पॉइंट के बाद, हमारे पास इंस्ट्रुमेंट किए गए अपडेटर फ़ील्ड की सूची होती है. इसका मतलब है कि हम कुछ शर्तों के आधार पर, हर कॉल साइट को अलग-अलग ऑप्टिमाइज़ कर सकते हैं. कॉल का यह उदाहरण देखें:
updater.compareAndSet(holder, expectedValue, newValue);
Atomic*FieldUpdater के लिए ये शर्तें पूरी करना ज़रूरी है:
- क्या
updaterको इंस्ट्रुमेंट किए गए फ़ील्ड से लिया गया है? इसका मतलब है कि क्या स्टैटिक विश्लेषण, ऑब्जेक्ट की वैल्यू को इंस्ट्रुमेंट किए गए अपडेटर के फ़ील्ड रीड तक ट्रैक कर सकता है? - क्या
holder, होल्डर टाइप के तौर पर मूल तौर पर तय की गई क्लास या सब-क्लास है? - क्या
newValue, ओरिजनल फ़ील्ड टाइप की तरह ही क्लास या सबक्लास है?
अगर सभी शर्तें पूरी होती हैं, तो कॉल को Unsafe पर ट्रांसफ़र कर दिया जाता है. इस दौरान, कॉल की स्क्रीनिंग नहीं की जाती.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
यह नया कॉल, पहले वाले कॉल की तुलना में ज़्यादा तेज़ और आसान है. हालांकि, updater और holder में शून्य वैल्यू को हैंडल करने के मामले में, यह ओरिजनल कॉल से अलग है. जब तक स्टैटिक तौर पर यह तय न हो जाए कि वैल्यू शून्य नहीं है, तब तक दोनों के लिए शून्य की जांच की जाती है.
मिटाना
इस समय, होल्डिंग क्लास में ओरिजनल अपडेटर फ़ील्ड और नया ऑफ़सेट फ़ील्ड होता है. साथ ही, कॉल साइटें होती हैं, जो इन दोनों में से किसी एक का इस्तेमाल कर सकती हैं. अगर कॉल करने की किसी भी साइट को ऑप्टिमाइज़ नहीं किया गया है, तो ऑफ़सेट फ़ील्ड को हटा दिया जाना चाहिए. अगर कॉल करने की सभी साइटों को ऑप्टिमाइज़ किया गया है, तो अपडेटर फ़ील्ड को हटा दिया जाना चाहिए. दोनों ही मामलों में, कॉल शुरू करने की सुविधा भी मिटा दी जानी चाहिए. कंपाइलर में, इस्तेमाल न किए गए फ़ील्ड को मिटाने और डेड कोड को हटाने का काम पहले ही हो चुका है. हालांकि, यहां पर इनिशियलाइज़ेशन कोड को हटाने के लिए, कुछ और तरकीबों की ज़रूरत होती है.
newUpdater और getDeclaredField, दोनों को कॉल करने से साइड इफ़ेक्ट हो सकते हैं, क्योंकि ये अपवाद दे सकते हैं. साथ ही, इनके लागू होने के बारे में भी पता नहीं है, क्योंकि यह एपीआई वर्शन पर निर्भर करता है. इसका मतलब है कि सामान्य ऑप्टिमाइज़ेशन से, उन्हें सुरक्षित तरीके से नहीं हटाया जा सकता. इसलिए, इस क्लीन-अप के लिए इंस्ट्रुमेंट किए गए फ़ील्ड पर साफ़ तौर पर ध्यान देना ज़रूरी था, क्योंकि ये फ़ील्ड स्टैटिक तौर पर अपवादों से मुक्त होते हैं.
ऑप्टिमाइज़ेशन के बाद, ऊपर दिखाया गया सामान्य अपडेटर का उदाहरण ऐसा दिखता है:
नतीजे
इन ऑप्टिमाइज़ेशन के बाद, kotlinx.atomicfu और AtomicInt/Long/ReferenceFieldUpdater के ज़्यादातर इस्तेमाल अब R8 के साथ AtomicReference की परफ़ॉर्मेंस से मेल खाते हैं. असल में, यह कुछ बेंचमार्क में और भी तेज़ है. kotlinx.atomicfu में एक कंपाइलर प्लगिन होता है, जो atomic इंस्टेंस को फ़ील्ड में इनलाइन कर सकता है. इससे, एटॉमिक तौर पर अपडेट किए गए फ़ील्ड को बनाने के लिए ज़रूरी ऐलोकेशन कम हो जाते हैं.
इस काम से Jetpack Compose को सबसे ज़्यादा फ़ायदा मिला. Compose रनटाइम में कई माइक्रोबेंचमार्क होते हैं. ये को-रूटीन की परफ़ॉर्मेंस को बारीकी से ट्रैक करते हैं, ताकि परफ़ॉर्मेंस में होने वाली गिरावट का पता लगाया जा सके. जब बेंचमार्क को R8 के नए वर्शन में अपडेट किया गया, तो हमने LaunchedEffect में को-रूटीन लॉन्च करने और रद्द करने के दौरान, दो गुना सुधार देखा!
इसके अलावा, एआरटी टीम इन ऑप्टिमाइज़ेशन को वीएम लेवल पर लागू कर रही है. अगर आपका ऐप्लिकेशन, एपीआई 36 को टारगेट कर रहा है और Android के नए वर्शन पर काम कर रहा है, तो हो सकता है कि आपका डिवाइस पहले से ही इसी तरह से को-रूटीन को ऑप्टिमाइज़ कर रहा हो. ऊपर दिए गए कोरूटीन बेंचमार्क में, ART के हाल ही के वर्शन में JIT अपडेट के बाद, परफ़ॉर्मेंस में ~15% का सुधार देखा गया.
AGP 9.2.0 पर अपग्रेड करने या सीधे तौर पर R8 9.2.0 का इस्तेमाल करने पर, आपके ऐप्लिकेशन को यह ऑप्टिमाइज़ेशन डिफ़ॉल्ट रूप से मिलेगा. ज़्यादा जानकारी के लिए, D8 dexer और R8 shrinker देखें.
-
 केस स्टडी
WhatsApp, दुनिया का सबसे बड़ा मैसेजिंग प्लैटफ़ॉर्म है. यह दुनिया भर के अरबों लोगों को अपनी सेवाएं देता है. यह अलग-अलग देशों/इलाकों के लोगों के लिए, बातचीत करने का डिफ़ॉल्ट टूल है. यह उपयोगकर्ताओं को निजी, भरोसेमंद, और सुरक्षित मैसेजिंग की सुविधा देता है.
Niharika Arora, Tracy Agyemang, Mayank Jain • 8 मिनट में पढ़ें -
 केस स्टडी
Tinder का मिशन, लोगों को आपस में जुड़ने के लिए प्रेरित करना है. इसके लिए, यह सिंगल लोगों की हर नई पीढ़ी के लिए, मिलना-जुलना आसान और मज़ेदार बनाता है.
Ajesh Pai, Ulises Uriel Verduzco Díaz , Tracy Agyemang • पढ़ने में 4 मिनट लगेंगे -
 केस स्टडी
परफ़ॉर्मेंस में गिरावट की समस्या को दोहराना बहुत मुश्किल होता है. इसलिए, यह मोबाइल डेवलपर के लिए एक बड़ी समस्या बन जाती है.
Alice Yuan, Arti Arutiunov, Nikita Ogorodnikov • पढ़ने में 4 मिनट लगेंगे
Android डेवलपमेंट से जुड़ी नई अहम जानकारी, हर हफ़्ते अपने इनबॉक्स में पाएं.