从 AGP 9.2.0 开始,R8 会将大多数 Atomic*FieldUpdater 调用优化为 Unsafe 变体,这些变体在常见操作上的性能提升了 2 到 4 倍。这对为 kotlinx.coroutines 实现原子操作的 kotlinx.atomicfu 库产生了特别大的影响,使启动和取消协程的速度提高了 2 倍。如需获得这些优势,请将 AGP 更新到 9.2.0 或更高版本。
由于大多数 Android 应用都采用 Kotlin 作为其主要语言,因此 kotlinx.coroutines 已成为异步编程的事实标准。该库提供了一种设计合理且结构化的方式来管理 Kotlin 原生的并发流。Jetpack Compose 也不例外,它采用协程来管理指针事件、动画和其他互动。在撰写本文时,Compose 中的大多数并发 API 都在后台调用 suspend 函数,并启动和/或取消协程来处理更新。
随着 Compose 团队开始调查性能,他们发现协程是许多在组合之外发生的操作的瓶颈。例如,在创建和更新 Modifier.clickable 上花费的时间中,有 80% 用于启动和取消处理 InteractionSource 更新的内部协程。根据这些观察结果,早期的大部分性能工作都侧重于从默认路径中移除协程,并延迟初始化,直到必要时才进行。
协程的开销
分析 Android 上函数内部行为的最简单方法是捕获 Android 运行时 (ART) 方法轨迹。ART 方法轨迹是一种工具,用于记录应用的执行流程,准确显示调用了哪些方法、它们的顺序以及在每个方法中花费的时间,从而让开发者能够识别性能瓶颈。对于空的 LaunchedEffect { } 调用,它看起来大致如下所示:
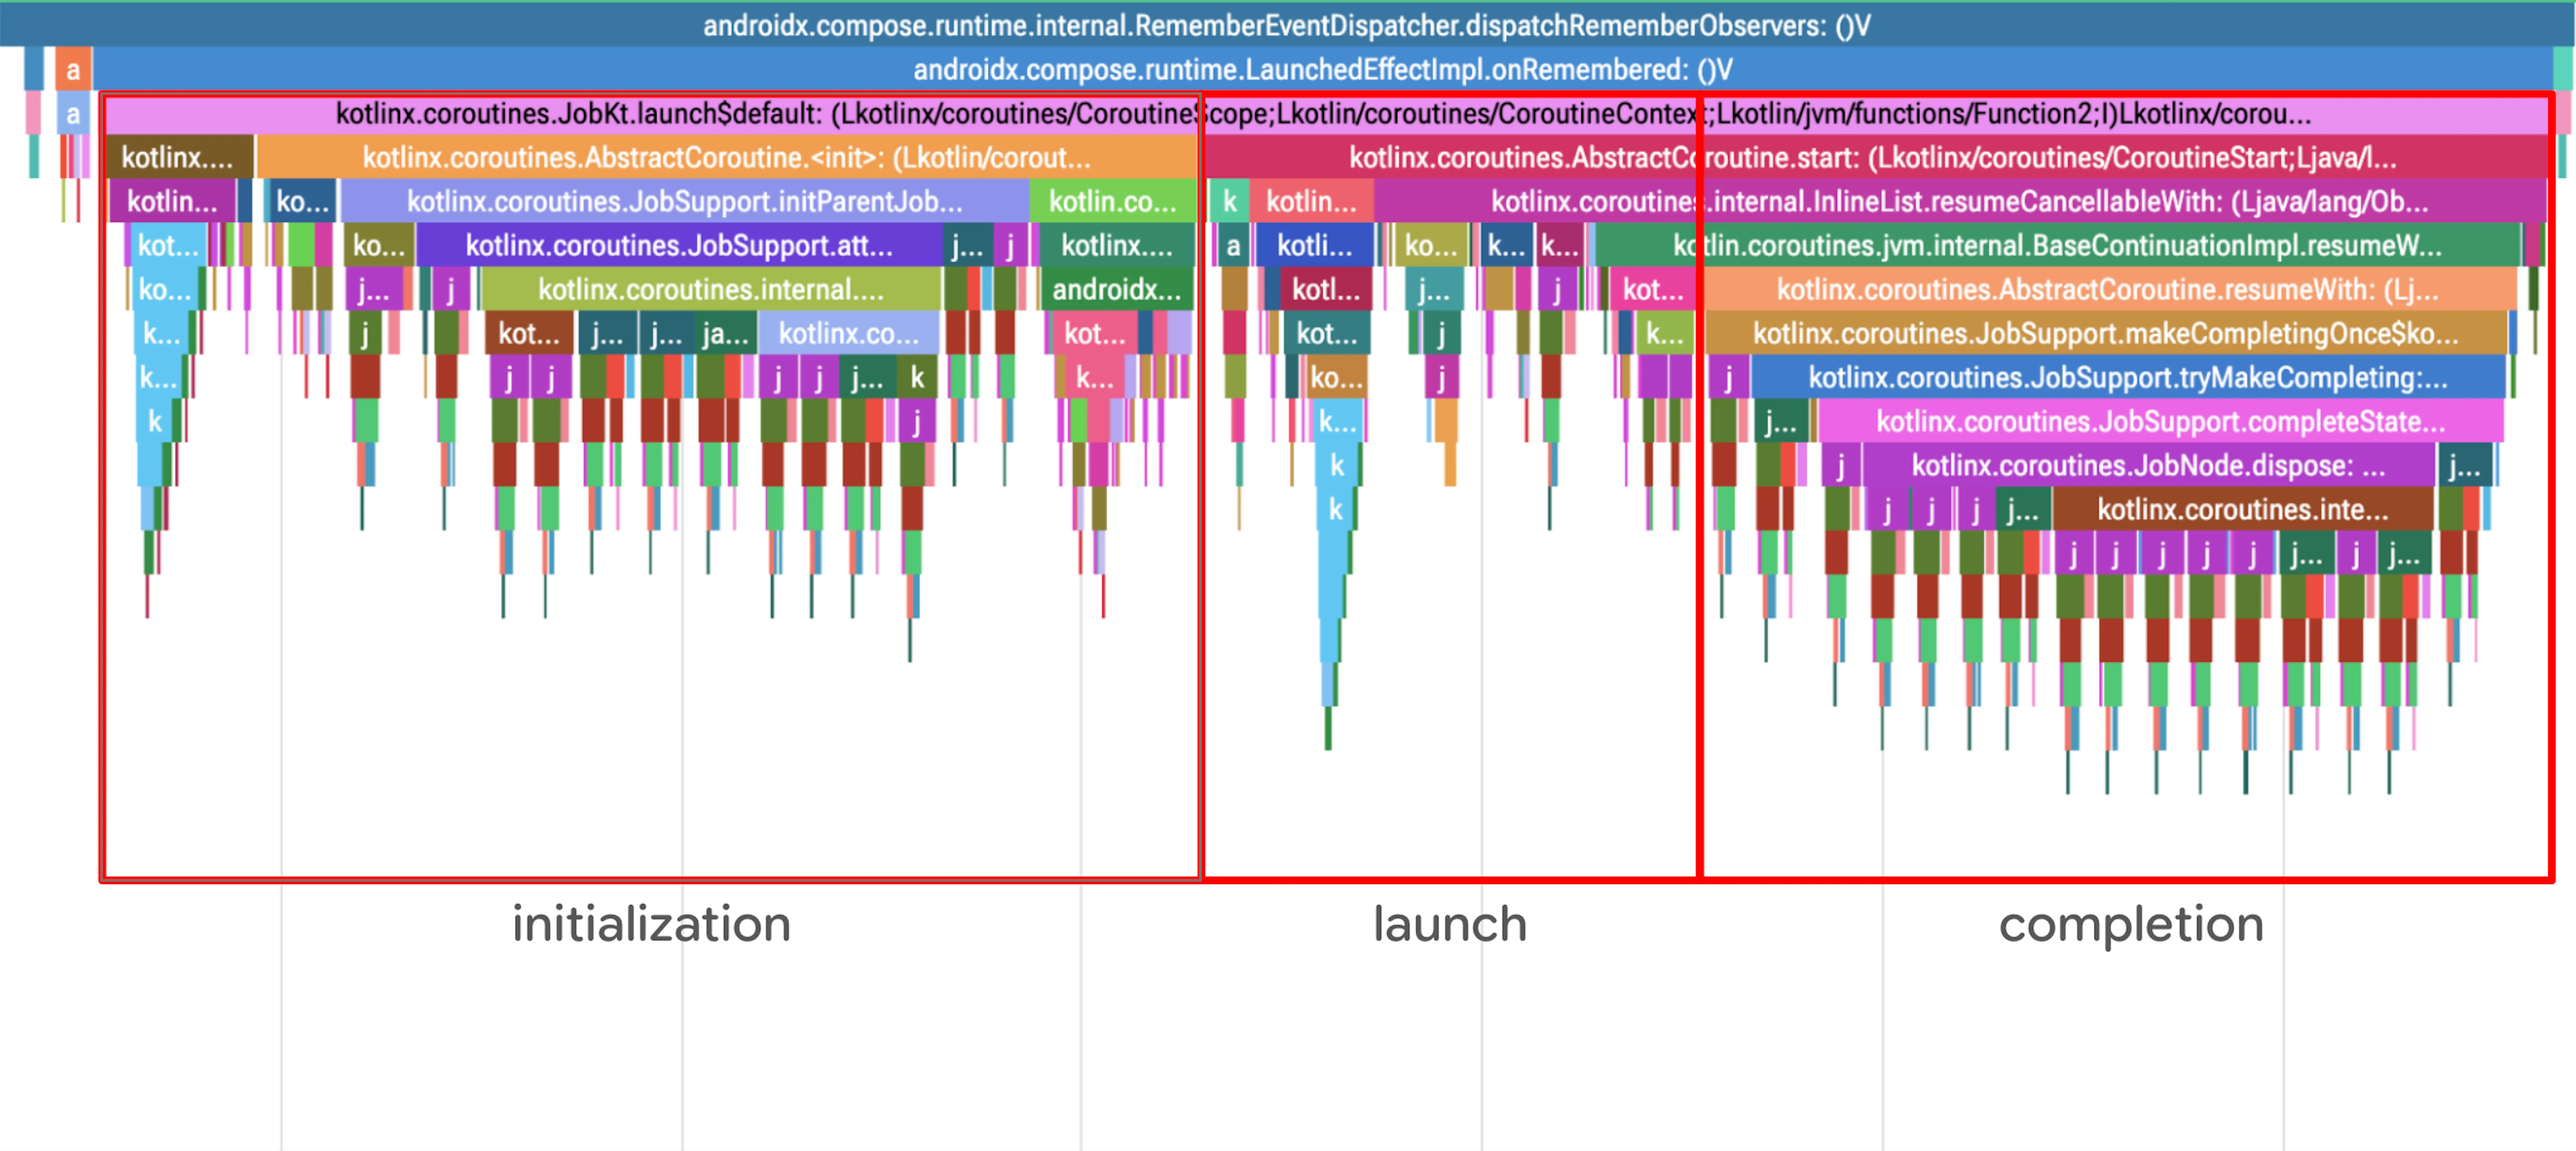
上面的方法轨迹可以分为三个部分:
- 初始化新协程
- 启动协程
- 完成协程(因为它会立即退出)
取消 LaunchedEffect 与正常完成类似,只不过它还会创建 CancellationException。
从上面的配置文件中,一个立即引起怀疑的地方是频繁调用 java.util.concurrent.AtomicReferenceFieldUpdater(带有 j… 标签的紫色或绿色框)。虽然每次调用都相对较快,但频率令人担忧;任何分布在多个调用中的不可忽略的开销都可能会累积成明显的回归。放大调用后会发现,大部分时间都花在了…反射检查上?
协程为父子关系实现无锁树结构,从而实现结构化并发。事实证明,kotlinx.atomicfu 库使用众所周知的 JVM 基元 AtomicReferenceFieldUpdater 实现无锁原子操作。更新程序使用类引用和字段名称在运行时执行原子操作,并且必须运行多个反射安全检查,以确保字段存在且可访问。协程中的每个操作(启动、挂起、取消、完成)至少调用一个原子操作,因此如果它很慢,协程的性能就不会很好。
调查 AtomicReferenceFieldUpdater
但我们不要操之过急。AtomicReferenceFieldUpdater 实际上在 JVM 上已经过充分优化 超过 10 年了,并且方法跟踪记录可能会捕获被虚拟机级优化(即时 (JIT) 或预先 (AOT) 编译)完全消除的开销。为了验证性能,我们编写了一些基准,用于衡量 kotlinx.atomicfu 和 java.util.concurrent.atomic 中的原子引用之间的差异。
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
在 Pixel 5 上运行此基准(同时确保 AtomicReferenceFieldUpdater#compareAndSet 在预热期间经过 JIT 编译)会在 Pixel 5 (API 33) 上产生以下结果:
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
测量结果证实了差距,其中 kotlinx.atomicfu 版本的速度明显慢了大约 2.7 倍。这证实了 ART 不执行任何隐藏优化,并且反射访问检查会在运行时增加实际开销。
回顾原始方法轨迹,AtomicReferenceFieldUpdater 执行的唯一有意义的工作是对 Unsafe.getObjectVolatile 的内部调用,该调用实际上执行了底层原子操作。在大多数情况下,更新程序初始化程序是静态的,并且可以根据周围类的结构证明其始终正确。因此,可以在编译期间静态分析大多数 AtomicReferenceFieldUpdater 用法,并将其替换为内部 Unsafe 变体。此外,Android 构建工具链恰好有自己的优化编译器,可以做到这一点。
使用 R8 进行优化
Atomic*FieldUpdater 类支持细微的动态和基于反射的使用,但通常以静态明显的模式使用。这既解释了基准性能较慢的原因,也解释了优化需求。R8 是一款完整的程序优化编译器,非常适合查看更简单的模式,以减少反射安全检查的开销。R8 在 Java 或 Kotlin 编译器之后接收 JVM 字节码,但为了便于阅读,这些示例以 Java 语法呈现。这就是 AtomicReferenceFieldUpdater 没有类型实参的原因。
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
基本示例创建了一个静态最终更新程序,该更新程序使用简单的常量实参(用于持有者、类型和字段名称)访问易失性字段。使用的反射完全透明。很明显,此更新程序引用了有效字段,并且更新程序创建的站点对该字段具有有效访问权限。
从本质上讲,Atomic*FieldUpdater 是对字段偏移量和对 Unsafe 的调用的封装。优化的最佳情况是将更新程序字段替换为偏移量字段,并将更新程序调用替换为对 Unsafe 的调用。
优化 Atomic*FieldUpdater
优化分为三个部分实现:插桩、替换和清理。
插桩
第一步是在更新程序字段旁边引入偏移量字段,以便通过 Unsafe 调用进行直接访问。
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
该字段通过反射访问,并使用 Unsafe 提取类上的字段偏移量。如果您忽略反射验证,则此代码表示 Atomic*FieldUpdater 的内部结构。相反,更新程序的持有者类型和易失性字段的字段类型在编译器中静态跟踪。
请注意,原始字段及其初始化保持不变。优化过程乐观地促进和优化使用,然后进行清理。这是一种简单的实现方法,但也允许对更新程序字段进行部分优化,其中一些用法保持不变,而另一些用法则经过优化。
替换
在编译器的这一点上,在合适的并发连接点之后,我们有一个插桩的更新程序字段列表。这意味着我们可以根据一些条件单独优化每个调用站点。考虑一个示例调用:
updater.compareAndSet(holder, expectedValue, newValue);
Atomic*FieldUpdater 需要的条件如下:
updater是否来自插桩字段?也就是说,静态分析是否可以将对象的值跟踪回插桩更新程序的字段读取?holder是否与最初定义的持有者类型相同或为其子类?newValue是否与最初定义的字段类型相同或为其子类?
如果满足所有条件,则调用将替换为对 Unsafe 的调用,而无需任何反射检查。
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
这个新调用更快更简单,但在处理 updater 和 holder 中的 null 值方面与原始调用不同。除非静态排除,否则会为两者插入 null 检查。
清理
此时,持有类具有原始更新程序字段和新的偏移量字段,以及可能使用其中任何一个的调用站点。如果没有优化任何调用站点,则应移除偏移量字段;如果优化了所有调用站点,则应移除更新程序字段。在这两种情况下,初始化调用也应删除。编译器中已经完成了删除未使用的字段和移除无用代码的操作,但在此处移除初始化代码需要一些技巧。
对 newUpdater 和 getDeclaredField 的调用都可能会产生副作用,因为它们可能会抛出异常(并且它们的实现也是未知的,因为它取决于 API 版本)。这意味着,通过通用优化,无法安全地移除它们。因此,此清理需要明确考虑插桩字段,因为这些字段在静态上已知没有异常。
最后,上面显示的简单更新程序示例在优化后如下所示:
结果
经过这些优化后,kotlinx.atomicfu 和大多数显式使用 AtomicInt/Long/ReferenceFieldUpdater 的情况现在与应用 R8 后的 AtomicReference 性能相匹配。事实上,在某些基准中,它的速度甚至更快;kotlinx.atomicfu 有 一个编译器插件,可以将 atomic 实例内联到字段中,从而减少创建原子更新字段所需的分配。
Jetpack Compose 是这项工作的主要受益者。Compose 运行时有许多微基准,可以非常密切地跟踪协程性能,以便尽早发现性能下降问题。当基准更新到新版本的 R8 时,我们注意到在 LaunchedEffect 中启动和取消协程时,性能提升了 2 倍!
除此之外,ART 团队还在虚拟机级别以原生方式实现这些优化。如果您的应用以 API 36 为目标平台,并且在最新版本的 Android 上运行,则您的设备可能已经以类似的方式优化协程。在最新版本的 ART 中进行 JIT 更新后,上述协程基准的性能提升了约 15%。
升级到 AGP 9.2.0 或直接使用 R8 9.2.0 时,您的应用将默认接收此优化。如需了解详情,请参阅 D8 dexer 和 R8 缩减器。
-
 案例研究
WhatsApp 是全球最大的消息传递平台,为全球数十亿用户提供服务。它是不同地区人们的默认通信工具,通过私密、可靠且安全的消息传递方式连接用户。
Niharika Arora, Tracy Agyemang, Mayank Jain • 8 分钟阅读时间 -
 案例研究
Tinder 的使命是为新一代单身人士提供轻松有趣的交友体验,从而促进和激发真实的联系。
-
 案例研究
众所周知,性能下降问题很难重现,这使得性能下降成为移动开发者的巨大瓶颈。
每周通过电子邮件接收最新的 Android 开发洞见 每周。