Comment R8 a rendu les coroutines Kotlin sur Android deux fois plus rapides
Temps de lecture : 7 min
À partir d'AGP 9.2.0, R8 optimise la plupart des appels Atomic*FieldUpdater en variantes Unsafe qui offrent des performances deux à quatre fois supérieures pour les opérations courantes. Cela a un impact particulièrement important sur la bibliothèque kotlinx.atomicfu qui implémente les atomiques pour kotlinx.coroutines, ce qui permet de lancer et d'annuler les coroutines jusqu'à deux fois plus rapidement. Pour profiter de ces avantages, mettez à jour AGP vers la version 9.2.0 ou ultérieure.
La majorité des applications Android adoptant Kotlin comme langage principal, kotlinx.coroutines est devenu une norme de facto pour la programmation asynchrone. La bibliothèque offre un moyen bien conçu et structuré de gérer les flux simultanés, natif à Kotlin. Jetpack Compose n'a pas fait exception et a adopté les coroutines pour gérer les événements de pointeur, les animations et d'autres interactions. Au moment de la rédaction de cet article, la plupart des API simultanées de Compose appellent des fonctions suspend en arrière-plan et lancent et/ou annulent des coroutines pour gérer les mises à jour.
Lorsque l'équipe Compose a commencé à étudier les performances, elle a découvert que les coroutines étaient un goulot d'étranglement pour de nombreuses opérations qui se déroulent en dehors de la composition. Par exemple, 80% du temps passé à créer et à mettre à jour Modifier.clickable a été consommé par le lancement et l'annulation des coroutines internes qui géraient les mises à jour de InteractionSource. Sur la base de ces observations, une grande partie des premiers travaux sur les performances ont été axés sur la suppression des coroutines du chemin par défaut et sur le report de l'initialisation jusqu'à ce qu'elle soit nécessaire.
Coût d'une coroutine
Le moyen le plus simple d'analyser le comportement interne d'une fonction sur Android consiste à capturer une trace de méthode Android Runtime (ART). Un trace de méthode ART est un outil qui enregistre le flux d'exécution d'une application, en indiquant exactement les méthodes appelées, leur ordre et le temps passé dans chacune d'elles. Les développeurs peuvent ainsi identifier les goulots d'étranglement affectant les performances. Pour un appel LaunchedEffect { } vide, cela ressemblerait à ceci :
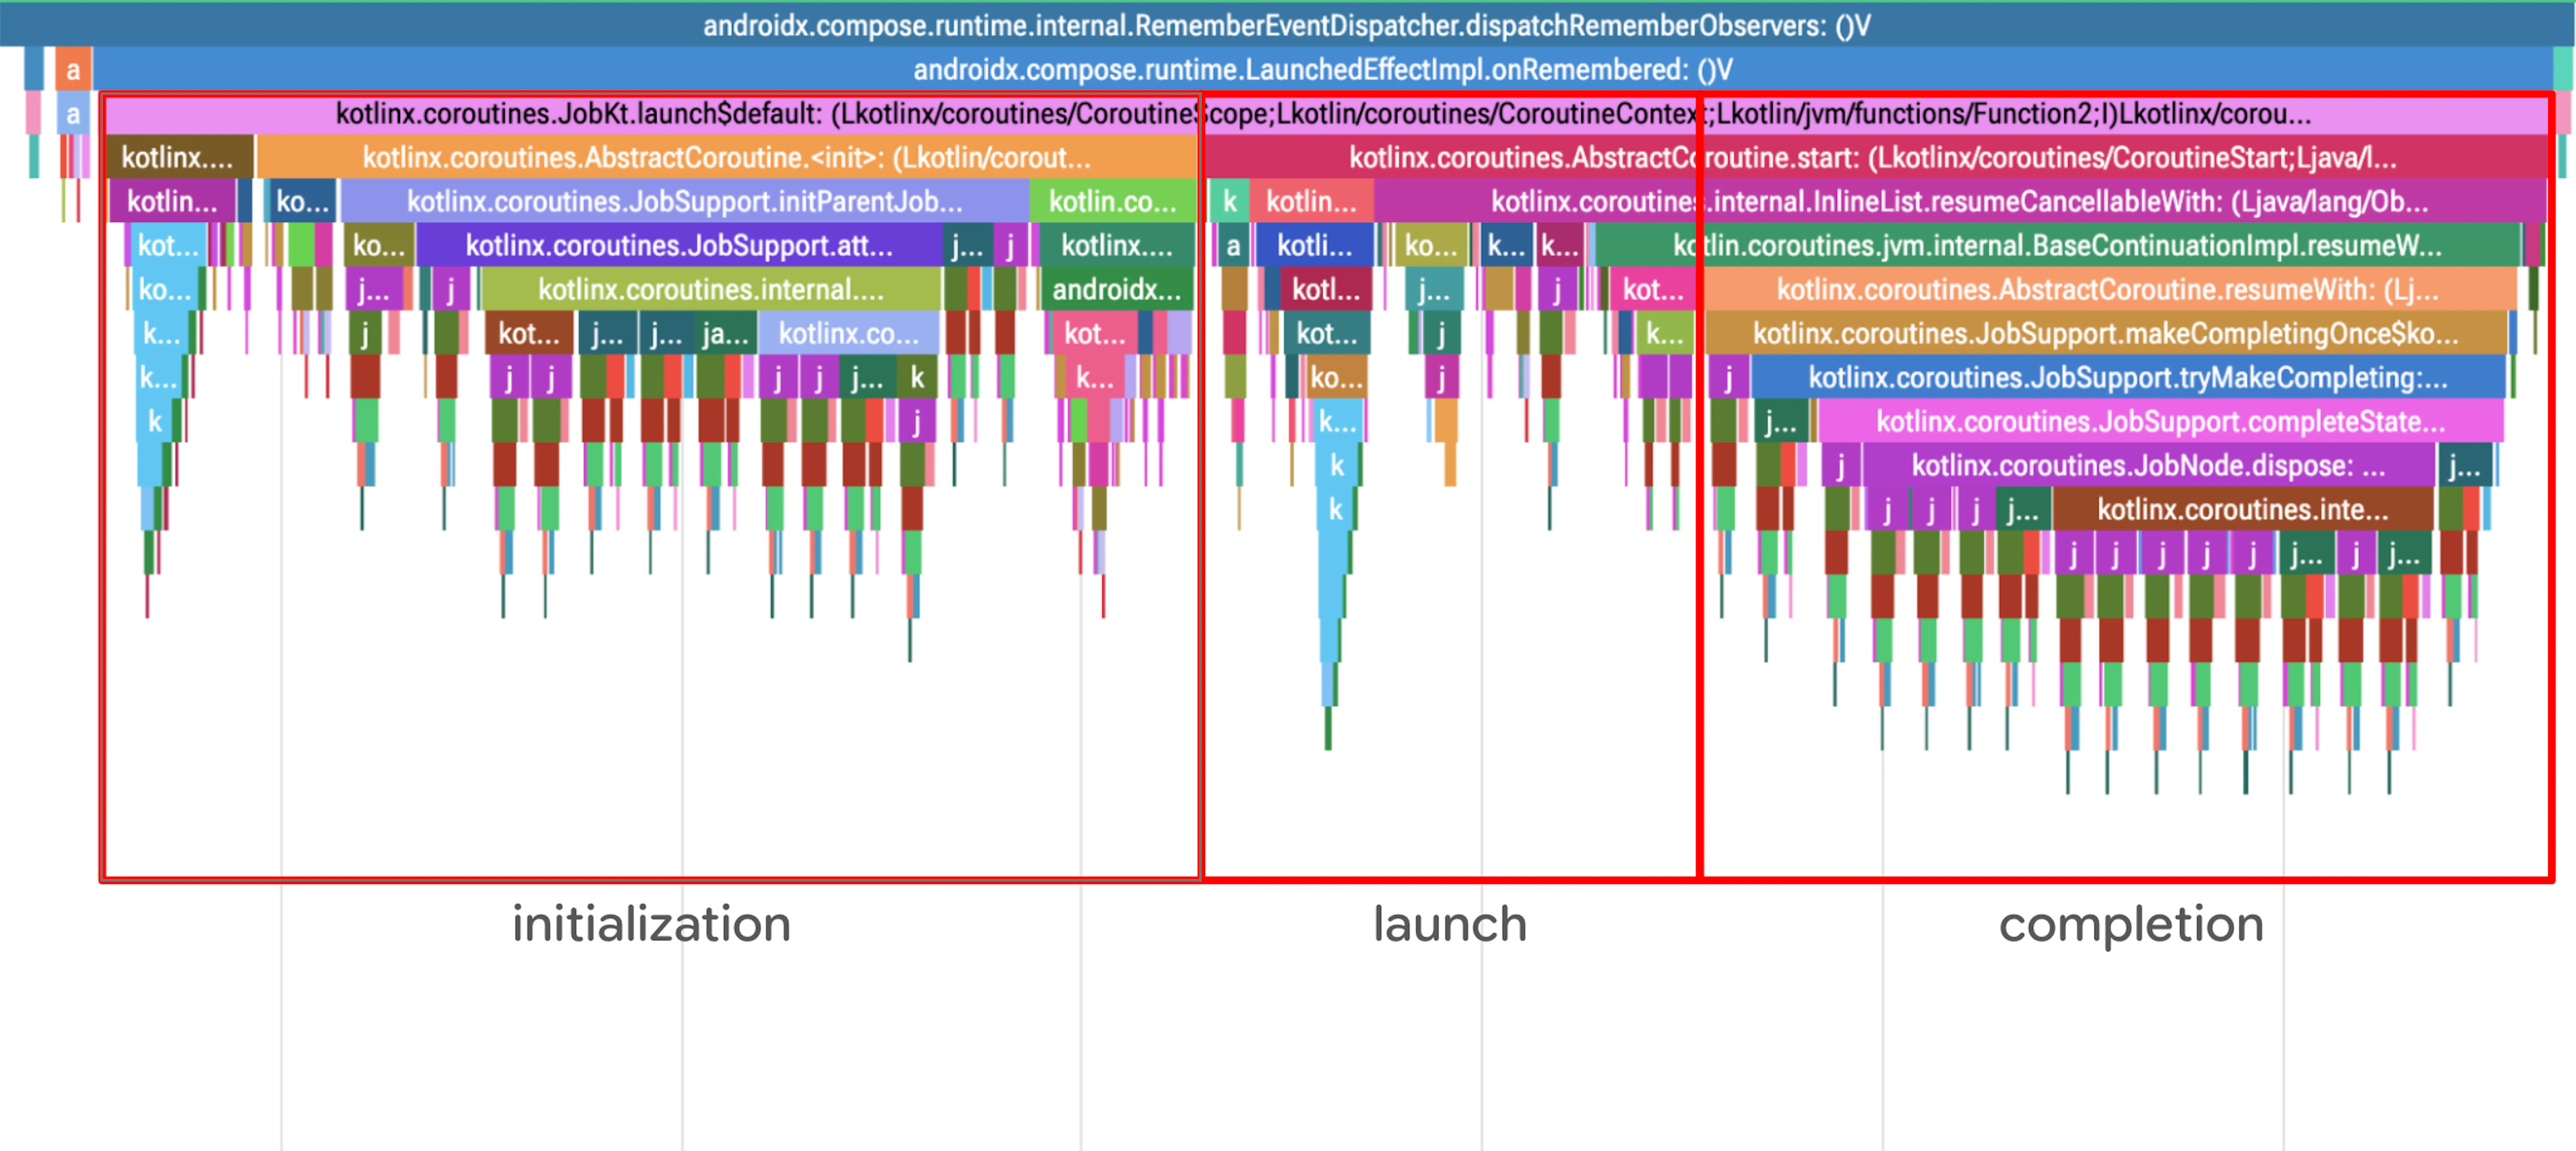
La trace de méthode ci-dessus peut être divisée en trois parties :
- Initialiser une nouvelle coroutine
- Démarrer une coroutine
- Fin de la coroutine (car elle se termine immédiatement)
L'annulation de LaunchedEffect est semblable à une finalisation normale, sauf qu'elle crée également un CancellationException.
Dans le profil ci-dessus, les appels fréquents à java.util.concurrent.AtomicReferenceFieldUpdater (cases violettes ou vertes avec des libellés commençant par "j…") sont immédiatement suspects. Bien que chaque appel soit relativement rapide, la fréquence est préoccupante. Toute surcharge non négligeable répartie sur plusieurs appels peut entraîner une régression notable. En zoomant sur un appel, on constate que la plupart du temps est consacrée aux vérifications de la réflexion.
Les coroutines implémentent une structure arborescente sans verrouillage pour les relations parent-enfant, ce qui permet la concurrence structurée. Il s'avère que la bibliothèque kotlinx.atomicfu implémente des opérations atomiques sans verrouillage à l'aide d'une primitive JVM bien connue, AtomicReferenceFieldUpdater. Le programme de mise à jour utilise une référence de classe et un nom de champ pour effectuer des opérations atomiques au moment de l'exécution. Il doit également exécuter plusieurs vérifications de sécurité par réflexion pour s'assurer que le champ existe et est accessible. Chaque opération dans les coroutines (démarrage, suspension, annulation, achèvement) appelle au moins une opération atomique. Par conséquent, si elle est lente, les coroutines ne fonctionneront pas bien.
Examiner AtomicReferenceFieldUpdater
Mais ne brûlons pas les étapes. AtomicReferenceFieldUpdater est en fait bien optimisé sur la JVM depuis plus de 10 ans. Les traces de méthode peuvent capturer une surcharge qui est complètement supprimée par une optimisation au niveau de la VM : les compilations juste à temps (JIT) ou anticipées (AOT). Pour vérifier les performances, écrivons quelques benchmarks afin de mesurer la différence entre les références atomiques de kotlinx.atomicfu et java.util.concurrent.atomic.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
L'exécution de ce benchmark sur un Pixel 5 (en s'assurant que AtomicReferenceFieldUpdater#compareAndSet est compilé JIT pendant l'échauffement) donne les résultats suivants sur un Pixel 5 (API 33) :
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
Les mesures confirment l'écart, la version kotlinx.atomicfu étant clairement environ 2,7 fois plus lente. Cela confirme qu'ART n'effectue aucune optimisation cachée et que les vérifications d'accès par réflexion ajoutent une surcharge réelle lors de l'exécution.
Si l'on revient à la trace de méthode d'origine, le seul travail significatif effectué par AtomicReferenceFieldUpdater est l'appel interne à Unsafe.getObjectVolatile, qui exécute réellement l'opération atomique sous-jacente. Dans la plupart des cas, l'initialiseur de mise à jour est statique et peut être prouvé comme étant toujours correct en fonction de la structure de la classe environnante. Il est donc possible d'analyser statiquement la plupart des utilisations de AtomicReferenceFieldUpdater et de les remplacer par une variante Unsafe interne lors de la compilation. Il se trouve que la chaîne d'outils de compilation Android possède son propre compilateur d'optimisation qui peut faire exactement cela.
Optimisation avec R8
Les classes Atomic*FieldUpdater permettent une utilisation subtile, dynamique et basée sur la réflexion, mais sont souvent utilisées dans des modèles statiquement évidents. Cela explique à la fois les performances de référence lentes et le besoin d'optimisation. R8 est un compilateur d'optimisation de programme complet qui est bien adapté pour identifier les modèles plus simples et réduire la surcharge des vérifications de sécurité par réflexion. R8 reçoit le bytecode JVM après le compilateur Java ou Kotlin, mais pour faciliter la lecture, ces exemples sont présentés dans la syntaxe Java. C'est pourquoi il n'y a pas d'arguments de type pour AtomicReferenceFieldUpdater.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
L'exemple de base crée un programme de mise à jour final statique qui accède à un champ volatile avec des arguments constants simples pour le détenteur, le type et le nom du champ. La réflexion utilisée est totalement transparente. Il est clair que ce programme de mise à jour fait référence à un champ valide et que le site de création du programme de mise à jour dispose d'un accès valide au champ.
Essentiellement, Atomic*FieldUpdater est un wrapper autour d'un décalage de champ et des appels à Unsafe. Dans le meilleur des cas, l'optimisation consiste à remplacer le champ de mise à jour par un champ de décalage et à remplacer les appels de mise à jour par des appels à Unsafe.
Optimiser Atomic*FieldUpdater
L'optimisation est implémentée en trois parties : instrumentation, remplacement et nettoyage.
Instrumentation
La première étape consiste à introduire des champs de décalage à côté du champ de mise à jour afin de faciliter l'accès direct via l'appel Unsafe .
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
Le champ est accessible par réflexion, et Unsafe est utilisé pour extraire le décalage du champ dans la classe. Ce code représente les éléments internes de Atomic*FieldUpdater si vous ne tenez pas compte de la validation de la réflexion. Au lieu de cela, le type de détenteur du programme de mise à jour et le type de champ du champ volatile sont suivis de manière statique dans le compilateur.
Notez que le champ d'origine et son initialisation sont laissés tels quels. Le processus d'optimisation facilite et optimise les utilisations de manière optimiste, puis nettoie. Il s'agit d'une approche simple de l'implémentation, mais elle permet également une optimisation partielle des champs de mise à jour, où certaines utilisations sont laissées telles quelles tandis que d'autres sont optimisées.
Remplacement
À ce stade du compilateur, après un point de jonction de simultanéité approprié, nous disposons d'une liste de champs de mise à jour instrumentés. Cela signifie que nous pouvons optimiser chaque site d'appel individuellement en fonction de quelques conditions. Prenons l'exemple d'un appel :
updater.compareAndSet(holder, expectedValue, newValue);
Voici les conditions requises par Atomic*FieldUpdater :
updaterprovient-il d'un champ instrumenté ? En d'autres termes, l'analyse statique peut-elle suivre la valeur de l'objet jusqu'à la lecture d'un champ d'un programme de mise à jour instrumenté ?holderest-elle la même classe ou une sous-classe du type de support défini à l'origine ?newValueest-elle la même classe ou une sous-classe du type de champ défini à l'origine ?
Si toutes les conditions sont remplies, l'appel est remplacé par un appel à Unsafe sans aucune vérification de la réflexion.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
Ce nouvel appel est plus rapide et plus simple, mais il diffère de l'appel d'origine en ce qui concerne la gestion des valeurs nulles dans updater et holder. Sauf si elles sont statiquement exclues, des vérifications de valeur nulle sont insérées pour les deux.
Effectuer un nettoyage
À ce stade, la classe de détention comporte le champ de mise à jour d'origine et le nouveau champ de décalage, ainsi que les sites d'appel qui peuvent utiliser l'un ou l'autre. Si aucun des sites d'appel n'a été optimisé, le champ de décalage doit être supprimé. Si tous les sites d'appel ont été optimisés, le champ de mise à jour doit être supprimé. Dans les deux cas, l'appel d'initialisation doit également être supprimé. La suppression des champs inutilisés et du code mort est déjà effectuée dans le compilateur, mais la suppression du code d'initialisation ici nécessite quelques astuces supplémentaires.
L'appel à newUpdater et à getDeclaredField peut avoir des effets secondaires, car il peut générer des exceptions (et son implémentation est également inconnue, car elle dépend de la version de l'API). Cela signifie qu'ils ne peuvent pas être supprimés de manière sécurisée par une optimisation générique. Ce nettoyage nécessitait donc un examen explicite des champs instrumentés, car ils sont statiquement connus pour être exempts d'exceptions.
À la fin, l'exemple de mise à jour simple présenté ci-dessus ressemble à ceci après optimisation :
Résultats
Après ces optimisations, kotlinx.atomicfu et la plupart des utilisations explicites de AtomicInt/Long/ReferenceFieldUpdater correspondent désormais aux performances de AtomicReference avec R8 appliqué. En fait, il est même plus rapide dans certains benchmarks ; kotlinx.atomicfu dispose d'un plug-in de compilation qui peut insérer des instances atomic dans des champs, ce qui réduit les allocations nécessaires pour créer un champ mis à jour de manière atomique.
Jetpack Compose a été le principal bénéficiaire de ce travail. Le runtime Compose comporte un certain nombre de microbenchmarks qui suivent de très près les performances des coroutines afin de détecter rapidement les régressions de performances. Lorsque les benchmarks ont été mis à jour vers une nouvelle version de R8, nous avons constaté une amélioration par deux lors du lancement et de l'annulation des coroutines dans LaunchedEffect.
En dehors de cela, l'équipe ART implémente ces optimisations de manière native au niveau de la VM. Si votre application cible l'API 36 et s'exécute sur une version récente d'Android, il est possible que votre appareil optimise déjà les coroutines de manière similaire. Les benchmarks de coroutines ci-dessus ont observé une amélioration des performances d'environ 15% après les mises à jour JIT dans les versions récentes d'ART.
Votre application bénéficiera de cette optimisation par défaut lorsque vous passerez à AGP 9.2.0 ou que vous utiliserez directement R8 9.2.0. Pour en savoir plus, consultez D8 dexer et R8 shrinker.
-
 Études de cas
L'équipe a créé un code de base d'UI natif de l'IA, 50% plus petit que l'implémentation d'origine. Elle a également réduit de 35% le temps d'exécution de l'agent d'IA, de 32% le nombre d'échanges entre l'ingénieur et l'agent, et de 33% le coût en jetons.
Pavlo Stavytskyi, Rebecca Franks • Temps de lecture : 11 min -
 Études de cas
WhatsApp est la plus grande plate-forme de messagerie au monde, avec des milliards d'utilisateurs dans le monde entier. Il s'agit de l'outil de communication par défaut pour les utilisateurs de différentes régions, qui leur permet de communiquer de manière privée, fiable et sécurisée.
Niharika Arora, Tracy Agyemang, Mayank Jain • Temps de lecture : 8 min -
 Études de cas
La mission de Tinder est de favoriser et d'inspirer des relations authentiques en permettant à chaque nouvelle génération de célibataires de se rencontrer facilement et de s'amuser.
Ajesh Pai, Ulises Uriel Verduzco Díaz , Tracy Agyemang • Temps de lecture : 4 min
Recevez chaque semaine les dernières informations sur le développement Android directement dans votre boîte de réception.