Начиная с AGP 9.2.0, R8 оптимизирует большинство вызовов Atomic*FieldUpdater, преобразуя их в небезопасные варианты, которые обеспечивают в 2-4 раза более высокую производительность при выполнении распространенных операций . Это особенно сильно влияет на библиотеку kotlinx.atomicfu, которая реализует атомарные операции для kotlinx.coroutines , ускоряя запуск и отмену сопрограмм до 2 раз. Чтобы воспользоваться преимуществами, обновите AGP до версии 9.2.0 или выше.
With the majority of Android apps adopting Kotlin as their main language of choice, kotlinx.coroutines has become a de-facto standard for asynchronous programming. The library offers a well-designed and structured way of managing concurrent flows that is native to Kotlin. Jetpack Compose was no exception, adopting coroutines for managing pointer events, animations and other interactions. At the time of writing, most concurrent APIs in Compose call suspend functions under the hood and are launching and/or cancelling coroutines to handle updates.
As the Compose team started to investigate performance, coroutines were discovered to be a bottleneck for many operations that happen outside of composition. As an example, 80% of the time spent on creating and updating Modifier.clickable was consumed by launching and cancelling internal coroutines that handled InteractionSource updates. Based on those observations, much of early performance work was focused on removing coroutines from the default path and delaying initialization until necessary.
Стоимость сопрограммы
The easiest way to analyze a function's internal behavior on Android is to capture an Android Runtime (ART) method trace. An ART method trace is a tool that records the execution flow of an app, showing exactly which methods are called, their order, and how much time is spent in each, allowing developers to identify performance bottlenecks. For an empty LaunchedEffect { } call, it would look something like this:
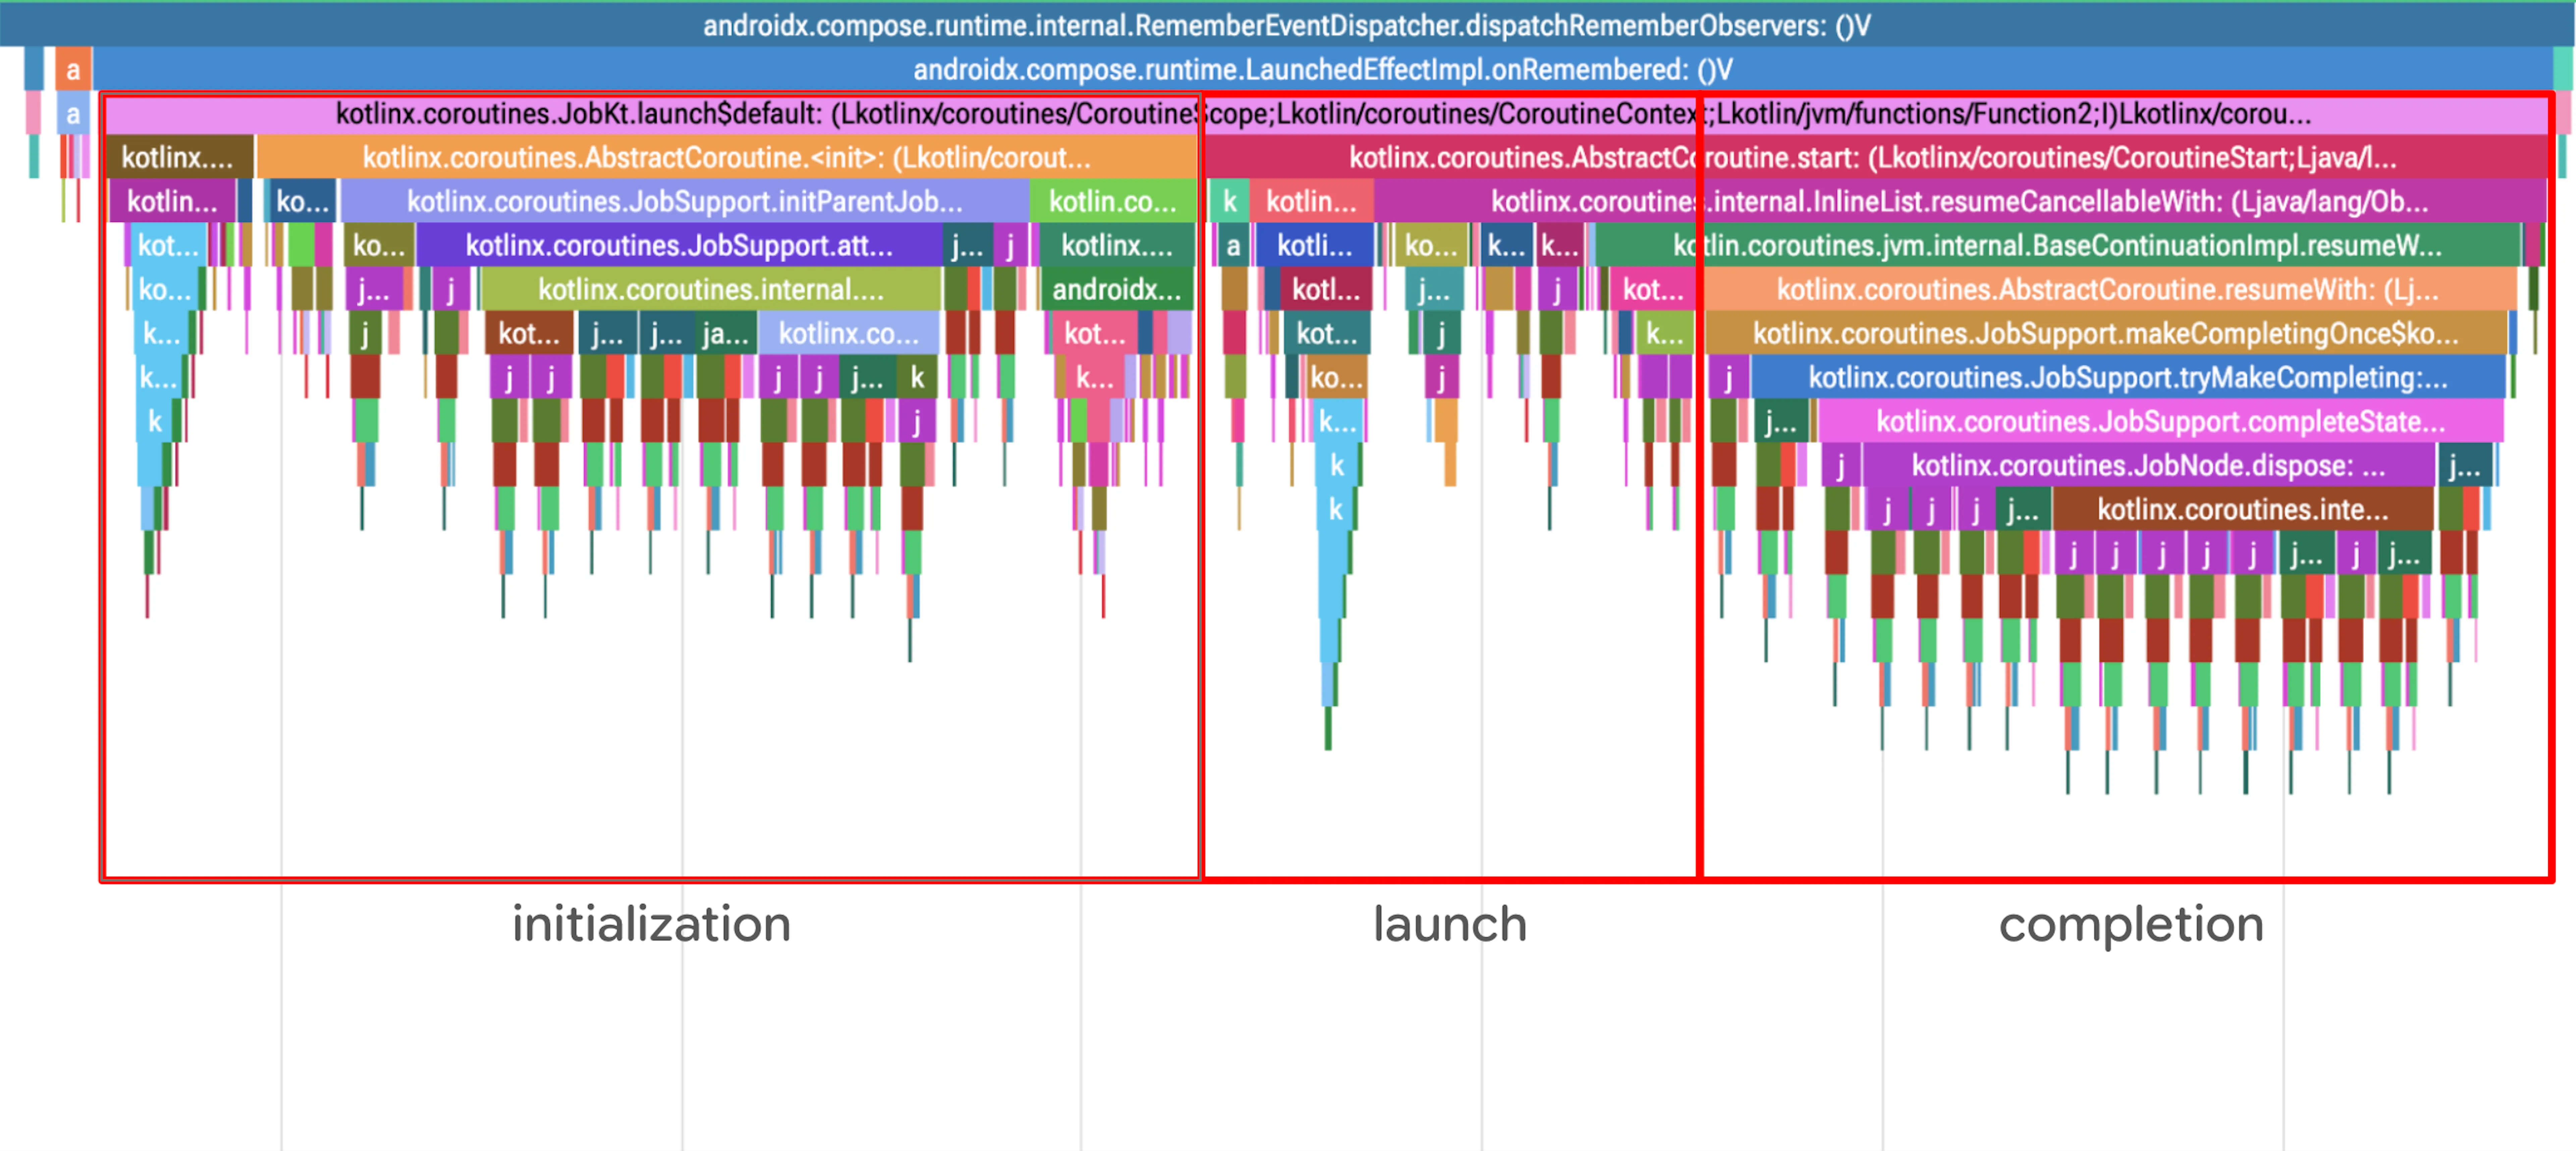
Приведенный выше трассировочный вывод можно разделить на три части:
- Инициализация новой сопрограммы
- Запуск сопрограммы
- Завершение сопрограммы (поскольку она немедленно завершается)
Отмена LaunchedEffect аналогична обычному завершению, за исключением того, что при этом также создается исключение CancellationException .
From the profile above, one thing that is immediately suspicious is frequent calls into java.util.concurrent.AtomicReferenceFieldUpdater (purple or green boxes with j… labels). While each call is relatively fast, the frequency is concerning; any non-negligible overhead that is spread out across multiple invocations might add up to a noticeable regression. Zooming in on a call reveals that most of the time is spent on... reflection checks?
Coroutines implement a lock-free tree structure for parent-child relationships that makes structured concurrency possible. Turns out, the kotlinx.atomicfu library implements lock-free atomic operations using a well-known JVM primitive, AtomicReferenceFieldUpdater . The updater uses a class reference and a field name to perform atomic operations at runtime, and it has to run several reflective safety checks to make sure the field exists and is accessible. Each operation in coroutines (starting, suspending, cancelling, completing) calls at least one atomic operation, so if it is slow, coroutines will not perform well.
Исследование AtomicReferenceFieldUpdater
But let's not get ahead of ourselves. AtomicReferenceFieldUpdater is actually well-optimized on JVM for over 10 years now , and method traces might capture overhead that is completely removed by a VM level optimization: just-in-time (JIT) or ahead-of-time (AOT) compilations. To verify performance, let's write a few benchmarks to measure the difference between atomic references from kotlinx.atomicfu and java.util.concurrent.atomic .
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
Запуск этого бенчмарка на Pixel 5 (при условии, что AtomicReferenceFieldUpdater#compareAndSet компилируется JIT-компилятором во время предварительной обработки) дает следующие результаты на Pixel 5 (API 33):
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
Измерения подтверждают разницу: версия kotlinx.atomicfu явно примерно в 2,7 раза медленнее. Это подтверждает, что ART не выполняет никаких скрытых оптимизаций, а рефлексивные проверки доступа добавляют реальные накладные расходы во время выполнения.
Looking back at the original method trace, the only meaningful work performed by the AtomicReferenceFieldUpdater is the internal call into Unsafe.getObjectVolatile that actually executes the underlying atomic operation. In most cases, the updater initializer is static, and can be proved to be always correct based on the structure of the surrounding class. Thus, one could statically analyze most of the AtomicReferenceFieldUpdater usages and replace them with an internal Unsafe variant during compilation. It also just happens that Android build toolchain has its very own optimizing compiler that can do exactly that.
Оптимизация с помощью R8
Классы Atomic*FieldUpdater поддерживают тонкое, динамическое и основанное на рефлексии использование, но часто применяются в статически очевидных шаблонах. Это объясняет как низкую базовую производительность, так и необходимость оптимизации. R8 — это компилятор, оптимизирующий всю программу, и он хорошо подходит для выявления более простых шаблонов, чтобы избежать накладных расходов на проверки безопасности с помощью рефлексии. R8 получает байт-код JVM после компилятора Java или Kotlin, но для облегчения читаемости эти примеры представлены в синтаксисе Java. Именно поэтому у класса AtomicReferenceFieldUpdater нет аргументов типа.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
В базовом примере создается статический конечный обновлятор, который обращается к полю с переменным значением типа volatile, используя простые константные аргументы для владельца, типа и имени поля. Используемая рефлексия полностью прозрачна. Ясно видно, что этот обновлятор ссылается на допустимое поле и что место создания обновлятора имеет допустимый доступ к этому полю.
По сути, Atomic*FieldUpdater — это обертка над смещением поля и вызовами Unsafe . Наилучший вариант оптимизации — заменить поле обновления полем смещения, а вызовы обновления — вызовами Unsafe .
Оптимизация Atomic*FieldUpdater
Оптимизация осуществляется в три этапа: инструментарий, замена и очистка.
Приборы
Первым шагом является добавление полей смещения (offset) рядом с полем обновления (updater), чтобы обеспечить прямой доступ через вызов Unsafe .
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
Доступ к полю осуществляется через рефлексию, а Unsafe используется для извлечения смещения поля в классе. Этот код представляет собой внутреннее устройство Atomic*FieldUpdater если не учитывать проверку с помощью рефлексии. Вместо этого тип держателя обновляющего объекта и тип поля volatile отслеживаются статически в компиляторе.
Обратите внимание, что исходное поле и его инициализация остаются без изменений. Процесс оптимизации оптимистично упрощает и оптимизирует использование, а затем выполняет очистку. Это простой подход к реализации, но он также позволяет частично оптимизировать поля обновления, где некоторые варианты использования остаются без изменений, а другие оптимизируются.
Замена
На этом этапе компиляции, после подходящей точки соединения для параллельного выполнения, у нас есть список инструментированных полей обновления. Это означает, что мы можем оптимизировать каждый вызов индивидуально на основе нескольких условий. Рассмотрим пример вызова:
updater.compareAndSet(holder, expectedValue, newValue);
Для работы Atomic*FieldUpdater необходимы следующие условия:
- Получается ли
updaterиз инструментированного поля? То есть, может ли статический анализ отследить значение объекта до поля, прочитанного из инструментированного объекта обновления? - Является ли
holderтем же классом или подклассом первоначально определенного типа владельца? - Является ли
newValueтем же классом или подклассом исходного типа поля?
Если все условия выполнены, то вызов заменяется вызовом в Unsafe без каких-либо проверок на отражение.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
Новый вызов быстрее и проще, но отличается от исходного вызова обработкой нулевых значений в updater и holder . Если статически не исключено, проверка на нулевые значения выполняется для обоих методов.
Уборка
At this point, the holding class has the original updater field and the new offset field along with call sites that might use either one of the two. If none of the call sites were optimized, then the offset field should be removed and if all of the call sites were optimized, then the updater field should be removed. In both cases the initializing call should also be deleted. The deletion of unused fields and removal of dead code is already done in the compiler, but removing the initializing code here requires a few more tricks.
Both the call to newUpdater and getDeclaredField might have side effects as they can throw exceptions (and their implementation is also unknown since it depends on the API version). This means that by generic optimization, they cannot safely be removed. So this clean-up required explicit consideration of the instrumented fields, since those are statically known to be free of exceptions.
В итоге, после оптимизации, простой пример обновления, показанный выше, выглядит следующим образом:
Результаты
После этих оптимизаций kotlinx.atomicfu и большинство случаев явного использования AtomicInt/Long/ReferenceFieldUpdater теперь соответствуют производительности AtomicReference с применением R8. Фактически, в некоторых тестах он даже быстрее; kotlinx.atomicfu имеет плагин компилятора , который может встраивать atomic экземпляры в поля, уменьшая количество выделений памяти, необходимых для создания атомарно обновляемого поля.
Главным бенефициаром этой работы стал Jetpack Compose. В среде выполнения Compose есть ряд микротестов, которые очень внимательно отслеживают производительность сопрограмм, чтобы выявлять регрессии производительности на ранних стадиях. После обновления тестов до новой версии R8 мы заметили двукратное улучшение при запуске и отмене сопрограмм в LaunchedEffect !
Помимо этого, команда ART внедряет эти оптимизации на уровне виртуальной машины. Если ваше приложение ориентировано на API 36 и работает на последней версии Android, возможно, ваше устройство уже оптимизирует сопрограммы аналогичным образом. Приведенные выше тесты производительности сопрограмм показали улучшение примерно на 15% после обновлений JIT в последних версиях ART.
Ваше приложение получит эту оптимизацию по умолчанию при обновлении до AGP 9.2.0 или при непосредственном использовании R8 9.2.0. Для получения дополнительной информации см. D8 dexer и R8 shrinker .
 Примеры из практики
Команда разработала собственный код пользовательского интерфейса для ИИ, который на 50% меньше оригинальной реализации, при этом добившись сокращения времени выполнения ИИ-агента на 35%, уменьшения количества обменов данными между инженером и агентом на 32% и снижения стоимости токенов на 33%.
Pavlo Stavytskyi , Rebecca Franks • Чтение 11 мин. Примеры из практики
WhatsApp — крупнейшая в мире платформа для обмена сообщениями, которой пользуются миллиарды людей по всему миру. Это основной инструмент общения для людей из разных регионов, соединяющий пользователей посредством приватного, надежного и безопасного обмена сообщениями.
Niharika Arora , Tracy Agyemang , Mayank Jain • Чтение 8 минут Примеры из практики
Миссия Tinder — способствовать установлению и развитию настоящих связей, делая знакомства простыми и увлекательными для каждого нового поколения одиноких людей.
Ajesh Pai , Ulises Uriel Verduzco Díaz , Tracy Agyemang • Чтение 4 минуты
Получайте еженедельно самые свежие новости о разработке Android прямо на свою электронную почту.