En Android 17, las apps orientadas al SDK 37 o versiones posteriores recibirán una nueva implementación de MessageQueue en la que la implementación no tiene bloqueos. La nueva implementación mejora el rendimiento y reduce los fotogramas perdidos, pero puede romper los clientes que reflejan los campos y métodos privados de MessageQueue. Para obtener más información sobre el cambio de comportamiento y cómo puedes mitigar el impacto, consulta la documentación sobre el cambio de comportamiento de MessageQueue. En esta entrada de blog técnica, se proporciona una descripción general de la rediseño de la arquitectura de MessageQueue y cómo puedes analizar los problemas de contención de bloqueos con Perfetto.
El Looper controla el subproceso de IU de cada aplicación para Android. Extrae el trabajo de una MessageQueue, lo envía a un Handler y repite el proceso. Durante dos décadas, MessageQueue usó un solo bloqueo de monitor (es decir, un bloque de código synchronized) para proteger su estado.
Android 17 presenta una actualización significativa de este componente: una implementación sin bloqueos llamada DeliQueue.
En esta publicación, se explica cómo los bloqueos afectan el rendimiento de la IU, cómo analizar estos problemas con Perfetto y los algoritmos y las optimizaciones específicos que se usan para mejorar el subproceso principal de Android.
El problema: Contención de bloqueo e inversión de prioridad
La MessageQueue heredada funcionaba como una cola de prioridad protegida por un solo bloqueo. Si un subproceso en segundo plano publica un mensaje mientras el subproceso principal realiza el mantenimiento de la cola, el subproceso en segundo plano bloquea el subproceso principal.
Cuando dos o más subprocesos compiten por el uso exclusivo del mismo bloqueo, se denomina contención de bloqueo. Esta contención puede causar una inversión de prioridad, lo que genera bloqueos de IU y otros problemas de rendimiento.
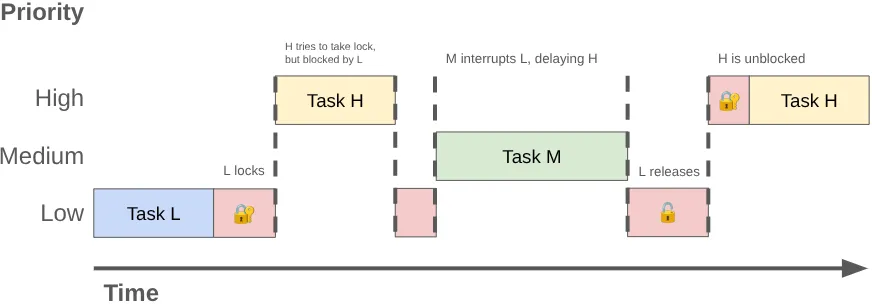
La inversión de prioridades puede ocurrir cuando un subproceso de alta prioridad (como el subproceso de IU) se ve obligado a esperar a un subproceso de baja prioridad. Considera esta secuencia:
- Un subproceso en segundo plano de baja prioridad adquiere el bloqueo
MessageQueuepara publicar el resultado del trabajo que realizó. - Un subproceso de prioridad media se vuelve ejecutable y el programador del kernel le asigna tiempo de CPU, lo que interrumpe el subproceso de prioridad baja.
- El subproceso de IU de alta prioridad finaliza su tarea actual y, luego, intenta leer de la cola, pero se bloquea porque el subproceso de baja prioridad mantiene el bloqueo.
El subproceso de prioridad baja bloquea el subproceso de IU, y el trabajo de prioridad media lo retrasa aún más.
Cómo analizar la contención con Perfetto
Puedes diagnosticar estos problemas con Perfetto. En un registro estándar, un subproceso bloqueado en un bloqueo de monitor entra en el estado de suspensión, y Perfetto muestra un segmento que indica el propietario del bloqueo.
Cuando consultes datos de seguimiento, busca porciones llamadas “monitor contention with…” seguidas del nombre del subproceso que posee el bloqueo y el sitio de código donde se adquirió el bloqueo.
Caso de éxito: Latencia del selector
Para ilustrar esto, analicemos un seguimiento en el que un usuario experimentó un jank mientras navegaba a la pantalla principal en un teléfono Pixel inmediatamente después de tomar una foto en la app de la cámara. A continuación, vemos una captura de pantalla de Perfetto que muestra los eventos que llevaron al fotograma perdido:
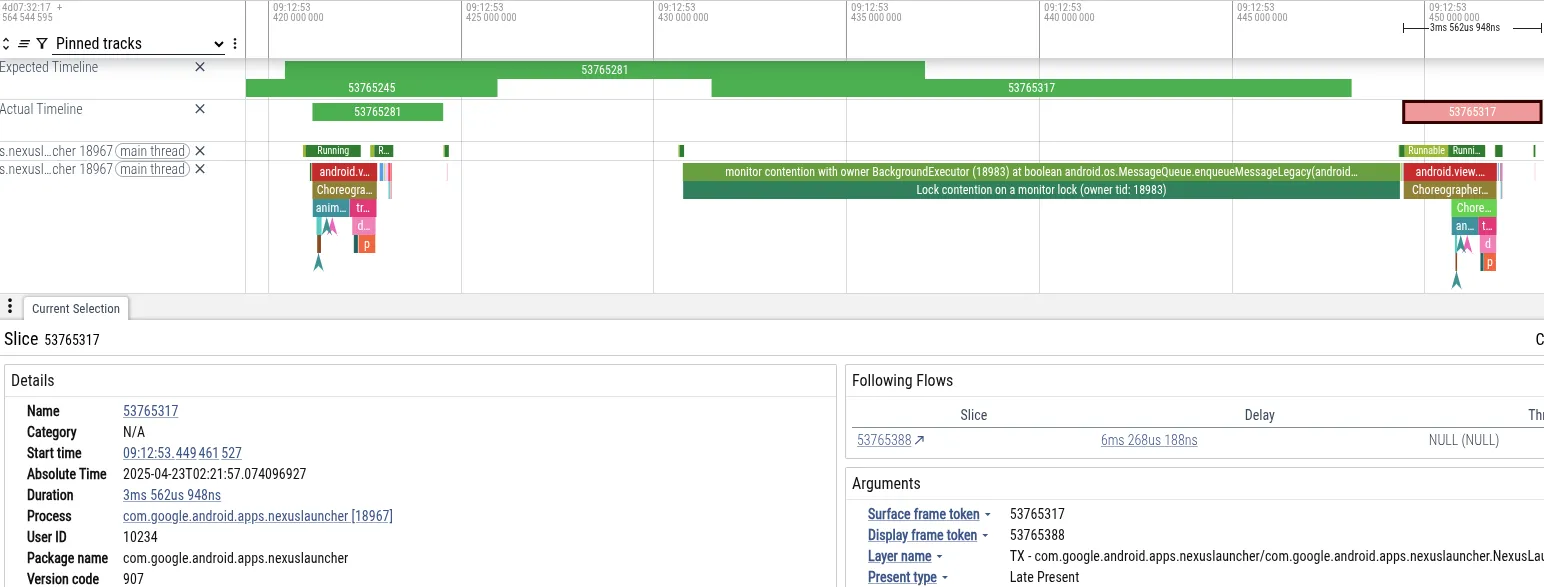
- Síntoma: El subproceso principal del Selector no cumplió con el plazo del fotograma. Se bloqueó durante 18 ms, lo que supera el plazo de 16 ms necesario para la renderización de 60 Hz.
- Diagnóstico: Perfetto mostró que el subproceso principal estaba bloqueado en el bloqueo
MessageQueue. Un subproceso “BackgroundExecutor” era el propietario del bloqueo. - Causa raíz: BackgroundExecutor se ejecuta en Process.THREAD_PRIORITY_BACKGROUND (prioridad muy baja). Realizó una tarea no urgente (verificar los límites de uso de la app). Simultáneamente, los subprocesos de prioridad media usaban tiempo de CPU para procesar datos de la cámara. El programador del SO interrumpió el subproceso de BackgroundExecutor para ejecutar los subprocesos de la cámara.
Esta secuencia provocó que el subproceso de IU del Launcher (prioridad alta) se bloqueara de forma indirecta por el subproceso de trabajo de la cámara (prioridad media), lo que impedía que el subproceso en segundo plano del Launcher (prioridad baja) liberara el bloqueo.
Cómo consultar seguimientos con PerfettoSQL
Puedes usar PerfettoSQL para consultar datos de seguimiento en busca de patrones específicos. Esto es útil si tienes un gran banco de seguimientos de dispositivos o pruebas de usuarios, y buscas seguimientos específicos que demuestren un problema.
Por ejemplo, esta consulta encuentra la contención de MessageQueue que coincide con los fotogramas perdidos (jank):
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
En este ejemplo más complejo, une los datos de seguimiento que abarcan varias tablas para identificar la contención de MessageQueue durante el inicio de la app:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
Puedes usar tu LLM favorito para escribir consultas de PerfettoSQL y encontrar otros patrones.
En Google, usamos BigTrace para ejecutar consultas de PerfettoSQL en millones de seguimientos. De esta manera, confirmamos que lo que vimos de forma anecdótica era, de hecho, un problema sistémico. Los datos revelaron que la contención de bloqueos de MessageQueue afecta a los usuarios de todo el ecosistema, lo que justifica la necesidad de un cambio de arquitectura fundamental.
Solución: Simultaneidad sin bloqueos
Abordamos el problema de contención de MessageQueue implementando una estructura de datos sin bloqueos, usando operaciones de memoria atómicas en lugar de bloqueos exclusivos para sincronizar el acceso al estado compartido. Una estructura de datos o un algoritmo no tiene bloqueos si al menos un subproceso siempre puede avanzar, independientemente del comportamiento de programación de los otros subprocesos. Por lo general, esta propiedad es difícil de lograr y no suele valer la pena para la mayoría de los códigos.
Primitivas atómicas
El software sin bloqueos suele depender de primitivas atómicas de lectura, modificación y escritura que proporciona el hardware.
En las CPUs ARM64 de generaciones anteriores, las operaciones atómicas usaban un bucle de carga vinculada/almacenamiento condicional (LL/SC). La CPU carga un valor y marca la dirección. Si otro subproceso escribe en esa dirección, el almacenamiento falla y el bucle vuelve a intentarlo. Debido a que los subprocesos pueden seguir intentando y tener éxito sin esperar a otro subproceso, esta operación no tiene bloqueos.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retrLas arquitecturas ARM más recientes (ARMv8.1) admiten extensiones de sistemas grandes (LSE), que incluyen instrucciones en forma de comparación y cambio (CAS) o carga y adición (se muestra a continuación). En Android 17, agregamos compatibilidad con el compilador de Android Runtime (ART) para detectar cuándo se admite la LSE y emitir instrucciones optimizadas:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
En nuestras comparativas, el código de alta contención que usa CAS logra una aceleración de ~3 veces en comparación con la variante LL/SC.
El lenguaje de programación Java ofrece primitivas atómicas a través de java.util.concurrent.atomic que se basan en estas y otras instrucciones de CPU especializadas.
La estructura de datos: DeliQueue
Para quitar la contención de bloqueo de MessageQueue, nuestros ingenieros diseñaron una nueva estructura de datos llamada DeliQueue. DeliQueue separa la inserción de Message del procesamiento de Message:
- La lista de
Messages(pila de Treiber): Es una pila sin bloqueos. Cualquier subproceso puede enviar unMessagesnuevo aquí sin contención. - La cola de prioridad (montículo mínimo): Es un montículo de
Messagespara controlar, que pertenece exclusivamente al subproceso de Looper (por lo tanto, no se necesitan sincronizaciones ni bloqueos para acceder).
Enqueue: pushing to a Treiber stack
La lista de Messages se mantiene en una pila de Treiber [1], una pila sin bloqueos que usa un bucle de CAS para actualizar el puntero de encabezado.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
Código fuente basado en Java Concurrency in Practice [2], disponible en línea y publicado en el dominio público
Cualquier productor puede enviar nuevos Message a la pila en cualquier momento. Esto es como sacar un número en un mostrador de fiambrería: tu número se determina según el momento en que llegaste, pero el orden en que recibes la comida no tiene por qué coincidir. Como es una pila vinculada, cada Message es una pila secundaria. Puedes ver cómo era la cola de Message en cualquier momento haciendo un seguimiento del encabezado y realizando iteraciones hacia adelante. No verás ningún Message nuevo que se haya agregado en la parte superior, incluso si se agrega durante el recorrido.
Cómo quitar de la cola: Transferencia masiva a un montón mínimo
Para encontrar el siguiente Message que debe controlar, el Looper procesa los nuevos Message de la pila de Treiber recorriendo la pila desde la parte superior y realizando iteraciones hasta encontrar el último Message que procesó anteriormente. A medida que el Looper recorre la pila, inserta Message en el montón mínimo ordenado por fecha límite. Dado que el Looper es el propietario exclusivo del montón, ordena y procesa Message sin bloqueos ni operaciones atómicas.
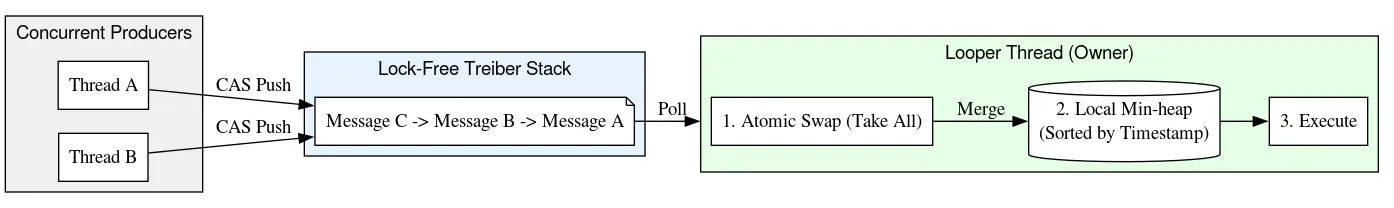
Al recorrer la pila, Looper también crea vínculos desde los Message apilados hacia sus predecesores, lo que forma una lista doblemente vinculada. Crear la lista vinculada es seguro porque los vínculos que apuntan hacia abajo en la pila se agregan a través del algoritmo de pila de Treiber con CAS, y los vínculos que apuntan hacia arriba en la pila solo los lee y modifica el subproceso Looper. Luego, estos vínculos de retroceso se usan para quitar Message de puntos arbitrarios de la pila en un tiempo O(1).
Este diseño proporciona una inserción O(1) para los productores (subprocesos que publican trabajo en la cola) y un procesamiento O(log N) amortizado para el consumidor (el Looper).
El uso de un min-heap para ordenar Message también aborda una falla fundamental en el MessageQueue heredado, en el que Message se mantenían en una lista vinculada de forma individual (con raíz en la parte superior). En la implementación heredada, la eliminación del encabezado era O(1), pero la inserción tenía un peor caso de O(N), lo que escalaba de forma deficiente para las colas sobrecargadas. Por el contrario, la inserción y la eliminación del montón mínimo se escalan de forma logarítmica, lo que ofrece un rendimiento promedio competitivo, pero se destaca en las latencias de cola.
Heredada (bloqueada) MessageQueue | DeliQueue | |
| Insertar | O(N) | O(1) para el subproceso de llamada O(logN) para el subproceso |
| Quitar de la cabeza | O(1) | O(logN) |
En la implementación de la cola heredada, los productores y el consumidor usaban un bloqueo para coordinar el acceso exclusivo a la lista vinculada de forma única subyacente. En DeliQueue, la pila de Treiber controla el acceso simultáneo, y el consumidor único controla el orden de su cola de trabajo.
Eliminación: Coherencia a través de lápidas
DeliQueue es una estructura de datos híbrida que une una pila de Treiber sin bloqueos con un min-heap de un solo subproceso. Mantener estas dos estructuras sincronizadas sin un bloqueo global presenta un desafío único: un mensaje puede estar físicamente presente en la pila, pero lógicamente quitado de la cola.
Para resolver esto, DeliQueue usa una técnica llamada “tombstoning”. Cada Message hace un seguimiento de su posición en la pila a través de los punteros hacia atrás y hacia adelante, su índice en el array del montón y una marca booleana que indica si se quitó. Cuando un Message está listo para ejecutarse, el subproceso Looper realizará una operación CAS en su marca de quitado y, luego, lo quitará del montón y de la pila.
Cuando otro subproceso necesita quitar un Message, no lo extrae de inmediato de la estructura de datos. En cambio, realiza los siguientes pasos:
- Eliminación lógica: El subproceso usa una CAS para establecer de forma atómica la marca de eliminación del
Messagede falso a verdadero. ElMessagepermanece en la estructura de datos como evidencia de su eliminación pendiente, lo que se conoce como “tombstone”. Una vez que se marca unMessagepara su eliminación, DeliQueue lo trata como si ya no existiera en la cola cada vez que se encuentra. - Limpieza diferida: La eliminación real de la estructura de datos es responsabilidad del subproceso
Loopery se difiere para más adelante. En lugar de modificar la pila o el montón, el subproceso de eliminación agrega elMessagea otra pila de lista libre sin bloqueo. - Eliminación estructural: Solo el
Looperpuede interactuar con el montón o quitar elementos de la pila. Cuando se activa, borra la lista libre y procesa losMessageque contenía. Luego, cadaMessagese desvincula de la pila y se quita del montón.
Este enfoque mantiene toda la administración del montón en un solo subproceso. Minimiza la cantidad de operaciones simultáneas y barreras de memoria necesarias, lo que hace que la ruta crítica sea más rápida y sencilla.
Recorrido: Condiciones de carrera de datos benignas del modelo de memoria de Java
La mayoría de las APIs de simultaneidad, como Future en la biblioteca estándar de Java, o Job y Deferred de Kotlin, incluyen un mecanismo para cancelar el trabajo antes de que se complete. Una instancia de una de estas clases coincide 1:1 con una unidad de trabajo subyacente, y llamar a cancel en un objeto cancela las operaciones específicas asociadas con ellas.
Los dispositivos Android actuales tienen CPUs de varios núcleos y un recolector generacional de elementos no utilizados simultáneo. Sin embargo, cuando se desarrolló Android por primera vez, era demasiado costoso asignar un objeto para cada unidad de trabajo. Por lo tanto, el Handler de Android admite la cancelación a través de numerosas sobrecargas de removeMessages. En lugar de quitar un Message específico, quita todos los Message que coincidan con los criterios especificados. En la práctica, esto requiere iterar por todos los Message insertados antes de que se llamara a removeMessages y quitar los que coincidan.
Cuando se itera hacia adelante, un subproceso solo requiere una operación atómica ordenada para leer el encabezado actual de la pila. Después de eso, se usan lecturas de campo comunes para encontrar el siguiente Message. Si el subproceso Looper modifica los campos next mientras quita Message, la escritura de Looper y la lectura de otro subproceso no están sincronizadas, lo que constituye una condición de carrera de datos. Normalmente, una carrera de datos es un error grave que puede causar problemas enormes en tu app, como filtraciones, bucles infinitos, fallas, bloqueos y mucho más. Sin embargo, en ciertas condiciones limitadas, las condiciones de carrera de datos pueden ser benignas dentro del modelo de memoria de Java. Supongamos que comenzamos con una pila de:

Realizamos una lectura atómica de la cabeza y vemos A. El puntero next de A apunta a B. Al mismo tiempo que procesamos B, el looper podría quitar B y C, actualizando A para que apunte a C y, luego, a D.
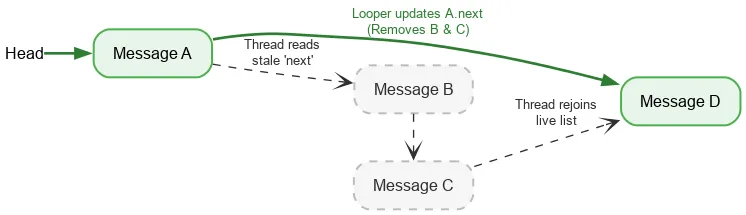
Aunque B y C se quitan lógicamente, B conserva su siguiente puntero a C, y C a D. El subproceso de lectura sigue recorriendo los nodos quitados desconectados y, finalmente, se vuelve a unir a la pila activa en D.
Si diseñamos DeliQueue para que controle las carreras entre el recorrido y la eliminación, permitimos una iteración segura y sin bloqueos.
Quitting: Native refcount
Looper está respaldado por una asignación nativa que se debe liberar de forma manual una vez que se haya cerrado Looper. Si algún otro subproceso agrega Message mientras se cierra Looper, podría usar la asignación nativa después de que se libere, lo que constituye un incumplimiento de la seguridad de la memoria. Para evitarlo, usamos un recuento de referencias etiquetado, en el que se usa un bit del elemento atómico para indicar si se está cerrando el Looper.
Antes de usar la asignación nativa, un subproceso lee el valor atómico de refcount. Si se establece el bit de salida, se muestra que el Looper está saliendo y no se debe usar la asignación nativa. De lo contrario, intenta un CAS para incrementar la cantidad de subprocesos activos con la asignación nativa. Después de hacer lo que necesita, disminuye el recuento. Si el bit de salida se configuró después de su incremento, pero antes de la disminución, y el recuento ahora es cero, se activa el subproceso Looper.
Cuando el subproceso Looper está listo para salir, usa CAS para establecer el bit de salida en el elemento atómico. Si el recuento de referencias era 0, puede proceder a liberar su asignación nativa. De lo contrario, se estaciona, sabiendo que se activará cuando el último usuario de la asignación nativa disminuya el recuento de referencias. Este enfoque significa que el subproceso Looper espera el progreso de otros subprocesos, pero solo cuando se cierra. Esto solo ocurre una vez y no afecta el rendimiento, y mantiene el otro código para usar la asignación nativa completamente sin bloqueos.
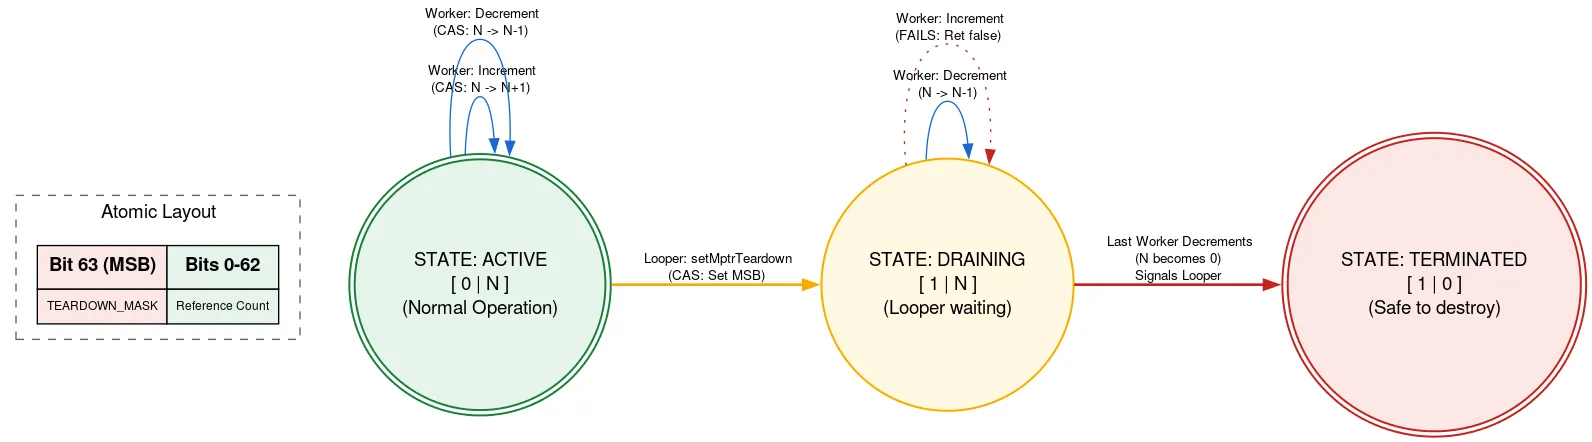
Hay muchos otros trucos y complejidades en la implementación. Para obtener más información sobre DeliQueue, revisa el código fuente.
Optimización: Programación sin ramas
Mientras desarrollaba y probaba DeliQueue, el equipo ejecutó muchas comparativas y generó perfiles del código nuevo con cuidado. Un problema que se identificó con la herramienta simpleperf fueron los vaciados de canalización causados por el código del comparador Message.
Un comparador estándar usa saltos condicionales, con la condición para decidir qué Message viene primero simplificada a continuación:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
Este código se compila en saltos condicionales (instrucciones b.le y cbnz). Cuando la CPU encuentra una rama condicional, no puede saber si se toma la rama hasta que se calcula la condición, por lo que no sabe qué instrucción leer a continuación y tiene que adivinar, usando una técnica llamada predicción de rama. En un caso como la búsqueda binaria, la dirección de la rama será impredeciblemente diferente en cada paso, por lo que es probable que la mitad de las predicciones sean incorrectas. La predicción de ramas suele ser ineficaz en los algoritmos de búsqueda y ordenamiento (como el que se usa en un min-heap), ya que el costo de adivinar de forma incorrecta es mayor que la mejora que se obtiene al adivinar de forma correcta. Cuando el predictor de ramas se equivoca, debe descartar el trabajo que hizo después de asumir el valor previsto y comenzar de nuevo desde la ruta que realmente se tomó; esto se denomina vaciado de canalización.
Para encontrar este problema, generamos un perfil de nuestras comparativas con el contador de rendimiento branch-misses, que registra los seguimientos de pila en los que el predictor de ramas se equivoca. Luego, visualizamos los resultados con Google pprof, como se muestra a continuación:
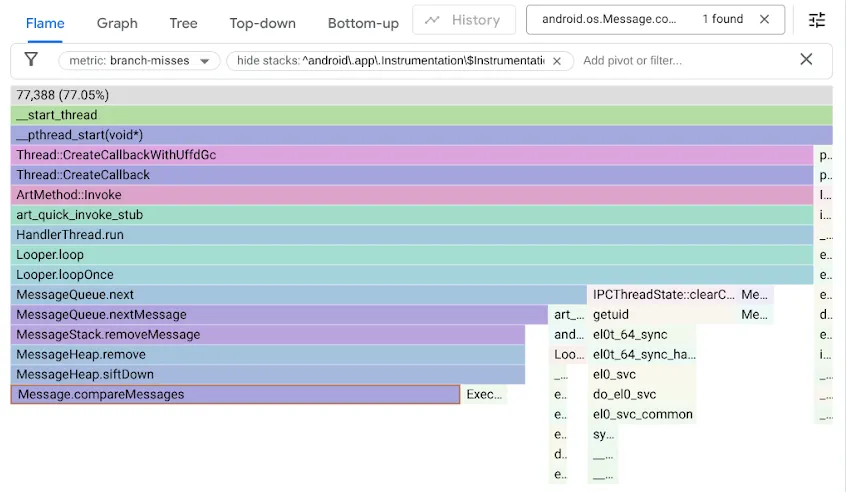
Recuerda que el código original de MessageQueue usaba una lista vinculada de forma única para la cola ordenada. La inserción recorrería la lista en orden como una búsqueda lineal, deteniéndose en el primer elemento que está más allá del punto de inserción y vinculando el nuevo Message antes de él. Para quitar la cabeza, solo se debía desvincular. DeliQueue usa un montículo mínimo, en el que las mutaciones requieren reordenar algunos elementos (desplazamiento hacia arriba o hacia abajo) con complejidad logarítmica en una estructura de datos equilibrada, en la que cualquier comparación tiene la misma probabilidad de dirigir el recorrido a un elemento secundario izquierdo o derecho. El nuevo algoritmo es asintóticamente más rápido, pero expone un nuevo cuello de botella, ya que el código de búsqueda se detiene en las fallas de rama la mitad del tiempo.
Cuando nos dimos cuenta de que los errores de rama ralentizaban nuestro código de montón, lo optimizamos con programación sin ramas:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
Para comprender la optimización, desensambla los dos ejemplos en Compiler Explorer y usa LLVM-MCA, un simulador de CPU que puede generar un cronograma estimado de ciclos de CPU.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
Ten en cuenta la rama condicional, b.le, que evita comparar los campos insertSeq si el resultado ya se conoce de la comparación de los campos when.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
Aquí, la implementación sin ramificaciones requiere menos ciclos e instrucciones que incluso la ruta más corta a través del código con ramificaciones, por lo que es mejor en todos los casos. La implementación más rápida y la eliminación de las ramas con predicciones incorrectas dieron como resultado una mejora de 5 veces en algunas de nuestras comparativas.
Sin embargo, esta técnica no siempre es aplicable. Los enfoques sin ramas suelen requerir que se realice un trabajo que se descartará y, si la rama es predecible la mayor parte del tiempo, ese trabajo desperdiciado puede ralentizar el código. Además, quitar una rama suele generar una dependencia de datos. Las CPU modernas ejecutan varias operaciones por ciclo, pero no pueden ejecutar una instrucción hasta que sus entradas de una instrucción anterior estén listas. En cambio, una CPU puede especular sobre los datos en las ramas y trabajar con anticipación si se predice una rama correctamente.
Pruebas y validación
Validar la exactitud de los algoritmos sin bloqueos es muy difícil.
Además de las pruebas de unidades estándar para la validación continua durante el desarrollo, también escribimos pruebas de esfuerzo rigurosas para verificar las invariantes de la cola y tratar de inducir condiciones de carrera de datos si existían. En nuestros laboratorios de pruebas, podríamos ejecutar millones de instancias de prueba en dispositivos emulados y en hardware real.
Con la instrumentación de Java ThreadSanitizer (JTSan), podríamos usar las mismas pruebas para detectar también algunas condiciones de carrera de datos en nuestro código. JTSan no encontró ninguna condición de carrera de datos problemática en DeliQueue, pero, sorprendentemente, detectó dos errores de simultaneidad en el framework de Robolectric, que corregimos de inmediato.
Para mejorar nuestras capacidades de depuración, creamos nuevas herramientas de análisis. A continuación, se muestra un ejemplo de un problema en el código de la plataforma de Android en el que un subproceso sobrecarga a otro con Message, lo que genera una gran acumulación de trabajo, visible en Perfetto gracias a la función de instrumentación MessageQueue que agregamos.
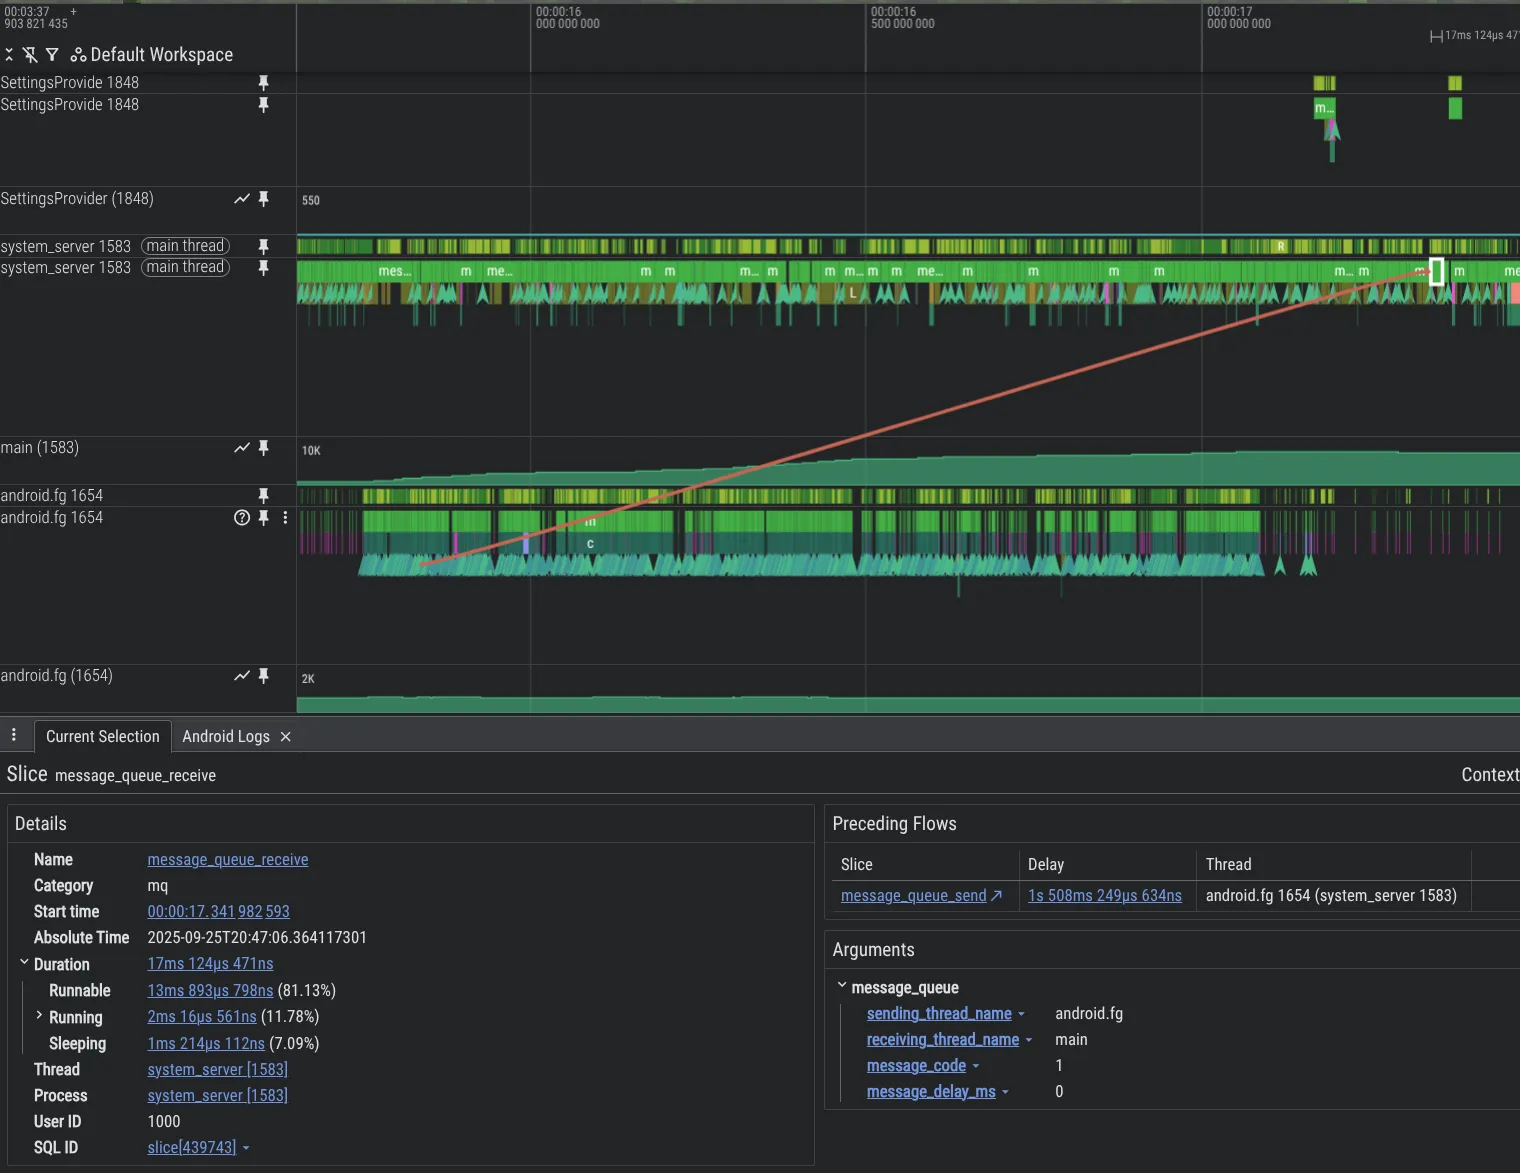
Para habilitar el seguimiento de MessageQueue en el proceso system_server, incluye lo siguiente en tu configuración de Perfetto:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
Impacto
DeliQueue mejora el rendimiento del sistema y de la app, ya que elimina los bloqueos de MessageQueue.
- Comparativas sintéticas: Las inserciones de varios subprocesos en colas ocupadas son hasta 5,000 veces más rápidas que la
MessageQueueheredada, gracias a la simultaneidad mejorada (la pila de Treiber) y las inserciones más rápidas (el montón mínimo). - En los seguimientos de Perfetto adquiridos de verificadores beta internos, vemos una reducción del 15% en el tiempo que el subproceso principal de la app pasa en la contención de bloqueo.
- En los mismos dispositivos de prueba, la reducción de la contención de bloqueos genera mejoras significativas en la experiencia del usuario, como las siguientes:
- -4% de fotogramas perdidos en las apps
- -7.7% de fotogramas perdidos en las interacciones de la IU del sistema y el selector
- -9.1% en el tiempo desde el inicio de la app hasta el primer fotograma dibujado, en el percentil 95
Próximos pasos
DeliQueue se lanzará para las apps en Android 17. Los desarrolladores de apps deben consultar el artículo sobre cómo preparar sus apps para el nuevo MessageQueue sin bloqueo en el blog para desarrolladores de Android para obtener información sobre cómo probar sus apps.
Referencias
[1] Treiber, R.K., 1986. Programación de sistemas: Cómo lidiar con el paralelismo. International Business Machines Incorporated, Thomas J. Centro de Investigación Watson.
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., y Lea, D. (2006). Java Concurrency in Practice. Addison-Wesley Professional.
-
 Novedades de productos
Las apps que se orienten a la próxima versión de Android ya no podrán escribir directamente en los contactos con el permiso WRITE_CONTACTS.
Roxanna Aliabadi Walker • Lectura de 6 min -
 Novedades de productos
A medida que se acelera el desarrollo basado en agentes, la ingeniería de Android alcanza una nueva y emocionante frontera: pasar de la finalización de código asistida a agentes que ejecutan tareas de extremo a extremo bajo tu dirección. Tienes total libertad y flexibilidad para elegir los modelos y agentes que usas.
Jason Buchel • Lectura de 3 min -
 Novedades de productos
Hoy, compartimos cómo estamos llevando nuestra visión de “más que una tienda” al siguiente nivel. Desde la pestaña Tú, que ahora es la base personal de más de 250 millones de usuarios activos por mes, hasta nuestra plataforma de juegos unificada que conecta a más de 700 millones de perfiles de gamer, Google Play llega a los usuarios dondequiera que estén.
Paul Feng • Lectura de 3 min
Recibe la información más reciente sobre el desarrollo de Android en tu bandeja de entrada todas las semanas.