Android Bench 2.0: การก้าวข้ามขีดจำกัดด้วยงานที่ท้าทายในระยะยาว
อ่าน 3 นาที
เมื่อเปิดตัว Android Bench ครั้งแรก เราได้สร้างรากฐานที่เข้มงวดสำหรับการประเมินวิธีที่โมเดลภาษาขนาดใหญ่ (LLM) ช่วยเหลือนักพัฒนาซอฟต์แวร์ในงาน Android จริง เนื่องจากโมเดลและเอเจนต์ AI พัฒนาไปอย่างรวดเร็ว เราจึงได้ปรับปรุงระเบียบวิธี เช่น การปรับกรอบการเปรียบเทียบให้สอดคล้องกับกรอบ Harbor วันนี้เราจะเปิดตัวชุดงานระยะยาว (LHT) ชุดแรก ซึ่งเป็นงานที่มีความซับซ้อนสูงและต้องใช้เวลาหลายวันหรืออาจถึง 1 สัปดาห์จึงจะทำเสร็จ นอกจากนี้ เรายังจะเปิดตัวการประเมินแบบ Agent โดยเริ่มจาก Agent จากผู้ให้บริการโมเดลที่เกี่ยวข้อง การเพิ่มนี้ทำให้เรามี Android Bench 2.0 ซึ่งเป็นการอัปเกรดครั้งใหญ่ที่ออกแบบมาเพื่อประเมินโมเดลและเอเจนต์ AI ตามขนาด ความคลุมเครือ และการแก้ปัญหาแบบหลายขั้นตอนที่ซับซ้อนที่คุณต้องเผชิญทุกวัน
ตั้งแต่การแก้ไขเล็กๆ น้อยๆ ไปจนถึงงานระยะยาว
Android Bench เวอร์ชันแรก รวมถึงการเปรียบเทียบการเขียนโค้ด AI ในช่วงแรกที่คล้ายกัน มุ่งเน้นไปที่การเปลี่ยนแปลงที่เพิ่มขึ้นในที่เก็บข้อมูลที่มีอยู่ ซึ่งในหลายกรณีจะจำกัดเฉพาะการแก้ไขข้อบกพร่องหรือคำขอฟีเจอร์ขนาดเล็ก ซึ่งสะท้อนให้เห็นถึงความสามารถของความช่วยเหลือจาก AI ในขณะนั้น รวมถึงวิธีที่คุณใช้
เราได้ยกระดับการประเมินเพื่อให้สอดคล้องกับงานที่คุณมอบหมายให้ AI เพื่อช่วยให้คุณค้นหาโมเดลและเอเจนต์การเขียนโค้ดที่เหมาะกับเวิร์กโฟลว์การพัฒนาของคุณมากที่สุดต่อไป Android Bench 2.0 สะท้อนความท้าทายที่ยิ่งใหญ่เหล่านี้ด้วย LHT ซึ่งรวมถึงการอัปเกรดการอ้างอิง การเพิ่มฟีเจอร์ใหม่ การสร้างแอปตั้งแต่ต้น หรือการแปลงแอปข้ามแพลตฟอร์มเป็น Android
งานที่ซับซ้อนต้องมีการประเมินและการให้คะแนนที่ละเอียดกว่า
ในงานด้านวิศวกรรมที่ใช้เวลาหลายวัน การให้คะแนนแบบผ่านหรือไม่ผ่านเพียงอย่างเดียวอาจไม่สามารถแสดงภาพรวมทั้งหมดได้
ตัวอย่างเช่น เอเจนต์อาจปรับโครงสร้างหน้าจอ 40 หน้าเป็น Jetpack Compose ตั้งค่าตารางฐานข้อมูล และผ่านข้อกำหนด 90% แต่ไม่ผ่านการยืนยันกรณีขอบเพียงครั้งเดียว อัตราการให้คะแนนแบบไบนารีจะให้คะแนนการทดสอบนี้เป็น 0% ซึ่งบดบังความสามารถด้านสถาปัตยกรรมของโมเดล เราจะเปลี่ยนไปใช้การให้คะแนนอย่างต่อเนื่องเพื่อให้สัญญาณที่มีความหมายมากขึ้น ทั้งสำหรับการพัฒนาโมเดลและเพื่อให้คุณเข้าใจว่า AI ช่วยคุณได้อย่างไร
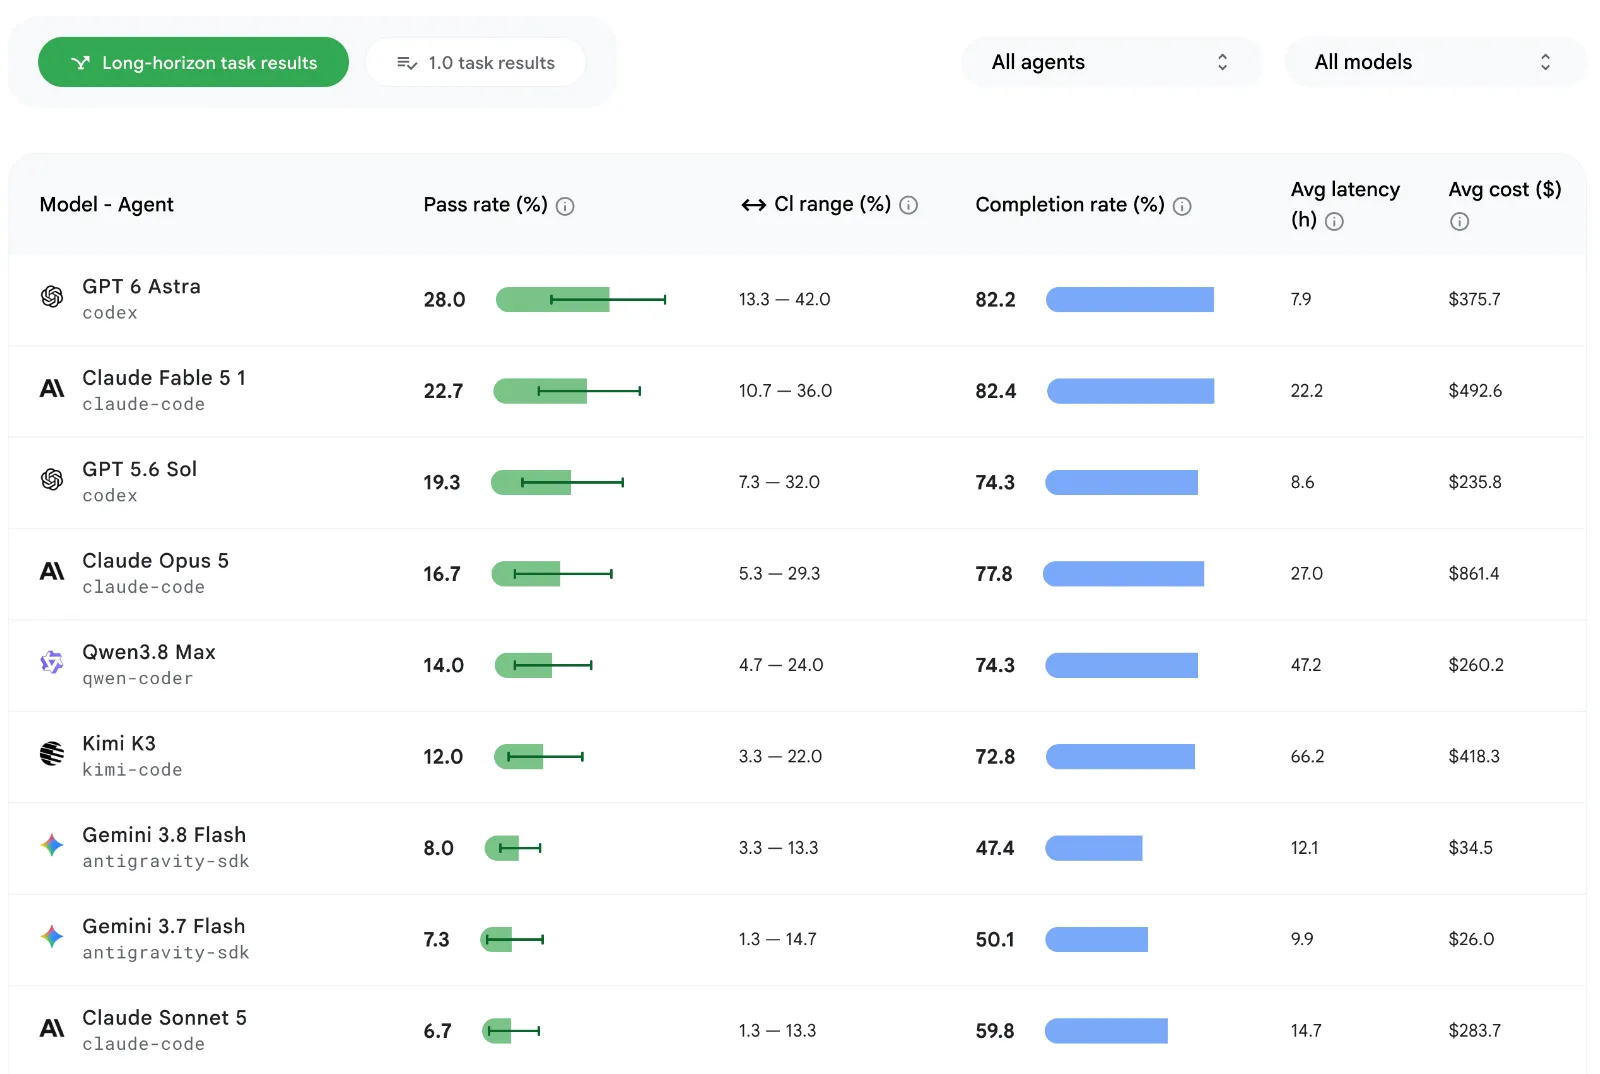
เราคำนวณอัตราการดำเนินการนี้โดยพิจารณาจากปัจจัยต่างๆ เช่น ฟังก์ชันการทำงาน ความถูกต้องของภาพ และการหลีกเลี่ยงการถดถอย นอกจากนี้ เรายังใช้การลงโทษด้วยการให้คะแนนตามวัตถุประสงค์สำหรับการเบี่ยงเบนจากวิธีการประเมินหรือข้อจำกัดด้านโครงสร้าง ดูตารางลีดเดอร์บอร์ดที่อัปเดตแล้วและคลิกมุมมองการ์ดของแต่ละโมเดลเพื่อดูองค์ประกอบเพิ่มเติม เช่น อัตราการผ่าน อัตราการทำงานเสร็จสมบูรณ์ และค่าใช้จ่ายเฉลี่ยต่อโมเดลและต่อชิ้นงาน
อัตราการผ่านสูงสุดสำหรับ LHT อยู่ที่ประมาณ 28% ซึ่งต่ำกว่าอัตราการผ่านของงานเดิมในเกณฑ์มาตรฐานที่ประมาณ 91% มาก

งานระยะยาวจะเผยให้เห็นข้อมูลเชิงลึกที่เป็นประโยชน์สำหรับความช่วยเหลือจาก AI
นอกเหนือจากการวัดประสิทธิภาพของ AI ในการจัดการงานที่ใช้เวลานานแล้ว ชุดข้อมูล LHT ยังช่วยให้เราทราบจุดแข็งและจุดอ่อนของโมเดลที่ทดสอบมากขึ้น และเรายังให้คำแนะนำที่เป็นประโยชน์แก่คุณมากขึ้นด้วย
ในทุกระดับโมเดล AI จะเขียนโค้ดใหม่ได้ดีกว่าการปรับโครงสร้างโค้ดที่มีอยู่ การปรับโครงสร้างและการย้ายข้อมูลจะซับซ้อนมากขึ้นเนื่องจากความสำเร็จขึ้นอยู่กับความซับซ้อนของสถาปัตยกรรมมากกว่าปริมาณโค้ด
โมเดลแสดงความสามารถที่แข็งแกร่งในการแปลงที่กำหนดได้และเป็นที่ยอมรับ เช่น การแปลง Java เป็น Kotlin, การสลับ Retrofit เป็น Ktor หรือการนำเลเยอร์ ViewModel มาใช้ โดยใช้รูปแบบเหล่านี้อย่างสม่ำเสมอ แม้ว่าจะมีไฟล์มากกว่า 125 ไฟล์และโค้ดมากกว่า 8,000 บรรทัด
อย่างไรก็ตาม โมเดลจะทำงานได้ยากเมื่อต้องมีการตรวจสอบที่รันไทม์ (เช่น กราฟการแทรกทรัพยากร Dependency ที่ขาดหายไป) เกี่ยวข้องกับการเปลี่ยนแปลงที่ทำให้เฟรมเวิร์กใช้งานไม่ได้ หรือพบช่องว่างด้านความรู้เกี่ยวกับไลบรารีที่ยังไม่ได้เผยแพร่ การพอร์ตแอปข้ามแพลตฟอร์มไปยัง Android ยังคงเป็นความท้าทายที่เปิดกว้าง ไม่มีโมเดลใดที่ได้อัตราการผ่าน 100% และโมเดลที่ล้ำสมัยที่สุดมีอัตราการดำเนินการเสร็จสิ้นสูงสุดที่ 80%
ขอแนะนำการประเมิน Agent
เราจะเพิ่มเอเจนต์ที่ใช้กันโดยทั่วไปลงในการประเมินเพื่อช่วยให้คุณเข้าใจประสิทธิภาพของโมเดลได้ดียิ่งขึ้นเมื่อผสานรวมเข้ากับเวิร์กโฟลว์ของเอเจนต์ เราจะเริ่มด้วยการเรียกใช้โมเดลใหม่กับ LHT โดยใช้เอเจนต์จากผู้ให้บริการโมเดลที่เกี่ยวข้อง ตัวอย่างเช่น เราเรียกใช้ GPT 5.6 Sol บน Codex และ Gemini 3.8 Flash บน Google Antigravity การจับคู่นี้แสดงให้เห็นว่าการออกแบบฮาร์เนสส่งผลดีต่อผลลัพธ์ของนักพัฒนาแอปอย่างไร เนื่องจากเราเห็นว่าการแคชพรอมต์และการจัดหน้าต่างเครื่องมือแบบกะทัดรัดสามารถลดจำนวนโทเค็นได้
ในอนาคต เราจะขยายการทำงานนี้โดยไฮไลต์ผลลัพธ์จากโมเดลและเอเจนต์ต่างๆ ร่วมกันด้วย เพื่อช่วยให้คุณค้นพบว่าการทำงานร่วมกันแบบใดที่เหมาะกับคุณและทีมมากที่สุด
เราลงทุนในการวัดผลนี้เนื่องจากคุณควรใช้เอเจนต์และโมเดลที่เลือกสำหรับการพัฒนา Android ได้ และเราจะแชร์ข้อมูลเพิ่มเติมกับคุณในอีกไม่กี่สัปดาห์ข้างหน้า
เพิ่มโมเดลใหม่แล้ว
นอกจากนี้ เรายังคงขยายลีดเดอร์บอร์ดเพื่อให้คุณมีข้อมูลล่าสุดสำหรับการตัดสินใจในการพัฒนา เราได้เพิ่ม Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 ของ OpenAI, Fable 5.1 ของ Anthropic, Kimi K3 และ Qwen 3.8 Max โดยมี GPT-6 Astra ของ OpenAI อยู่ด้านบนด้วยอัตราการผ่าน 28%
มองไปข้างหน้า
Android Bench 2.0 มอบสภาพแวดล้อมที่แข็งแกร่งสำหรับการวัด AI สำหรับการพัฒนา Android การรวมงานระยะยาว การประเมินแบบมัลติโมดัล เอเจนต์ และการให้คะแนนอย่างต่อเนื่องเข้าด้วยกันจะช่วยให้ทีมวิจัย AI สร้างพาร์ทเนอร์การเขียนโค้ด AI ที่มีความสามารถและเชื่อถือได้มากขึ้น และเราหวังว่าจะช่วยให้คุณมีความโปร่งใสมากขึ้นเกี่ยวกับตัวเลือกในการพัฒนา AI
ดูลีดเดอร์บอร์ดที่อัปเดตแล้วพร้อมวิธีการที่อัปเดตแล้ว ความคิดเห็นของคุณมีผลโดยตรงต่อวิธีที่เราพัฒนา Android Bench ดังนั้นโปรดแชร์ความคิดเห็นกับเราต่อไปใน GitHub รวมถึงช่องทางโซเชียลของเรา เช่น X และ LinkedIn
-
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
เมื่อปีที่แล้ว Android Studio ได้เปิดให้ใช้โมเดล AI ใดก็ได้ วันนี้เราจะก้าวไปอีกขั้นด้วยการเปิดตัวการรองรับเอเจนต์การเขียนโค้ดที่คุณเลือก
Matthew Warner • ใช้เวลาอ่าน 3 นาที -

 ข่าวสารเกี่ยวกับผลิตภัณฑ์
เมื่อเดือนมีนาคมที่ผ่านมา เราได้เปิดตัว Android Bench ซึ่งเป็นลีดเดอร์บอร์ด LLM สำหรับงานพัฒนา Android ในโลกแห่งความเป็นจริง ตั้งแต่นั้นมา เราได้ปรับปรุงการเปรียบเทียบตามความคิดเห็นของคุณ ซึ่งรวมถึงการประเมินโมเดลแบบเปิดและเพิ่มมิติข้อมูลต้นทุนและประสิทธิภาพลงในลีดเดอร์บอร์ด
Zoe Lopez-Latorre • ใช้เวลาอ่าน 3 นาที -
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
วันนี้เราจะเปิดตัว Android 17 และพร้อมให้บริการในอุปกรณ์ Pixel ส่วนใหญ่ที่รองรับ โปรดรอติดตามอุปกรณ์ใหม่ที่ใช้ Android 17 ในอีกไม่กี่เดือนข้างหน้า
Matthew McCullough • อ่าน 13 นาที
รับข้อมูลเชิงลึกด้านการพัฒนา Android ล่าสุดส่งตรงถึงกล่องจดหมายของคุณทุกสัปดาห์