การพัฒนาวิธีวัดผล LLM สำหรับ Android: ยุคใหม่ของ Android Bench
อ่าน 3 นาที

เมื่อเดือนมีนาคมที่ผ่านมา เราได้เปิดตัว Android Bench ซึ่งเป็นลีดเดอร์บอร์ด LLM สำหรับงานพัฒนา Android ในโลกแห่งความเป็นจริง เป้าหมายของเราคือการให้ความโปร่งใสเกี่ยวกับความสามารถของโมเดลในการพัฒนา Android และส่งเสริมการปรับปรุงโมเดล เพื่อให้คุณมีตัวเลือก AI ที่เป็นประโยชน์มากขึ้นสำหรับเวิร์กโฟลว์ในชีวิตประจำวัน ตั้งแต่นั้นมา เราได้ปรับปรุงการเปรียบเทียบตามความคิดเห็นของคุณ ซึ่งรวมถึงการประเมินโมเดลแบบเปิด และการเพิ่มมิติข้อมูลด้านต้นทุนและประสิทธิภาพลงในลีดเดอร์บอร์ด
แต่ความสามารถของ AI มีการพัฒนาอยู่เสมอ และการวัดผลก็ต้องเป็นไปในทิศทางเดียวกัน ในการเปิดตัวเดือนกรกฎาคม เราได้นำเฟรมเวิร์ก Harbor มาใช้ ซึ่งรวมถึงเอเจนต์การเปรียบเทียบเวอร์ชันอัปเดตที่ใช้ในการประเมินโมเดล
นอกจากการเปลี่ยนแปลงการประเมินแล้ว ในรุ่นเดือนกรกฎาคมนี้ เราจะเพิ่มโมเดลใหม่ 8 รายการ (Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus และ Qwen 3.7 Max) ลงในลีดเดอร์บอร์ด นอกจากนี้ เรายังจะแชร์โอกาสให้คุณซึ่งเป็นชุมชนนักพัฒนาแอป Android ได้มีส่วนร่วมในการสร้างเกณฑ์มาตรฐานด้วย
การอัปเกรดระเบียบวิธีด้วยเฟรมเวิร์ก Harbor
เมื่อออกแบบ Android Bench เราได้ยึดวิธีการตามมาตรฐานอุตสาหกรรมชั้นนำที่มีอยู่ในขณะนั้น เราใช้ mini-swe-agent v1 ซึ่งเป็นเอเจนต์การเปรียบเทียบอเนกประสงค์ และปรับให้เข้ากับความแตกต่างของการพัฒนา Android เพื่อให้การวัดพื้นฐานสำหรับความสามารถของโมเดลสำหรับงานพัฒนา Android ทั่วไป
เรากำลังกำหนดมาตรฐานการเปรียบเทียบให้เป็นเฟรมเวิร์ก Harbor เพื่อให้คุณได้รับการประเมินที่ทันสมัยซึ่งวัดความสามารถของโมเดลล่าสุดในการพัฒนา Android ได้อย่างแม่นยำต่อไป Harbor กำหนดมาตรฐานและการผสานรวมที่ช่วยให้ทุกคนเรียกใช้การเปรียบเทียบ ประเมินการตั้งค่าที่ต้องการ หรือแชร์ผลลัพธ์ได้อย่างง่ายดาย ซึ่งจะช่วยเพิ่มความโปร่งใสและการมองเห็นให้คุณ
การอัปเกรดนี้ช่วยให้เราประเมินโมเดลและความสามารถของโมเดลได้อย่างเข้มงวดมากขึ้น และเราได้ทำการทดสอบประสิทธิภาพอีกครั้งในโมเดลทั้งหมดเพื่อกำหนดเกณฑ์พื้นฐานที่อัปเดตแล้ว ซึ่งหมายความว่าการให้คะแนนจะมีการเปลี่ยนแปลงเล็กน้อย แต่คุณจะยังดูคะแนนย้อนหลังได้ในที่เก็บถาวรบนเว็บไซต์ของเรา
เราต้องการให้มั่นใจว่า Android Bench จะเป็นประโยชน์ต่อคุณ ดังนั้นเราจะอัปเดตแอปอย่างต่อเนื่องเมื่อการประเมินของเราและอุตสาหกรรมเติบโตขึ้น
ขยายลีดเดอร์บอร์ดด้วยโมเดลใหม่ 8 รายการ
เราได้เพิ่ม Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus และ Qwen 3.7 Max ลงในลีดเดอร์บอร์ด Android Bench เพื่อให้ลีดเดอร์บอร์ดมีความสดใหม่อยู่เสมอ
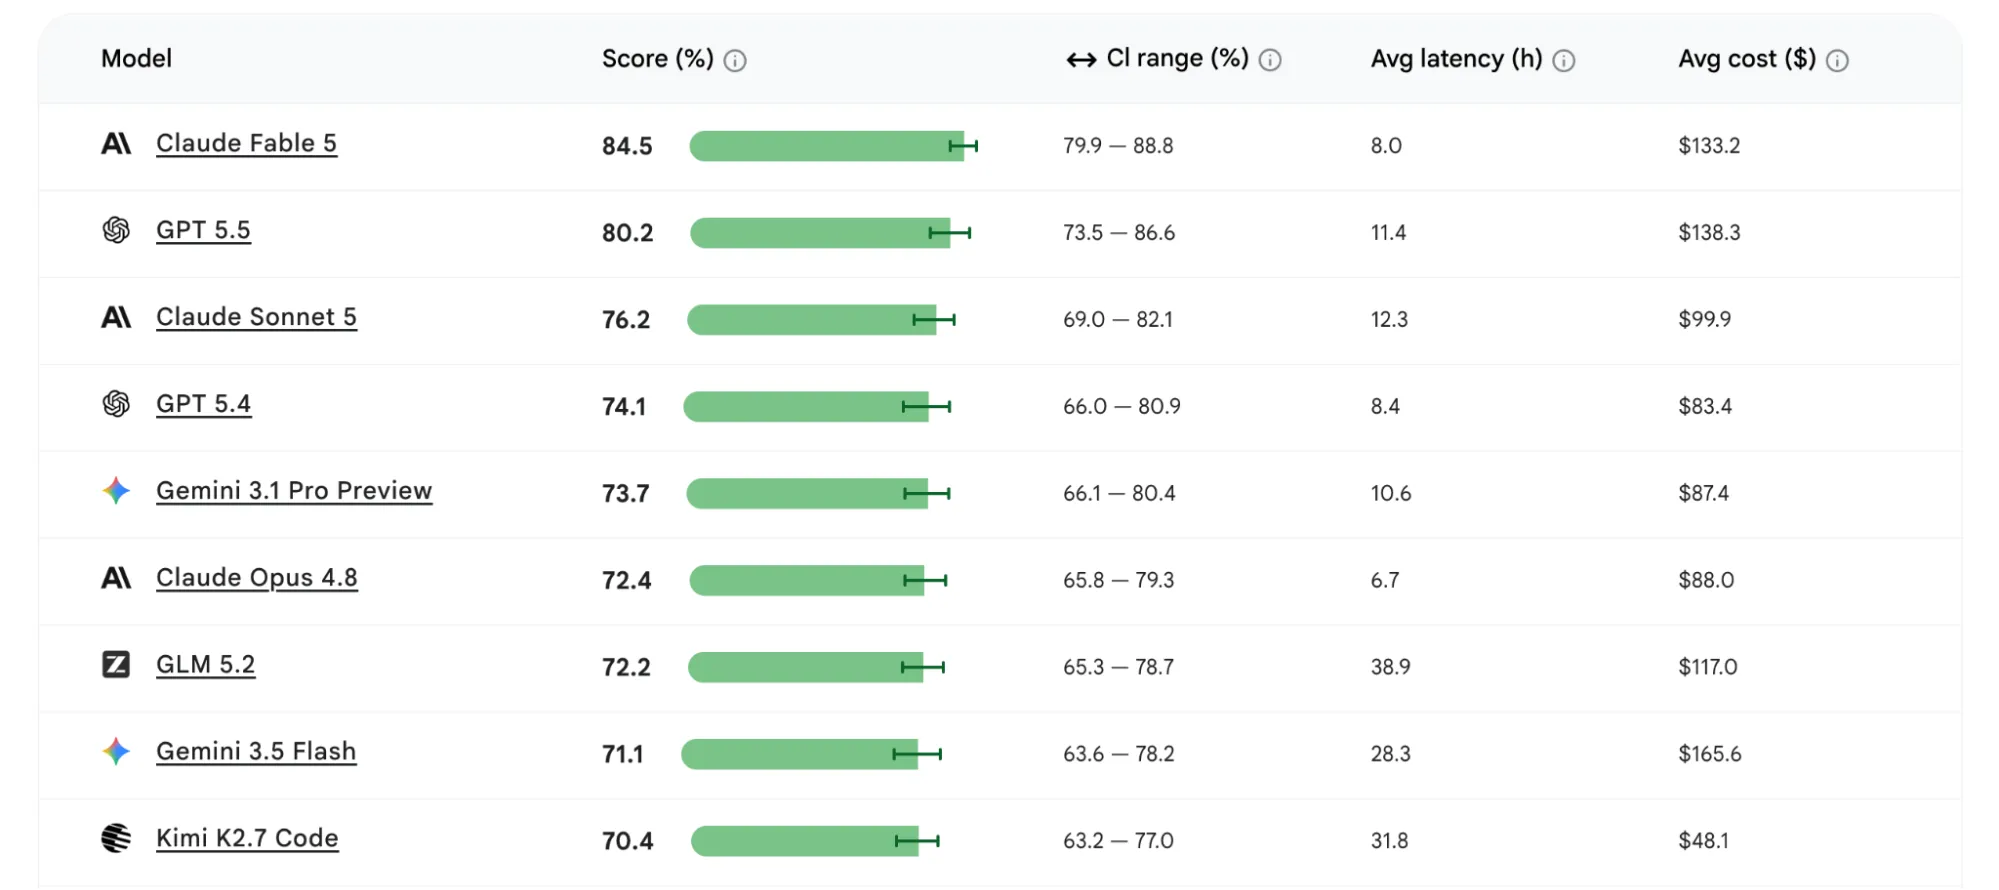
คุณจะเห็นว่า Claude Fable 5 อยู่ที่ด้านบนของลีดเดอร์บอร์ดด้วยคะแนน 84.5 ตามด้วย GPT 5.5 ที่มีคะแนน 80.2 และ Claude Sonnet 5 อยู่ในอันดับที่ 3 ด้วยคะแนน 76.2
เมื่อเปรียบเทียบเฉพาะโมเดลแบบ Open-weight GLM 5.2 อยู่ในอันดับต้นๆ ด้วยคะแนน 72.2 ตามมาด้วย Kimi K2.7 Code ที่มีคะแนน 70.4
คุณสามารถดูเมตริกประสิทธิภาพและประสิทธิภาพของโมเดลได้ในลีดเดอร์บอร์ดที่อัปเดตแล้ว เพื่อดูว่าโมเดลใหม่และโมเดลก่อนหน้าเหล่านี้จัดการกับความท้าทายเฉพาะของ Android เช่น การย้ายข้อมูล Jetpack Compose, การเชื่อมต่อเครือข่ายอุปกรณ์ที่สวมใส่ได้ และการอัปเดต API ของแพลตฟอร์มได้อย่างไร
เปิด Android Bench ให้ชุมชนมีส่วนร่วม
ตั้งแต่แรกเริ่ม เราให้ความสำคัญกับแนวทางที่เปิดกว้างและโปร่งใส จึงได้เผยแพร่ระเบียบวิธีและชุดทดสอบเดิมของเราต่อสาธารณะใน GitHub คุณได้ขอวิธีแสดงความคิดเห็นเกี่ยวกับชุดข้อมูลของเรา ตอนนี้เราจึงก้าวไปอีกขั้นในการทำงานร่วมกันด้วยการให้โอกาสคุณ ซึ่งเป็นชุมชนนักพัฒนาแอป Android ได้กำหนดรูปแบบของ Android Bench
ตั้งแต่วันนี้เป็นต้นไป คุณสามารถมีส่วนร่วมใน Android Bench ได้ 2 วิธีดังนี้
- ออกแบบและส่งงานพัฒนา Android ของคุณเองเพื่อประเมินวิธีที่โมเดลจัดการกับสถานการณ์ที่สำคัญต่อคุณ
- เรียกใช้และแชร์การประเมินเกณฑ์มาตรฐานด้วยตัวคุณเอง โดยทดสอบโมเดลที่คุณต้องการกับชุดข้อมูลของเราหรืองานที่กำหนดเองของคุณ
เราจะตรวจสอบงานที่ส่งและประเมินว่าจะเพิ่มงานเหล่านั้นลงในเกณฑ์มาตรฐานหรือไม่ เราหวังว่าจะสร้างเกณฑ์มาตรฐานที่สะท้อนความเป็นจริงที่หลากหลายในแต่ละวันของชุมชนนักพัฒนาแอป Android ทั่วโลกได้อย่างแท้จริง
สิ่งที่จะเกิดขึ้นในอนาคต
เมื่อมีตัวเลือกในการพัฒนาเอเจนต์มากขึ้นเรื่อยๆ การรักษาเกณฑ์มาตรฐานที่ล้ำสมัยจะช่วยให้ความช่วยเหลือจาก AI ที่คุณใช้มีความชาญฉลาด มีประโยชน์ และมีประสิทธิภาพมากขึ้นเรื่อยๆ ไปที่ที่เก็บ GitHub เพื่อดูงาน เราขอเชิญคุณส่งงานให้ทีมของเราตรวจสอบ และคุณสามารถไปที่ Harbor Hub เพื่อสำรวจชุดข้อมูลหรือส่งการประเมิน
เช่นเคย คุณสามารถดูลีดเดอร์บอร์ดที่อัปเดตแล้วหรืออ่านวิธีการได้ในเว็บไซต์ของเรา
-
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
เมื่อปีที่แล้ว Android Studio ได้เปิดให้ใช้โมเดล AI ใดก็ได้ วันนี้เราจะก้าวไปอีกขั้นด้วยการเปิดตัวการรองรับเอเจนต์การเขียนโค้ดที่คุณเลือก
Matthew Warner • ใช้เวลาอ่าน 3 นาที -
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
วันนี้เราจะเปิดตัวชุดงานระยะยาว (LHT) ชุดแรก ซึ่งเป็นงานที่มีความซับซ้อนสูงซึ่งต้องใช้เวลาหลายวันหรืออาจถึง 1 สัปดาห์จึงจะทำเสร็จ นอกจากนี้ เรายังจะเปิดตัวการประเมินแบบ Agent โดยเริ่มจาก Agent จากผู้ให้บริการโมเดลที่เกี่ยวข้อง
Matthew McCullough • ใช้เวลาอ่าน 3 นาที -
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
ใน Google Play เราขยายแพลตฟอร์มการสมัครใช้บริการอย่างต่อเนื่องเพื่อช่วยให้คุณขับเคลื่อนการเติบโต ปรับตัวให้เข้ากับโมเดลธุรกิจใหม่ๆ และเข้าถึงผู้ใช้ได้ตรงจุด
Sheenam Mittal • อ่าน 4 นาที
รับข้อมูลเชิงลึกด้านการพัฒนา Android ล่าสุดส่งตรงถึงกล่องจดหมายของคุณทุกสัปดาห์