وقتی برای اولینبار Android Bench را راهاندازی کردیم، پایه محکمی برای ارزیابی نحوه کمک مدلهای زبانی بزرگ (LLM) به توسعهدهندگان در انجام وظایف واقعی Android ایجاد کردیم. همزمان با تکامل سریع مدلها و کارگزاران هوش مصنوعی، روششناسی خود را بهروز کردهایم، مثلاً چارچوب معیار خود را با چارچوب Harbor هماهنگ کردهایم. امروز اولین مجموعه از تکالیف بلندمدت (LHT) را منتشر میکنیم، که تکالیفی با پیچیدگی بسیار زیاد هستند و تکمیل آنها برای مهندسان چندین روز یا حتی یک هفته طول میکشد. همچنین ارزیابی عاملگرا را معرفی میکنیم که با نمایندگان ارائهدهندگان مدل مربوطه شروع میشود. با این افزودن، به Android Bench 2.0 میرسیم—ارتقایی بزرگ که برای ارزیابی مدلها و کارگزاران هوش مصنوعی دربرابر مقیاس، ابهام، و حل مسئله چندمرحلهای پیچیده که هر روز با آنها مواجه میشوید طراحی شده است.
از اصلاحات افزایشی تا تکالیف بلندمدت
اولین تکرار Android Bench، همراه با معیارهای مشابه کدنویسی هوش مصنوعی اولیه، بر تغییرات افزایشی در مخازن موجود تمرکز داشت، که در بسیاری از موارد به رفع اشکالات یا درخواستهای ویژگیهای کوچکتر محدود میشد. این امر نشاندهنده قابلیتهای دستیار هوش مصنوعی در آن زمان و همچنین نحوه استفاده شما از آن بود.
برای اینکه همچنان به شما کمک کنیم مدلها و عاملهای کدنویسی را که برای گردش کار توسعه شما مناسبتر هستند پیدا کنید، سطح ارزیابیهایمان را بالا بردهایم تا با کاری که به هوش مصنوعی واگذار میکنید مطابقت داشته باشد. Android Bench 2.0 این چالشهای بلندپروازانه را با LHTهایی که شامل ارتقای وابستگیها، افزودن ویژگیهای جدید، ساختن برنامهها از صفر، یا تبدیل برنامه چندپلتفرمی به Android است منعکس میکند.
تکالیف پیچیده به ارزیابی و امتیازدهی دقیقتری نیاز دارند
در وظایف مهندسی چند روزه، نمره قبولی یا مردودی دوتایی تصویر کامل را ثبت نمیکند.
برای مثال، یک عامل ممکن است ۴۰ صفحه را به Jetpack Compose بازسازی کند، جدولهای پایگاه داده را راهاندازی کند، و ۹۰٪ از الزامات را بگذراند، اما در یک ادعای مورد حاشیهای شکست بخورد. امتیازدهی دودویی این اجرا را بهعنوان ۰٪ ردهبندی میکند و قابلیتهای معماری مدل را پنهان میکند. ما به امتیازدهی مداوم روی میآوریم تا هم برای توسعه مدل و هم برای درک شما از اینکه هوش مصنوعی چگونه میتواند به شما کمک کند، نشان معنادارتری ارائه دهیم.
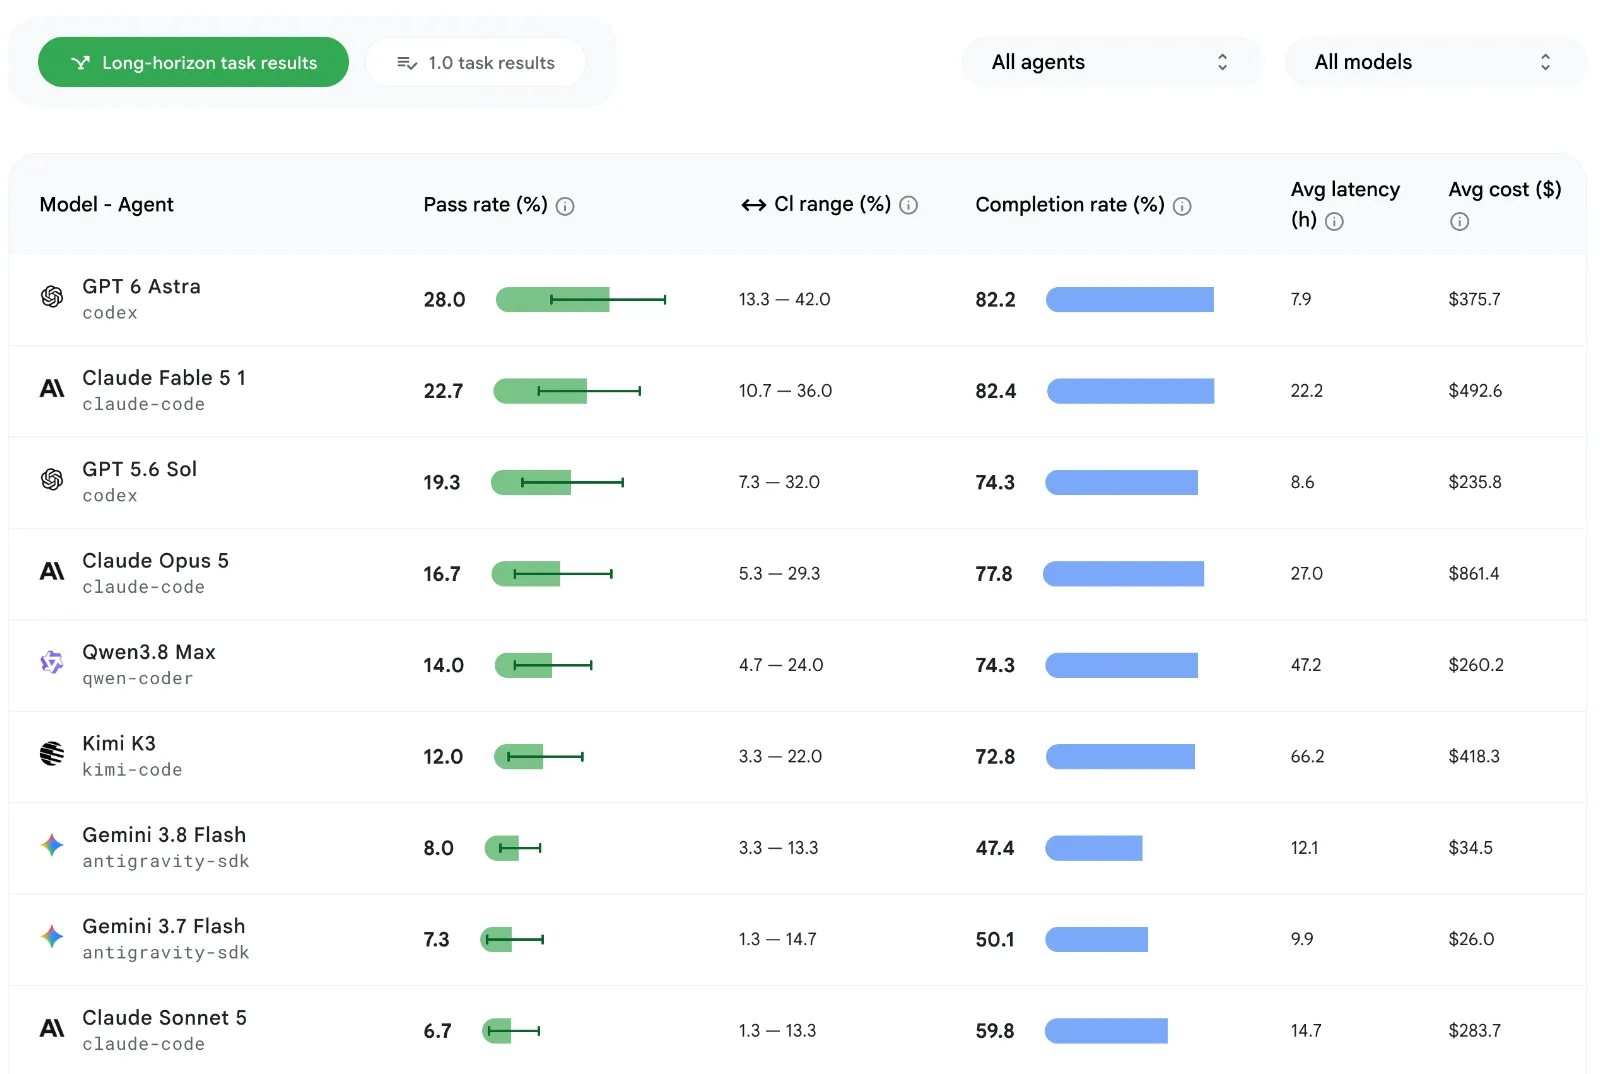
ما این نرخ تکمیل را ازطریق ترکیبی از عوامل مانند عملکرد، وفاداری بصری، و اجتناب از پسرفت محاسبه میکنیم. همچنین برای انحراف از دستورالعملهای ارزیابی یا محدودیتهای ساختاری، جریمههای امتیازدهی عینی اعمال میکنیم. به تابلوی امتیازات بهروزشده نگاهی بیندازید و روی نمای کارت هر مدل کلیک کنید تا عناصر بیشتری مثل نرخ قبولی، نرخ تکمیل، و هزینههای میانگین هر مدل و هر تکلیف را ببینید.
بالاترین نرخ قبولی برای LHT حدود ۲۸٪ است، که بسیار پایینتر از نرخ قبولی حدود ۹۱٪ برای تکالیف اصلی در معیار سنجش است.

تکالیف بلندمدت اطلاعات آماری مفیدی برای کمک هوشوارهای آشکار میکنند
مجموعه داده LHT علاوهبر اندازهگیری اینکه هوش مصنوعی چقدر در انجام وظایف طولانیمدت خوب عمل میکند، به ما کمک میکند درباره نقاط قوت و ضعف مدلهای آزمایششده بیشتر بدانیم و راهنماییهای عملیتری به شما ارائه دهیم.
در سراسر سطوح مدل، هوش مصنوعی در نوشتن کد جدید بهتر از بازسازی کد موجود عمل میکند. بازسازی و انتقالها دشوارتر میشوند زیرا موفقیت به پیچیدگی معماری بستگی دارد نه حجم کد.
مدلها قابلیتهای قدرتمندی در تبدیلهای قطعی و تثبیتشده نشان میدهند، مثل تبدیل جاوا به Kotlin، جایگزینی Retrofit با Ktor، یا معرفی لایه ViewModel. این الگوها را بهطور یکنواخت اعمال میکند، حتی در بیشاز ۱۲۵ فایل و بیشاز ۸٬۰۰۰ خط کد.
بااینحال، مدلها زمانی با مشکل مواجه میشوند که وظایف نیاز به اعتبارسنجی زمان اجرا داشته باشند (مثل نمودارهای تزریق وابستگی ازدسترفته)، شامل تغییرات چارچوب شکننده باشند، یا با کتابخانههای منتشرنشده با شکافهای دانش مواجه شوند. انتقال برنامههای چندسکویی به Android همچنان یک چالش باز است—هیچ مدلی به نرخ موفقیت ۱۰۰٪ دست نیافته است و مدلهای پیشرفته حداکثر به نرخ تکمیل ۸۰٪ میرسند.
معرفی ارزیابیهای نماینده
برای اینکه به شما کمک کنیم درک بهتری از عملکرد مدلها هنگام ادغام در گردشهای کار عاملمحور داشته باشید، عوامل پرکاربرد را به ارزیابی خود اضافه میکنیم. ما با اجرای مدلهای جدید دربرابر LHT با نمایندگان ارائهدهنده مدل مربوطه شروع میکنیم. برای مثال، ما GPT 5.6 Sol را در Codex و Gemini 3.8 Flash را در Google Antigravity اجرا کردیم. این جفتسازی نشان میدهد که طراحی مهار چگونه بر نتایج توسعهدهنده تأثیر مثبت میگذارد، زیرا دیدهایم که ذخیره کردن پیامواره و پنجرهبندی ابزار فشرده میتواند منجر به کاهش نشانهها شود.
در آینده، این ویژگی را گسترش خواهیم داد و نتایج را در ترکیبهای مختلف مدل و عامل نیز برجسته خواهیم کرد تا به شما کمک کنیم بهترین ترکیبها را برای خودتان و تیمتان پیدا کنید.
ما در این اندازهگیری سرمایهگذاری میکنیم زیرا برای شما مهم است که بتوانید از عامل و مدل انتخابیتان برای توسعه Android استفاده کنید و در هفتههای آینده اطلاعات بیشتری با شما همرسانی خواهیم کرد.
مدلهای جدید اضافه شد
علاوهبراین، ما همچنان درحال گسترش تابلوی امتیازات خود هستیم تا مطمئن شویم که شما بهروزترین دادهها را برای تصمیمات توسعه خود دارید. Gemini 3.8 Flash، Gemini 3.7 Flash، GPT-6 از OpenAI، Fable 5.1 از Anthropic، Kimi K3، و Qwen 3.8 Max را اضافه کردیم، که GPT-6 Astra از OpenAI با نرخ قبولی ۲۸٪ در صدر قرار دارد.
پیشنگری
Android Bench 2.0 محیطی قدرتمند برای اندازهگیری هوش مصنوعی در توسعه Android ارائه میدهد. با ترکیب کردن تکالیف بلندمدت، ارزیابی چندوجهی، عاملها، و امتیازدهی پیوسته، امیدواریم تیمهای پژوهش هوش مصنوعی را توانمند کنیم تا شرکای کدنویسی هوش مصنوعی توانمندتر و قابلاتکاتر بسازند و امیدواریم شفافیت بیشتری درباره گزینههای شما برای توسعه هوش مصنوعی ارائه دهیم.
جدول ردهبندی بهروزرسانیشده را بههمراه روششناسی بهروزرسانیشده بررسی کنید. بازخورد شما مستقیماً بر نحوه توسعه Android Bench تأثیر میگذارد، بنابراین لطفاً بازخوردهای خود را در GitHub و همچنین کانالهای اجتماعی ما مانند X و LinkedIn با ما همرسانی کنید.
-
 اخبار محصول
بهعنوان توسعهدهندگان Android، وقتی نوبت به انتخاب عاملها، مدلهای زبانی بزرگ، ابزارها، و میاناهای خط فرمان (CLI) میرسد که برای توسعه نرمافزار استفاده میکنید، گزینههای زیادی دارید. هدف ما این است که به شما کمک کنیم برنامههای Android زیبا و با کیفیت بالا بسازید، مهم نیست که چگونه میخواهید بسازید.
Simona Milanovic • ۴ دقیقه خواندن -
 اخبار محصول
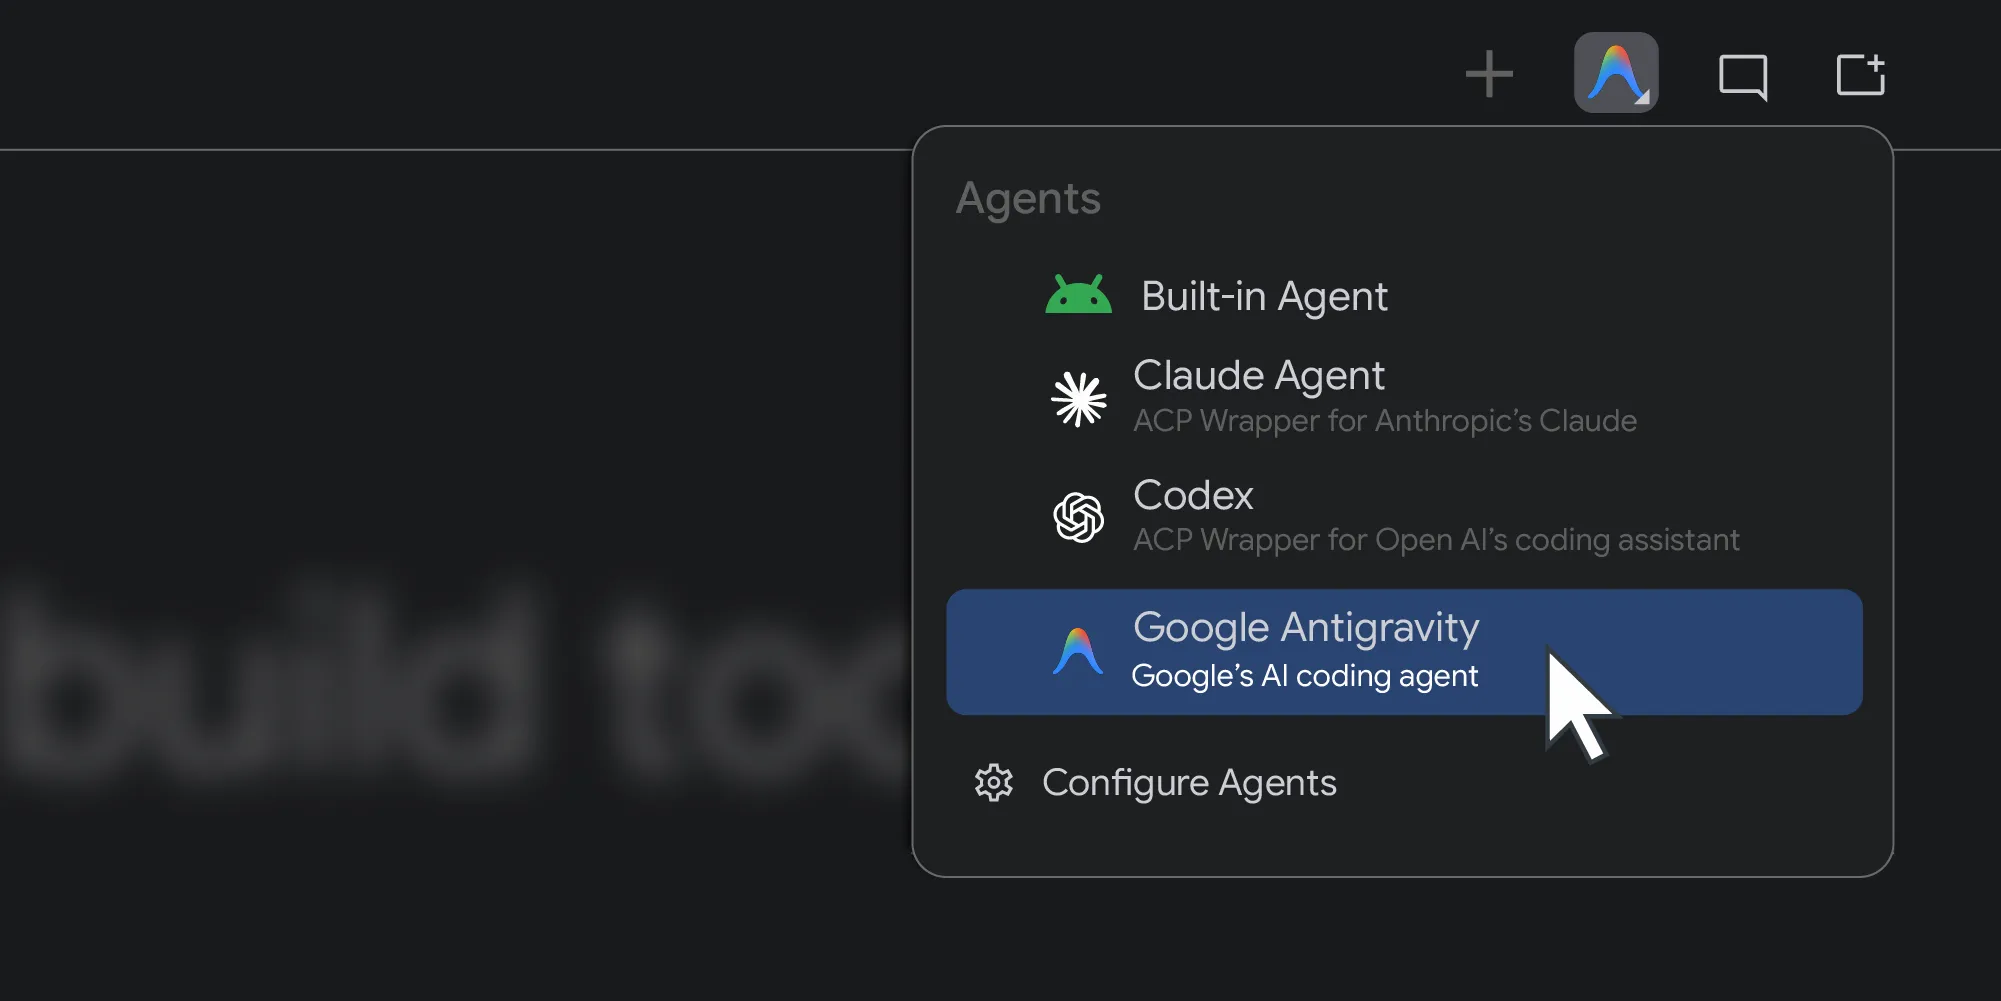
سال گذشته، Android Studio برای هر مدل هوش مصنوعی باز شد. امروز، با معرفی پشتیبانی از انتخاب شما برای عاملهای کدنویسی، گام بعدی را برمیداریم.
Matthew Warner • ۳ دقیقه خواندن -

 اخبار محصول
در ماه مارس، Android Bench را معرفی کردیم—جدول ردهبندی LLM ما برای وظایف توسعه Android در دنیای واقعی. از آن زمان، براساس بازخورد شما، معیار را بهبود دادهایم، ازجمله ارزیابی مدلهای وزن آزاد و افزودن ابعاد هزینه و کارایی به تابلوی امتیازات.
Zoe Lopez-Latorre • ۳ دقیقه خواندن
هر هفته جدیدترین اطلاعات آماری توسعه Android را در صندوق ورودیتان دریافت کنید.