تکامل نحوه اندازهگیری «مدلهای زبانی بزرگ» برای Android: عصر جدید Android Bench
۳ دقیقه خواندن

در ماه مارس، Android Bench—جدول رهبران مدل زبانی بزرگ ما برای وظایف توسعه Android در دنیای واقعی—را معرفی کردیم. هدف ما ارائه شفافیت درباره قابلیتهای مدل در توسعه Android و تشویق به بهبود مدلها بود تا گزینههای هوش مصنوعی مفیدتری برای گردش کار روزانهتان دراختیارتان قرار دهیم. از آن زمان، براساس بازخوردهای شما، معیار سنجش را بهبود دادهایم، ازجمله ارزیابی مدلهای وزن آزاد و افزودن ابعاد هزینه و کارایی به تابلوی امتیازات.
اما قابلیتهای هوش مصنوعی همواره درحال تکامل هستند و اندازهگیری باید از آنها پیروی کند. بهعنوان بخشی از نسخه انتشار ژوئیه، ما چارچوب Harbor را اتخاذ کردهایم که شامل نسخه بهروزشده عامل معیارگذاری مورداستفاده برای ارزیابی مدلها است.
همراه با این تغییر در ارزیابی خود، در این نسخه ژوئیه، ۸ مدل جدید (Claude Fable 5، Claude Sonnet 5، Claude Opus 4.8، GLM 5.2، Kimi K2.7 Code، MiniMax M3، Qwen 3.7 Plus، و Qwen 3.7 Max) را به تابلوی امتیازات اضافه میکنیم. همچنین فرصتهایی را برای شما، انجمن توسعهدهندگان Android، برای مشارکت در این معیار همرسانی میکنیم.
ارتقا روششناسی خود با چارچوب Harbor
وقتی Android Bench را طراحی کردیم، روششناسی خود را بر استانداردهای پیشرو صنعت که در آن زمان دردسترس بودند استوار کردیم. ما از mini-swe-agent v1، یک عامل معیار سنجش همهمنظوره، استفاده کردیم و آن را با ظرافتهای توسعه Android تطبیق دادیم تا یک اندازهگیری پایه برای قابلیتهای مدلها برای وظایف رایج توسعه Android ارائه دهیم.
برای اینکه همچنان ارزیابیهای پیشرفتهای دراختیارتان قرار دهیم که قابلیتهای جدیدترین مدل را در توسعه Android بهدقت اندازهگیری کند، معیار سنجش خود را به چارچوب Harbor استانداردسازی میکنیم. Harbor استانداردها و یکپارچگیهایی را تعریف میکند که اجرای محک را برای همه آسان میکند، تنظیمات ترجیحیشان را ارزیابی میکند، یا نتایج را همرسانی میکند – و به این ترتیب شفافیت و نمایان بودن بیشتری برای شما فراهم میکند.
این ارتقا به ما امکان میدهد مدلها و قابلیتهای آنها را با دقت بیشتری ارزیابی کنیم و معیار سنجش را روی همه مدلها دوباره اجرا کردیم تا مبنای بهروزشدهای ایجاد کنیم. این یعنی تغییر جزئی در امتیازدهی وجود دارد، اما همچنان میتوانید امتیازهای قبلی را در بایگانی در وبسایت ما مشاهده کنید.
میخواهیم مطمئن شویم Android Bench برای شما مفید است، بنابراین با پیشرفت ارزیابیهای ما و صنعت، آن را بهطور مداوم بهروزرسانی خواهیم کرد.
گسترش تابلو پیشتازان با ۸ مدل جدید
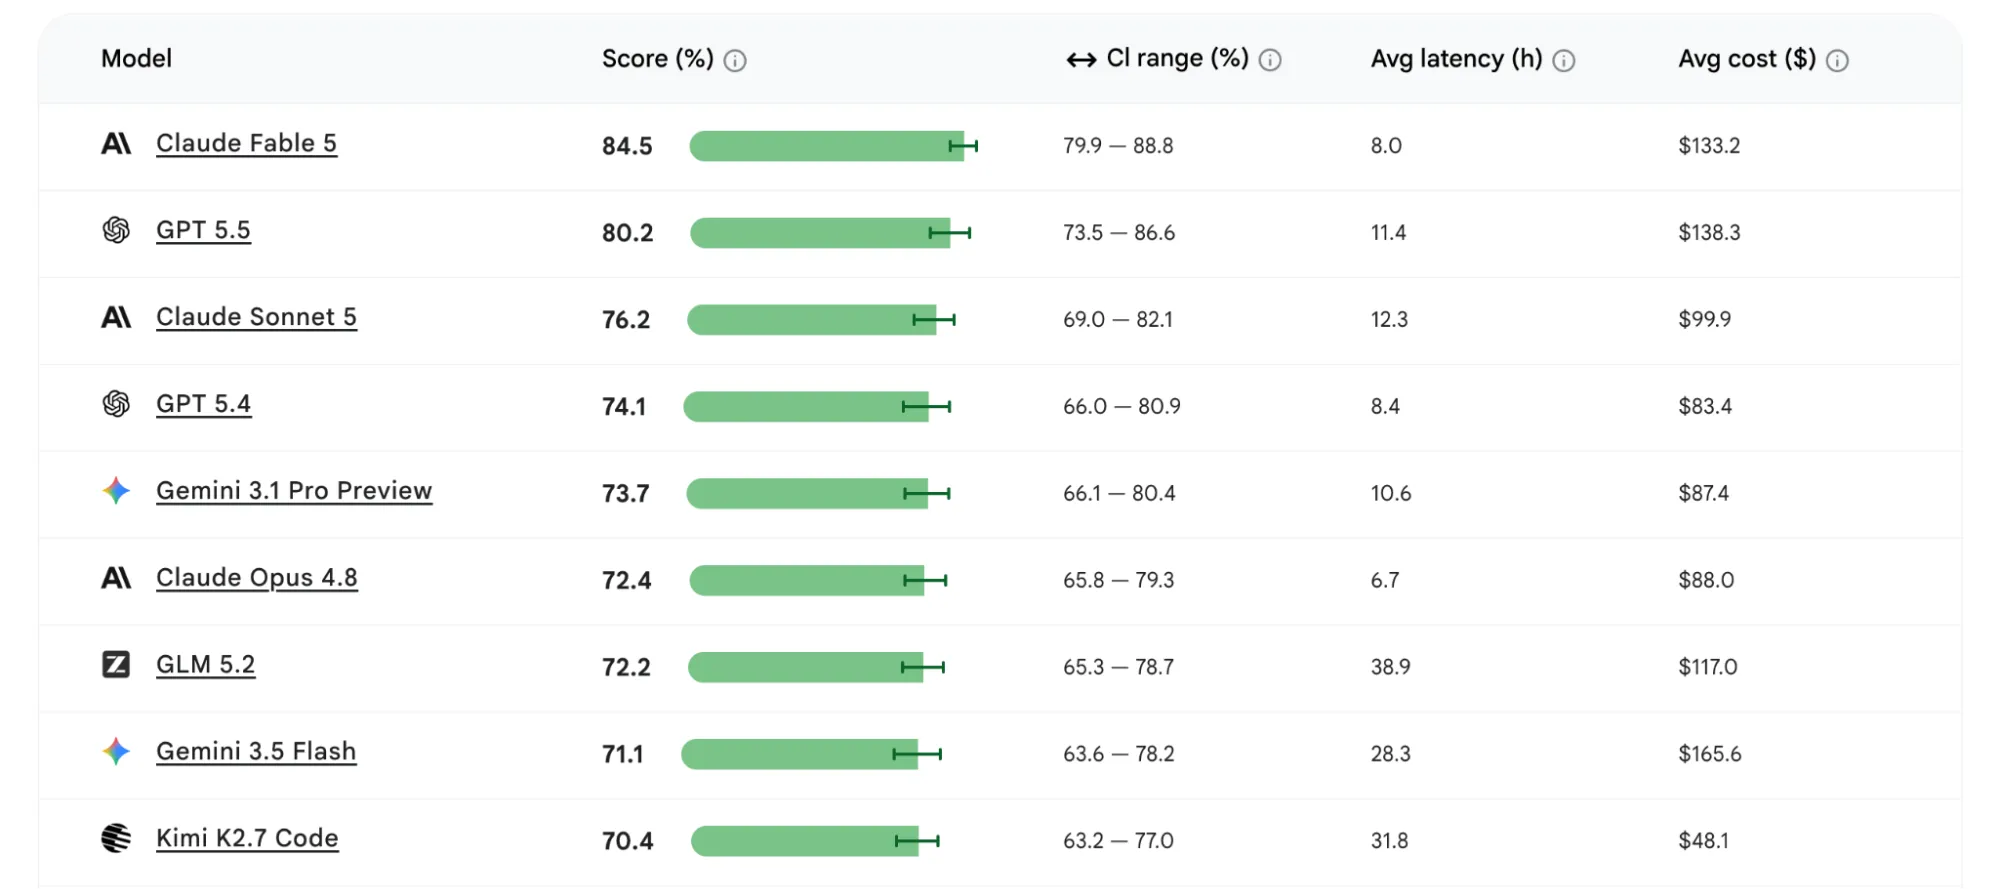
بهعنوان بخشی از تعهد ما به حفظ تازگی جدول پیشتازان، Claude Fable 5، Claude Sonnet 5، Claude Opus 4.8، GLM 5.2، Kimi K2.7 Code، MiniMax M3، Qwen 3.7 Plus، و Qwen 3.7 Max را به جدول پیشتازان Android Bench اضافه کردهایم.
میبینید که Claude Fable 5 با امتیاز ۸۴٫۵ در صدر تابلو پیشتازان قرار دارد و پساز آن GPT 5.5 با امتیاز ۸۰٫۲ و Claude Sonnet 5 با امتیاز ۷۶٫۲ در رتبه سوم قرار دارند.
وقتی فقط مدلهای Open-weight را مقایسه میکنیم، GLM 5.2 با امتیاز ۷۲٫۲ در صدر قرار دارد و پساز آن Kimi K2.7 Code با امتیاز ۷۰٫۴ قرار دارد.
میتوانید سنجههای عملکرد و کارایی مدل را در تابلوی امتیازات بهروزشده بررسی کنید تا ببینید این مدلهای جدید و قبلی چگونه چالشهای مختص Android مثل انتقال Jetpack Compose، شبکهسازی پوشیدنی، و بهروزرسانیهای API پلاتفرم را مدیریت میکنند.
باز کردن Android Bench برای همیاریهای انجمن
از ابتدا، ما رویکردی باز و شفاف را ارزشمند دانستهایم، به همین دلیل روششناسی اصلی و ابزار آزمایش خود را بهصورت عمومی در GitHub دردسترس قرار دادیم. شما درخواست کردهاید که راهی برای ارائه بازخورد درباره مجموعه دادههای ما داشته باشید، بنابراین اکنون با دادن فرصت شکلدهی Android Bench به شما، انجمن توسعهدهندگان Android، همکاری را یک گام جلوتر میبریم.
از امروز، میتوانید به دو روش در Android Bench همیاری کنید:
- برای ارزیابی نحوه مدیریت سناریوهایی که برایتان مهم است توسط مدلها، تکالیف توسعه Android خودتان را طراحی و ارسال کنید.
- ارزیابیهای معیار را اجرا و همرسانی کنید و مدلهای ترجیحیتان را دربرابر مجموعه داده ما یا تکالیف سفارشی خودتان آزمایش کنید.
تکالیف ارسالشده را بررسی خواهیم کرد و ارزیابی خواهیم کرد که آیا به معیار اضافه شوند یا نه. امیدواریم بتوانیم معیاری بسازیم که واقعاً نشاندهنده واقعیتهای متنوع و روزمره انجمن جهانی توسعهدهندگان Android باشد.
نگاه به آینده
با گزینههای بیشتر و بیشتر برای توسعه عاملگرا، حفظ یک معیار پیشرفته تضمین میکند که کمک هوش مصنوعی که به آن تکیه میکنید همچنان هوشمندتر، مفیدتر، و مؤثرتر شود. برای بررسی تکالیف، به مخزن GitHub ما مراجعه کنید. از شما دعوت میکنیم تکلیفی را برای بررسی به تیم ما ارسال کنید و میتوانید برای کاوش مجموعه داده یا ارسال ارزیابیها، Harbor Hub را بررسی کنید.
مثل همیشه، میتوانید جدول ردهبندی بهروزشده را پیدا کنید یا روششناسی را در وبسایت ما بخوانید.
-
 اخبار محصول
بهعنوان توسعهدهندگان Android، وقتی نوبت به انتخاب عاملها، مدلهای زبانی بزرگ، ابزارها، و میاناهای خط فرمان (CLI) میرسد که برای توسعه نرمافزار استفاده میکنید، گزینههای زیادی دارید. هدف ما این است که به شما کمک کنیم برنامههای Android زیبا و با کیفیت بالا بسازید، مهم نیست که چگونه میخواهید بسازید.
Simona Milanovic • ۴ دقیقه خواندن -
 اخبار محصول
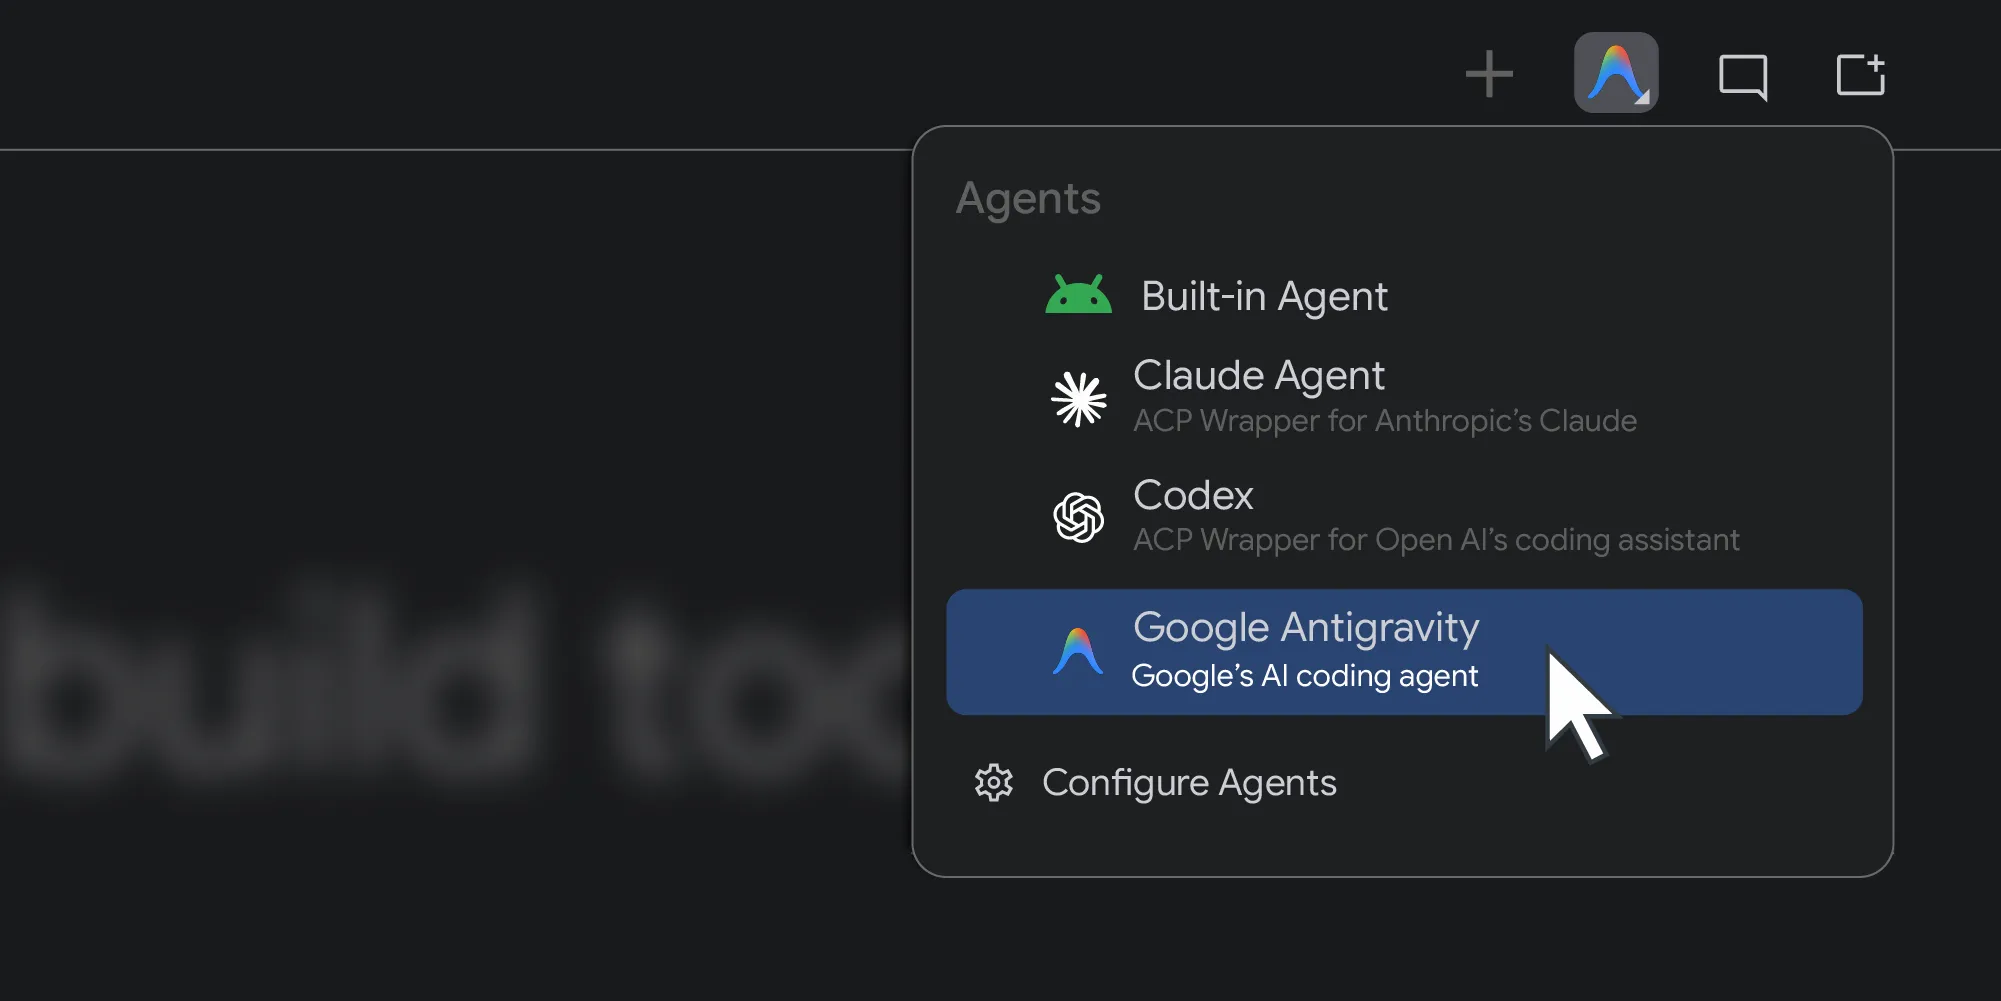
سال گذشته، Android Studio برای هر مدل هوش مصنوعی باز شد. امروز، با معرفی پشتیبانی از انتخاب شما برای عاملهای کدنویسی، گام بعدی را برمیداریم.
Matthew Warner • ۳ دقیقه خواندن -
 اخبار محصول
امروز اولین مجموعه از تکالیف بلندمدت (LHT) را منتشر میکنیم که تکالیف بسیار پیچیدهای هستند و تکمیل آنها چندین روز یا حتی یک هفته طول میکشد. همچنین ارزیابی عاملگرا را معرفی میکنیم که با نمایندگان ارائهدهندگان مدل مربوطه شروع میشود.
Matthew McCullough • ۳ دقیقه خواندن
هر هفته جدیدترین اطلاعات آماری توسعه Android را در صندوق ورودیتان دریافت کنید.