Android Bench 2.0 : repousser les limites avec des tâches complexes à long terme
Temps de lecture : 3 min
Lorsque nous avons lancé Android Bench, nous avons établi une base rigoureuse pour évaluer comment les grands modèles de langage (LLM) aident les développeurs à effectuer des tâches Android concrètes. Les modèles et agents d'IA évoluant rapidement, nous avons mis à jour notre méthodologie, par exemple en alignant notre framework de référence sur le framework Harbor. Aujourd'hui, nous lançons le premier ensemble de tâches à long terme. Il s'agit de tâches très complexes qui nécessitent plusieurs jours, voire une semaine, pour être accomplies par un ingénieur. Nous lançons également l'évaluation agentique, en commençant par les agents des fournisseurs de modèles correspondants. Cette nouveauté nous amène à Android Bench 2.0, une mise à niveau majeure conçue pour évaluer les modèles et agents d'IA en fonction de l'ampleur, de l'ambiguïté et de la résolution de problèmes complexes en plusieurs étapes auxquels vous êtes confrontés chaque jour.
Des corrections incrémentales aux tâches à long terme
La première itération d'Android Bench, ainsi que les premiers benchmarks de codage d'IA similaires, se sont concentrés sur les modifications incrémentales apportées aux dépôts existants, dans de nombreux cas limitées aux corrections de bugs ou aux demandes de fonctionnalités plus petites. Cela reflétait les capacités de l'assistance IA à l'époque, ainsi que la façon dont vous l'utilisiez.
Pour continuer à vous aider à trouver les modèles et les agents de codage les mieux adaptés à votre workflow de développement, nous avons relevé le niveau de nos évaluations pour qu'il corresponde au travail que vous déléguez à l'IA. Android Bench 2.0 reflète ces défis ambitieux avec des LHT qui incluent la mise à niveau des dépendances, l'ajout de nouvelles fonctionnalités, la création d'applications à partir de zéro ou la conversion d'une application multiplate-forme en application Android.
Les tâches complexes nécessitent une évaluation et une notation plus nuancées
Pour les tâches d'ingénierie sur plusieurs jours, une évaluation binaire (réussite/échec) ne donne pas une image complète.
Par exemple, un agent peut refactoriser 40 écrans vers Jetpack Compose, configurer des tables de base de données et répondre à 90% des exigences, mais échouer à une seule assertion de cas limite. Le score binaire de cette exécution est de 0%, ce qui masque les capacités architecturales du modèle. Nous passons à une évaluation continue pour fournir un signal plus pertinent, à la fois pour le développement de modèles et pour vous aider à comprendre comment l'IA peut vous aider.
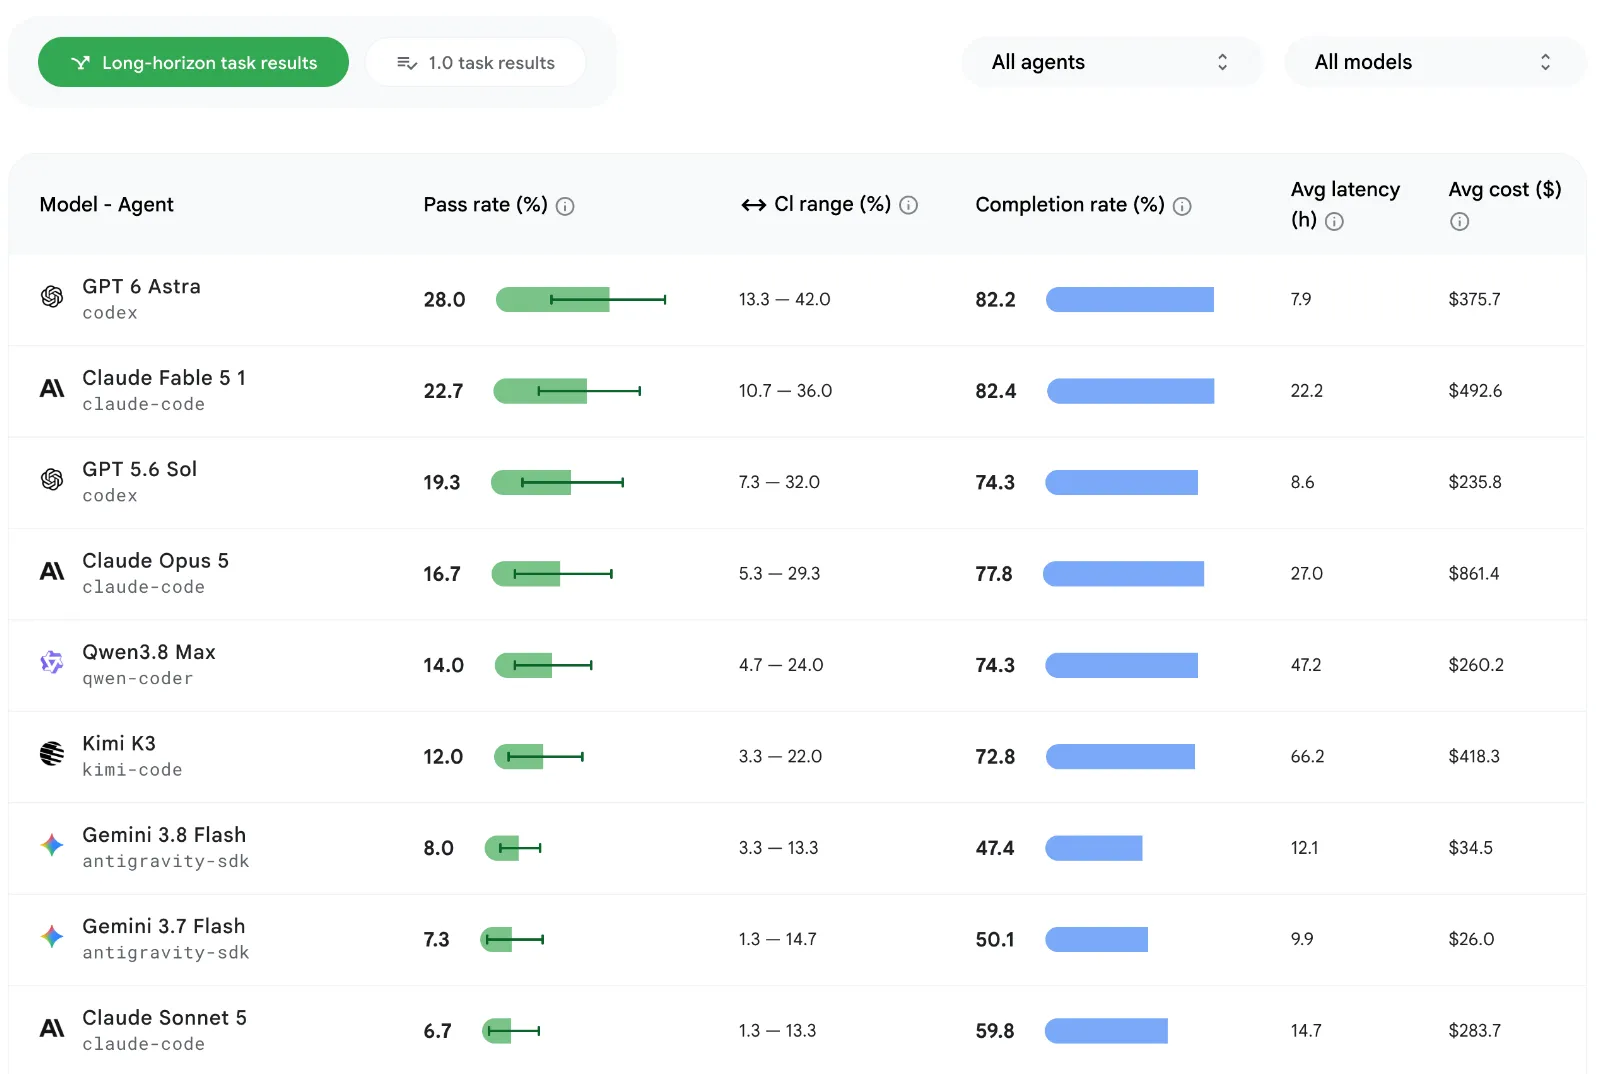
Nous calculons ce taux d'achèvement en combinant des facteurs tels que la fonctionnalité, la fidélité visuelle et l'évitement des régressions. Nous appliquons également des pénalités de score objectif en cas d'écart par rapport aux instructions d'évaluation ou aux contraintes structurelles. Consultez le classement mis à jour et cliquez sur la vue Fiche de chaque modèle pour afficher des éléments supplémentaires tels que le taux de réussite, le taux d'achèvement et les coûts moyens par modèle et par tâche.
Le taux de réussite le plus élevé pour les LHT est d'environ 28%, ce qui est beaucoup plus faible que les 91% environ pour les tâches d'origine dans le benchmark.

Les tâches à long terme permettent de découvrir des insights utiles pour l'assistance IA
Au-delà de la mesure de la capacité de l'IA à gérer les tâches de longue durée, l'ensemble de données LHT nous aide à en savoir plus sur les points forts et les points faibles des modèles testés, et nous vous proposons des conseils plus pratiques.
Tous niveaux de modèles confondus, l'IA est plus efficace pour écrire du code que pour refactoriser du code existant. Les refactorisations et les migrations deviennent plus délicates, car leur réussite dépend de la complexité de l'architecture plutôt que du volume de code.
Les modèles présentent de solides capacités en matière de transformations déterministes bien établies, comme la conversion de Java en Kotlin, le remplacement de Retrofit par Ktor ou l'introduction d'une couche ViewModel. Ils appliquent ces modèles de manière cohérente, même sur plus de 125 fichiers et 8 000 lignes de code.
Toutefois, les modèles ont du mal à gérer les tâches qui nécessitent une validation au moment de l'exécution (comme les graphiques d'injection de dépendances manquants), qui impliquent des modifications du framework ou qui présentent des lacunes en termes de connaissances avec des bibliothèques non publiées. Le portage d'applications multiplates-formes vers Android reste un défi ouvert : aucun modèle n'atteint un taux de réussite de 100% et les modèles de pointe atteignent au maximum un taux d'achèvement de 80 %.
Présentation des évaluations des agents
Pour vous aider à mieux comprendre les performances des modèles lorsqu'ils sont intégrés à vos workflows agentiques, nous ajoutons des agents couramment utilisés à notre évaluation. Nous commençons par exécuter de nouveaux modèles sur les LHT avec des agents du fournisseur de modèles correspondant. Par exemple, nous avons exécuté GPT-5.6 Sol sur Codex et Gemini 3.8 Flash sur Google Antigravity. Cette association montre comment la conception du harnais a un impact positif sur les résultats des développeurs. En effet, nous avons constaté que la mise en cache des requêtes et le fenêtrage compact des outils peuvent entraîner une réduction des jetons.
À l'avenir, nous allons étendre cette fonctionnalité en mettant également en avant les résultats obtenus avec différentes combinaisons de modèles et d'agents. Vous pourrez ainsi découvrir celles qui conviennent le mieux à vous et à votre équipe.
Nous investissons dans cette mesure, car il est important que vous puissiez utiliser l'agent et le modèle de votre choix pour le développement Android. Nous vous en dirons plus dans les prochaines semaines.
Nouveaux modèles ajoutés
De plus, nous continuons à étendre notre classement pour vous assurer de disposer des données les plus récentes pour vos décisions de développement. Nous avons ajouté Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 d'OpenAI, Fable 5.1 d'Anthropic, Kimi K3 et Qwen 3.8 Max. GPT-6 Astra d'OpenAI arrive en tête avec un taux de réussite de 28%.
Perspectives d'avenir
Android Bench 2.0 fournit un environnement robuste pour mesurer l'IA pour le développement Android. En combinant des tâches à long terme, une évaluation multimodale, des agents et une notation continue, nous espérons permettre aux équipes de recherche en IA de créer des partenaires de programmation d'IA plus performants et fiables, et vous offrir plus de transparence sur vos options de développement de l'IA.
Consultez le classement mis à jour et la méthodologie mise à jour. Vos commentaires ont une influence directe sur l'évolution d'Android Bench. N'hésitez donc pas à continuer à nous les envoyer sur GitHub, ainsi que sur nos réseaux sociaux comme X et LinkedIn.
-
 Nouveautés produit
L'année dernière, Android Studio s'est ouvert à tous les modèles d'IA. Aujourd'hui, nous franchissons une nouvelle étape en vous permettant de choisir vos agents de programmation.
Matthew Warner • Temps de lecture : 3 min -

 Nouveautés produit
En mars dernier, nous avons lancé Android Bench, notre classement des LLM pour les tâches de développement Android concrètes. Depuis, nous avons amélioré le benchmark en fonction de vos commentaires, y compris en évaluant les modèles open-weight et en ajoutant des dimensions de coût et d'efficacité au classement.
Zoe Lopez-Latorre • Temps de lecture : 3 min -
 Nouveautés produit
Aujourd'hui, nous lançons Android 17 et le rendons disponible sur la plupart des appareils Pixel compatibles. De nouveaux appareils fonctionnant sous Android 17 seront disponibles dans les prochains mois.
Matthew McCullough • Temps de lecture : 13 min
Recevez chaque semaine les dernières informations sur le développement Android directement dans votre boîte de réception.