Évolution de la mesure des LLM pour Android : une nouvelle ère pour Android Bench
Temps de lecture : 3 min

En mars dernier, nous avons lancé Android Bench, notre classement des LLM pour les tâches de développement Android concrètes. Notre objectif était de fournir des informations transparentes sur les capacités des modèles dans le développement Android et d'encourager l'amélioration des modèles, afin de vous offrir des options d'IA plus utiles pour votre workflow quotidien. Depuis, nous avons amélioré le benchmark en fonction de vos commentaires, y compris en évaluant les modèles open-weight et en ajoutant des dimensions de coût et d'efficacité au classement.
Mais les capacités de l'IA évoluent constamment, et les mesures doivent suivre le mouvement. Dans notre version de juillet, nous avons adopté le framework Harbor, qui inclut une version mise à jour de l'agent de benchmarking utilisé pour évaluer les modèles.
En plus de cette modification de notre évaluation, nous ajoutons huit nouveaux modèles (Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus et Qwen 3.7 Max) au classement dans cette version de juillet. Nous vous proposons également, à vous, la communauté des développeurs Android, de contribuer à ce benchmark.
Mise à niveau de notre méthodologie avec le framework Harbor
Lorsque nous avons conçu Android Bench, nous avons basé notre méthodologie sur les principales normes du secteur disponibles à l'époque. Nous avons utilisé mini-swe-agent v1, un agent de benchmarking à usage général, et l'avons adapté aux spécificités du développement Android pour fournir une mesure de référence des capacités des modèles pour les tâches courantes de développement Android.
Pour continuer à vous fournir des évaluations de pointe qui mesurent précisément les dernières capacités des modèles pour le développement Android, nous standardisons notre benchmark sur le framework Harbor. Harbor définit des normes et des intégrations qui permettent à chacun d'exécuter le benchmark, d'évaluer la configuration de son choix ou de partager des résultats, ce qui vous offre plus de transparence et de visibilité.
Cette mise à niveau nous permet d'évaluer plus rigoureusement les modèles et leurs capacités. Nous avons réexécuté le benchmark sur tous les modèles pour établir une référence mise à jour. Cela signifie que le score a légèrement changé, mais vous pourrez toujours consulter l'historique des scores dans les archives de notre site Web.
Nous voulons nous assurer qu'Android Bench vous est utile. Nous le mettrons donc à jour en permanence à mesure que nos évaluations et le secteur évolueront.
Élargissement du classement avec huit nouveaux modèles
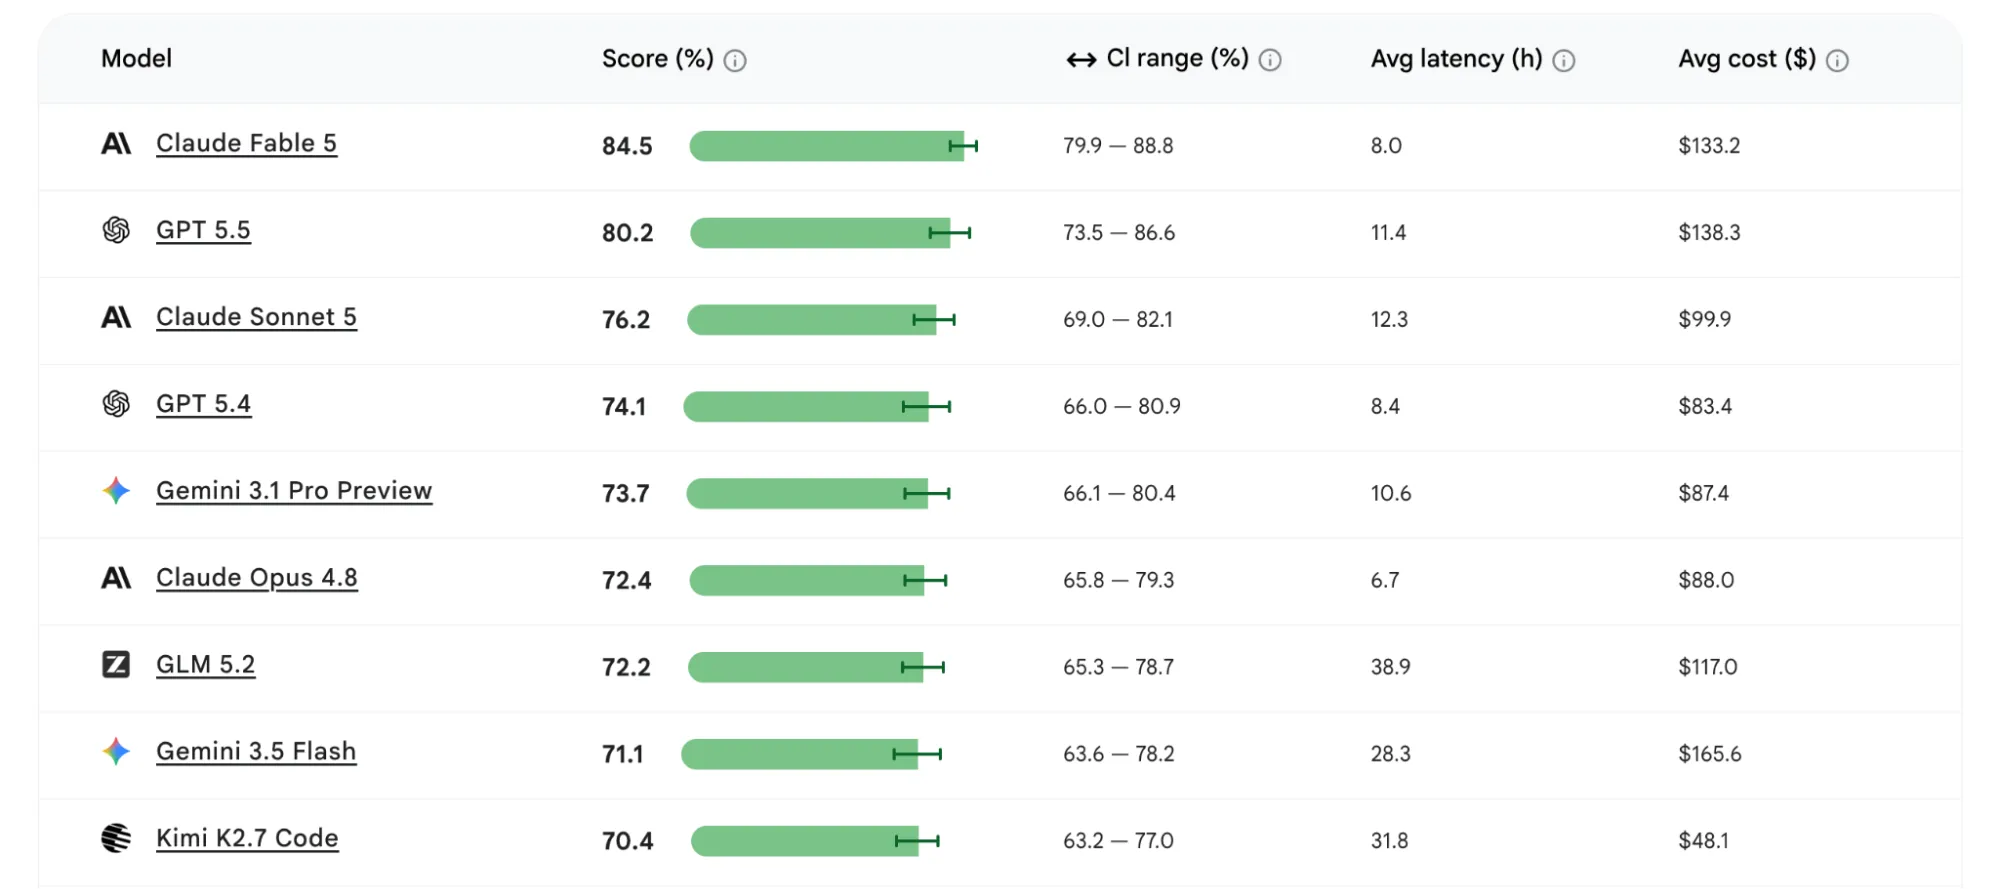
Afin de maintenir l'actualité du classement, nous avons ajouté Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus et Qwen 3.7 Max au classement Android Bench.
Vous remarquerez que Claude Fable 5 est en tête du classement avec un score de 84,5, suivi de GPT 5.5 avec 80,2, et de Claude Sonnet 5 en troisième position avec un score de 76,2.
Si l'on ne compare que les modèles à pondération ouverte, GLM 5.2 arrive en tête avec 72,2, suivi de Kimi K2.7 Code avec un score de 70,4.
Vous pouvez consulter les métriques de performances et d'efficacité des modèles dans le classement mis à jour pour voir comment ces modèles (nouveaux et anciens) relèvent les défis spécifiques à Android, comme les migrations Jetpack Compose, la mise en réseau des wearables et les mises à jour des API de plate-forme.
Ouverture d'Android Bench aux contributions de la communauté
Depuis le début, nous avons privilégié une approche ouverte et transparente. C'est pourquoi nous avons rendu notre méthodologie et notre banc d'essai d'origine accessibles au public sur GitHub. Vous nous avez demandé de pouvoir nous faire part de vos commentaires sur notre ensemble de données. Nous allons donc plus loin dans la collaboration en vous donnant, à vous, la communauté des développeurs Android, la possibilité de façonner Android Bench.
À partir d'aujourd'hui, vous pouvez contribuer à Android Bench de deux manières :
- Concevez et envoyez vos propres tâches de développement Android pour évaluer la façon dont les modèles gèrent les scénarios qui vous intéressent.
- Exécutez et partagez des évaluations comparatives en testant directement vos modèles préférés par rapport à notre ensemble de données ou à vos propres tâches personnalisées.
Nous examinerons les tâches envoyées et déterminerons si elles doivent être ajoutées au benchmark. Nous espérons créer une référence qui reflète réellement les réalités quotidiennes et diverses de la communauté mondiale des développeurs Android.
Perspectives
Avec le nombre croissant d'options de développement agentique, le maintien d'un benchmark de pointe garantit que l'assistance IA sur laquelle vous vous appuyez continue de devenir plus intelligente, plus utile et plus efficace. Accédez à notre dépôt GitHub pour consulter les tâches. Nous vous invitons à envoyer une tâche à notre équipe pour examen. Vous pouvez également consulter Harbor Hub pour explorer l'ensemble de données ou envoyer des évaluations.
Comme toujours, vous pouvez consulter le classement mis à jour ou lire la méthodologie sur notre site Web.
-
 Nouveautés produit
L'année dernière, Android Studio s'est ouvert à tous les modèles d'IA. Aujourd'hui, nous franchissons une nouvelle étape en vous permettant de choisir vos agents de programmation.
Matthew Warner • Temps de lecture : 3 min -
 Nouveautés produit
Aujourd'hui, nous lançons le premier ensemble de tâches à long terme (LHT, Long-Horizon Tasks). Il s'agit de tâches très complexes qui nécessitent plusieurs jours, voire une semaine, pour être accomplies par un ingénieur. Nous lançons également l'évaluation agentique, en commençant par les agents des fournisseurs de modèles correspondants.
Matthew McCullough • Temps de lecture : 3 min -
 Nouveautés produit
Sur Google Play, nous développons sans cesse notre plate-forme d'abonnement pour vous aider à développer votre activité, à vous adapter à de nouveaux modèles économiques et à toucher vos utilisateurs là où ils se trouvent.
Sheenam Mittal • Temps de lecture : 4 min
Recevez chaque semaine les dernières informations sur le développement Android directement dans votre boîte de réception.