Android Bench 2.0: новые сложные задачи с длительным горизонтом планирования
Время на чтение: 3 минуты
Когда мы впервые запустили Android Bench, мы создали надежную основу для оценки того, как большие языковые модели (LLM) помогают разработчикам выполнять реальные задачи Android. Поскольку модели и агенты ИИ быстро развиваются, мы постоянно совершенствуем нашу методологию, например приводим контрольные показатели в соответствие с фреймворком Harbor. Сегодня мы выпускаем первый набор задач с длительным горизонтом (LHT) – очень сложных задач, на выполнение которых у инженера уходит несколько дней или даже неделя. Мы также представляем агентную оценку, начиная с агентов от соответствующих поставщиков моделей. Теперь в Android Bench 2.0 – значительно улучшенном наборе инструментов для оценки моделей и агентов ИИ – можно проверять, как они справляются с масштабными, неоднозначными и сложными многоэтапными задачами, с которыми вы сталкиваетесь каждый день.
От небольших исправлений до долгосрочных задач
Первая версия Android Bench, как и других ранних тестов для ИИ, была ориентирована на небольшие изменения в существующих репозиториях, часто ограничиваясь исправлением ошибок или небольшими запросами на добавление функций. Это было связано с возможностями ИИ-помощника на тот момент и с тем, как вы его использовали.
Чтобы помочь вам найти модели и агентов для кодирования, которые лучше всего подходят для вашего рабочего процесса, мы повысили требования к оценке ИИ. Android Bench 2.0 отражает эти амбициозные задачи с помощью LHT, которые включают обновление зависимостей, добавление новых функций, создание приложений с нуля или преобразование кроссплатформенного приложения в Android.
Для сложных задач требуется более детальная оценка.
При выполнении многодневных инженерных задач бинарная оценка не позволяет получить полную картину.
Например, агент может перенести 40 экранов в Jetpack Compose, настроить таблицы базы данных и выполнить 90% требований, но не пройти проверку в одном пограничном случае. При использовании двоичной оценки этот запуск получает 0%, что скрывает архитектурные возможности модели. Мы переходим на непрерывную оценку, чтобы предоставлять более значимые сигналы как для разработки моделей, так и для понимания того, как ИИ может вам помочь.
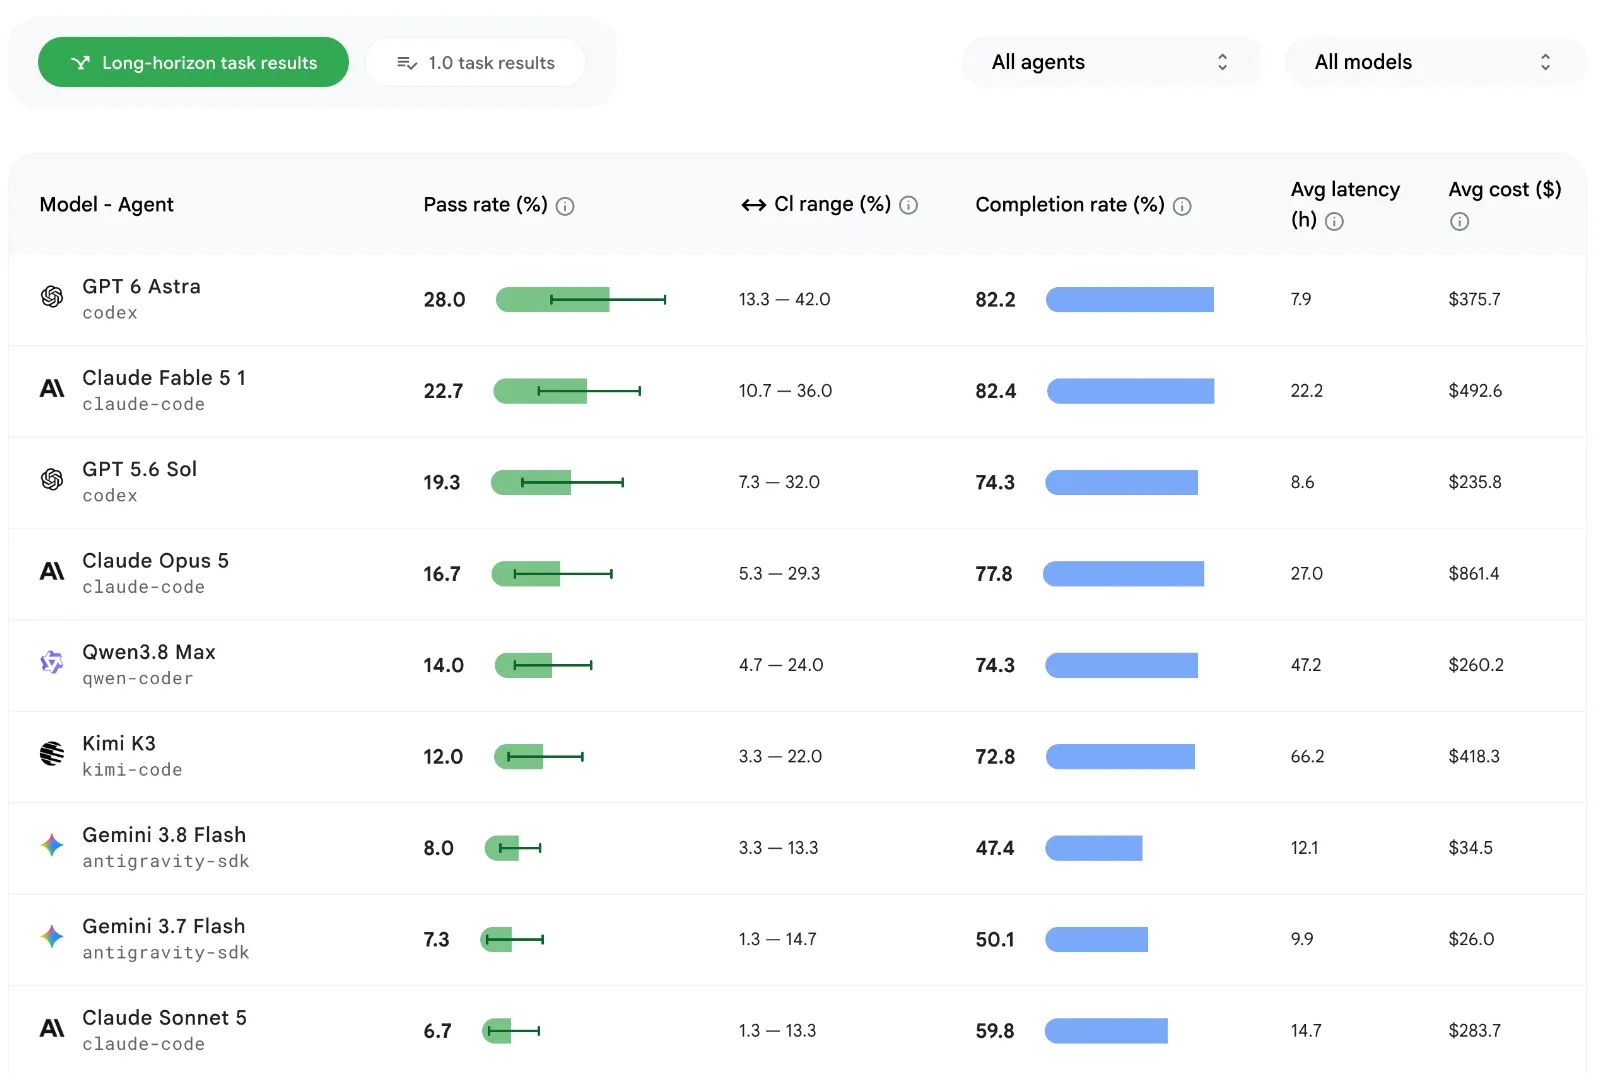
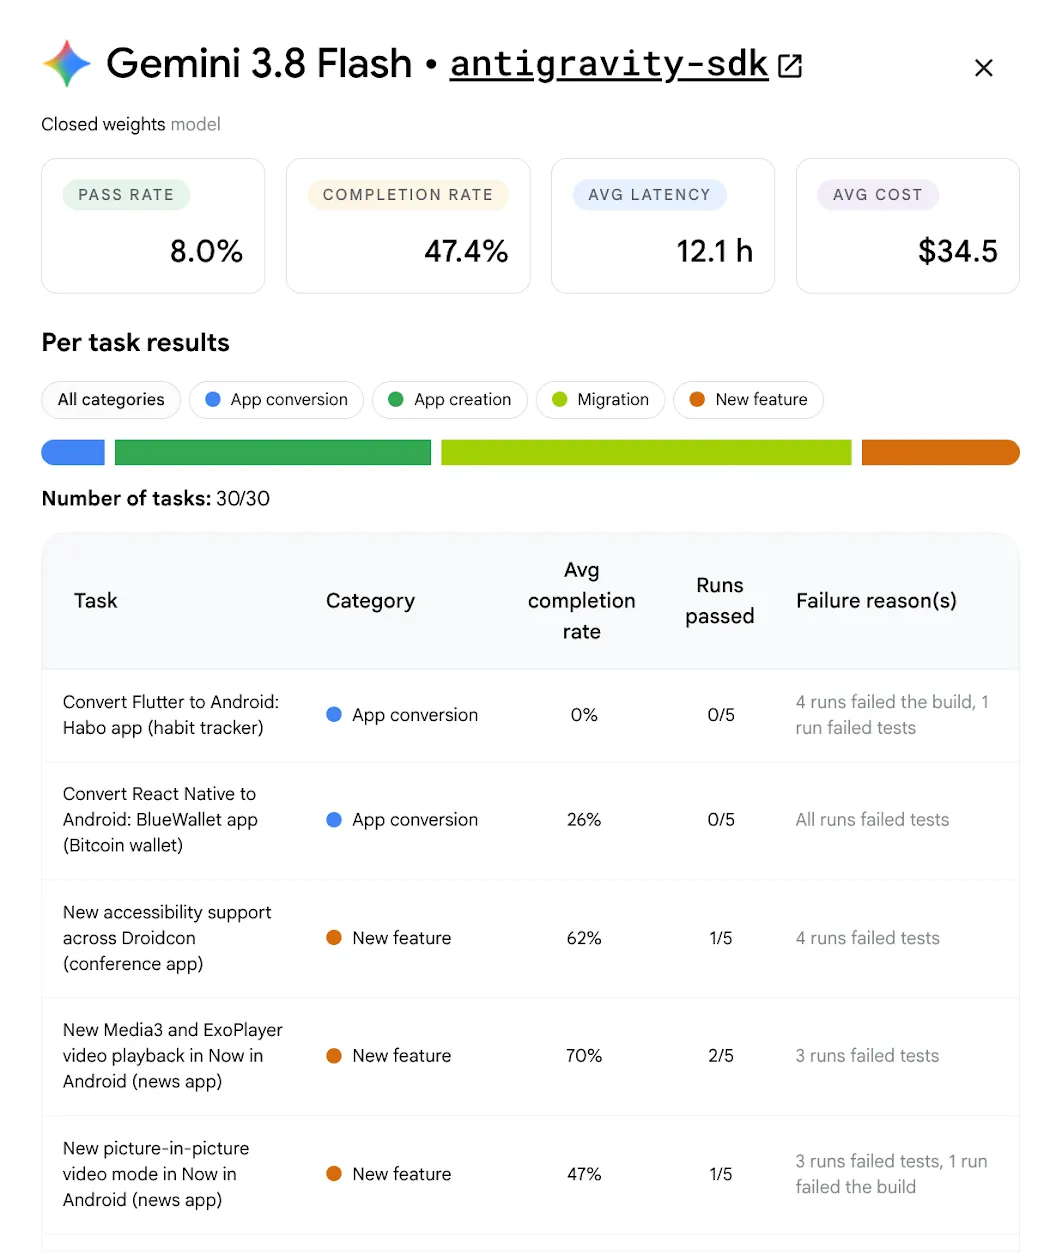
Мы рассчитываем этот показатель на основе ряда факторов, таких как функциональность, визуальная точность и отсутствие регрессий. Мы также применяем объективные штрафы за отклонения от инструкций по оценке или структурных ограничений. Посмотрите обновленную таблицу лидеров и нажмите на карточку модели, чтобы увидеть дополнительные элементы, такие как процент прохождения, процент выполнения и средние затраты на модель и задачу.
Самый высокий процент правильных ответов на задачи LHT составляет около 28%, что намного ниже, чем у исходных задач (91 %).
Задачи с длительным горизонтом помогают ИИ лучше понимать контекст
Помимо оценки того, насколько хорошо ИИ справляется с долгосрочными задачами, набор данных LHT помогает нам лучше понять сильные и слабые стороны тестируемых моделей и предлагать вам более практические рекомендации.
На всех уровнях модели ИИ лучше справляются с написанием нового кода, чем с рефакторингом существующего. Рефакторинг и перенос становятся сложнее, поскольку успех зависит от архитектурной сложности, а не от объема кода.
Модели хорошо справляются с детерминированными преобразованиями, например с переводом кода с Java на Kotlin, заменой Retrofit на Ktor или добавлением слоя ViewModel. Они последовательно применяют эти шаблоны, даже если в проекте более 125 файлов и 8000 строк кода.
Однако модели испытывают трудности, когда задачи требуют проверки во время выполнения (например, отсутствуют графы внедрения зависимостей), связаны с изменениями в фреймворке или с пробелами в знаниях о невыпущенных библиотеках. Перенос кросс-платформенных приложений на Android по-прежнему представляет собой сложную задачу: ни одна модель не проходит все тесты, а самые передовые модели достигают максимум 80 % успешных результатов.
Оценка агентов
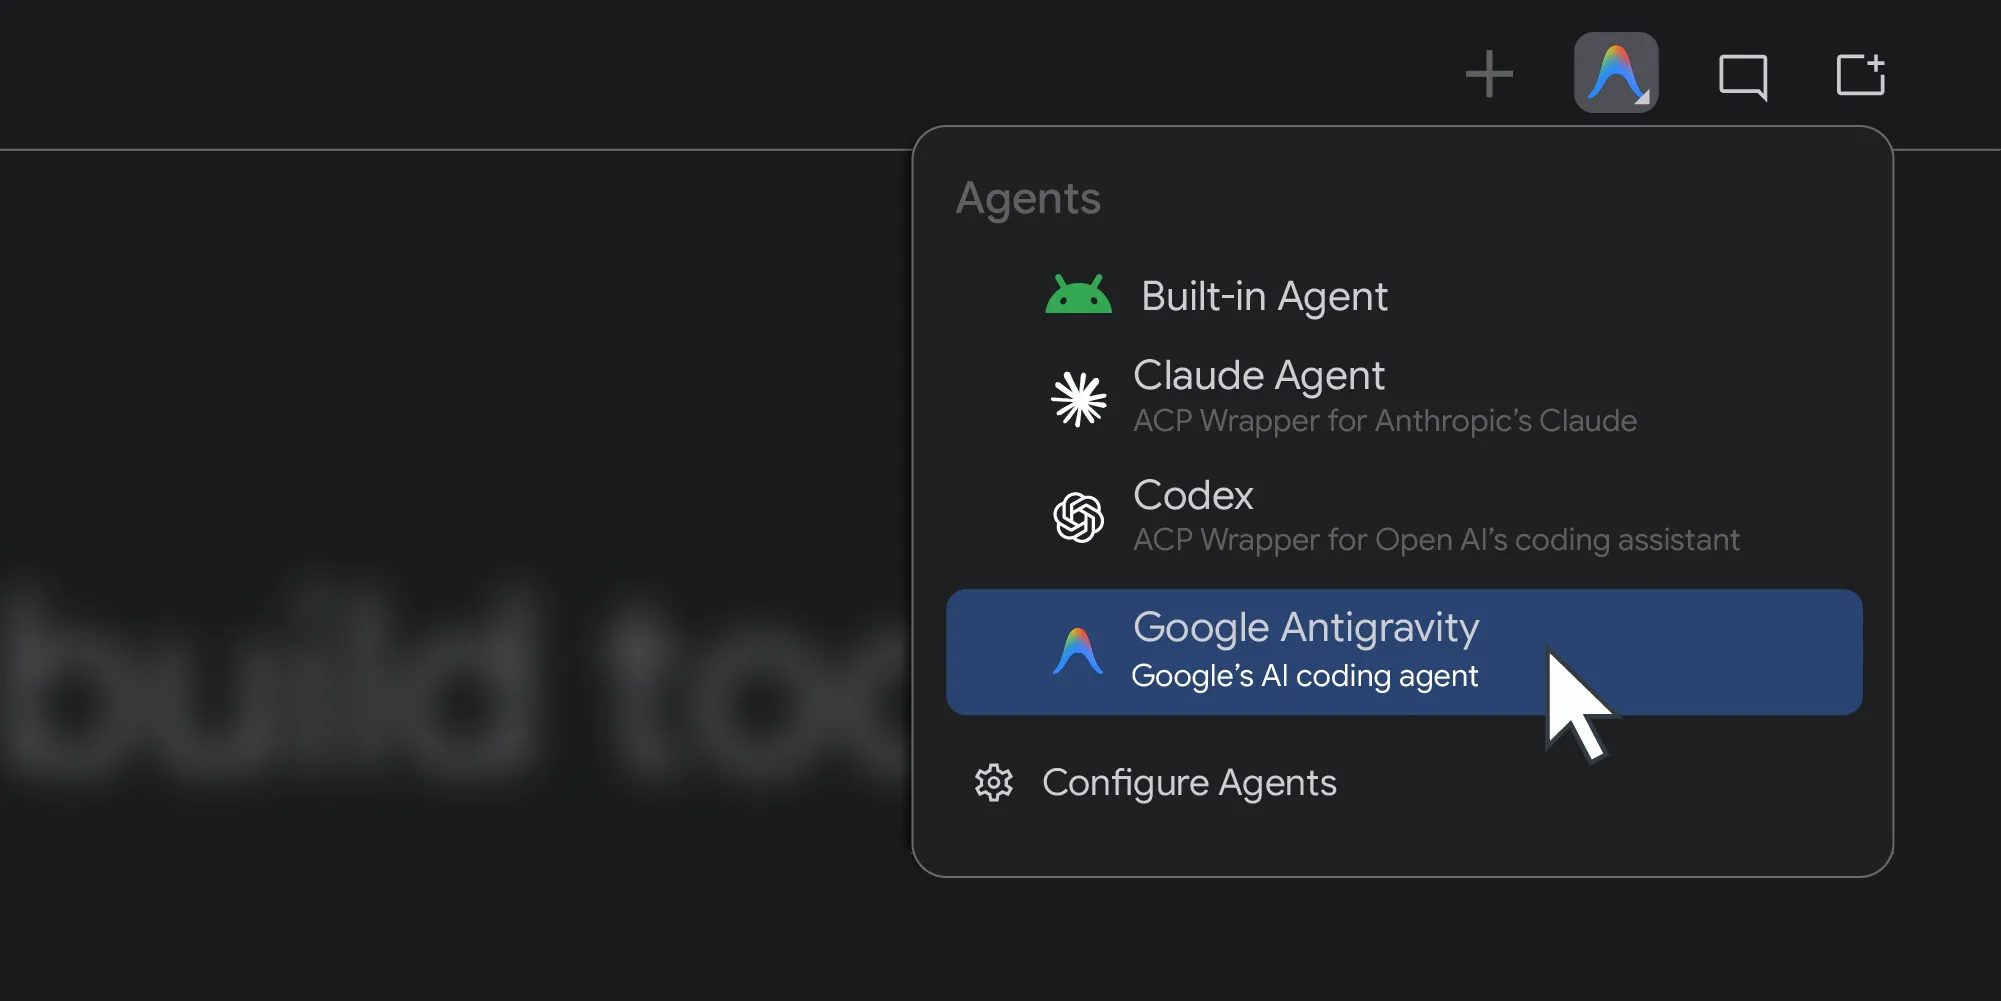
Чтобы вам было проще понять, как модели работают в ваших рабочих процессах, мы добавили в оценку часто используемых агентов. Мы начали с того, что запустили новые модели на основе LHT с агентами от поставщика соответствующей модели. Например, мы запустили GPT 5.6 Sol на Codex, а Gemini 3.8 Flash – на Google Antigravity. Это сочетание показывает, как дизайн Harness положительно влияет на результаты разработчиков, поскольку мы заметили, что кеширование запросов и компактное размещение окон инструментов могут привести к сокращению количества токенов.
В будущем мы добавим возможность выделять результаты, полученные с помощью разных моделей и агентов, чтобы вам было проще понять, какие сочетания лучше всего подходят вам и вашей команде.
Мы инвестируем в эту функцию, потому что считаем, что вы должны иметь возможность использовать для разработки под Android любого агента и любую модель. В ближайшие недели мы расскажем вам больше.
Добавлены новые модели
Кроме того, мы продолжаем расширять таблицу лидеров, чтобы вы могли принимать решения на основе актуальных данных. Мы добавили Gemini 3.8 Flash, Gemini 3.7 Flash, OpenAI GPT-6, Anthropic Fable 5.1, Kimi K3 и Qwen 3.8 Max. Лучший результат (28 %) показала модель OpenAI GPT-6 Astra.
Перспективы
Android Bench 2.0 – это надежная среда для оценки ИИ при разработке приложений для Android. Мы надеемся, что сочетание задач с длинным горизонтом, мультимодальной оценки, агентов и непрерывного подсчета баллов поможет командам по исследованию ИИ создавать более эффективных и надежных ИИ-партнеров по программированию, а также предоставит вам больше информации о возможностях разработки ИИ.
Ознакомьтесь с обновленной таблицей лидеров и обновленной методологией. Ваши отзывы напрямую влияют на развитие Android Bench, поэтому мы просим вас и дальше делиться своим мнением на GitHub, а также в наших социальных сетях, таких как X и LinkedIn.
-
 Новости продуктов
У разработчиков Android есть множество вариантов выбора агентов, больших языковых моделей (LLM), инструментов и интерфейсов командной строки (CLI), которые можно использовать для разработки приложений. Наша цель – помочь вам создавать красивые и качественные приложения для Android, независимо от того, как вы это делаете.
Simona Milanovic • Время на чтение: 4 минуты -
 Новости продуктов
В прошлом году мы открыли Android Studio для любых моделей ИИ. Сегодня мы делаем следующий шаг и добавляем поддержку агентов для написания кода.
Matthew Warner • Время на чтение: 3 минуты -
 Новости продуктов
В марте мы представили Android Bench – рейтинг LLM для задач, связанных с реальной разработкой под Android. С тех пор мы улучшили бенчмарк на основе ваших отзывов, в том числе добавили оценку моделей с открытым весом и параметры стоимости и эффективности в таблицу лидеров.
Zoe Lopez-Latorre • Время на чтение: 3 минуты
Получайте свежие новости о разработке приложений для Android на свою электронную почту каждую неделю.