Новый подход к оценке LLM для Android: следующая эпоха Android Bench
Время на чтение: 3 минуты
В марте мы представили Android Bench – таблицу лидеров LLM для задач разработки под Android. Мы хотели сделать возможности моделей более прозрачными для разработчиков Android и стимулировать их улучшение, чтобы вы могли использовать более полезные ИИ-функции в своей повседневной работе. С тех пор мы улучшили бенчмарк на основе ваших отзывов, в том числе добавили оценку моделей с открытым весом и добавили в таблицу лидеров параметры стоимости и эффективности.
Однако возможности ИИ постоянно развиваются, и методы сбора данных должны соответствовать этим изменениям. В рамках июльского выпуска мы внедрили фреймворк Harbor, в который входит обновленная версия агента для сравнительного тестирования моделей.
Вместе с изменением подхода к оценке в июльском выпуске мы добавили в таблицу лидеров восемь новых моделей: Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus и Qwen 3.7 Max. Мы также расскажем, как вы, разработчики приложений для Android, можете помочь нам в создании эталона.
Улучшение методологии с помощью фреймворка Harbor
При разработке Android Bench мы опирались на ведущие отраслевые стандарты, доступные на тот момент. Мы использовали универсального агента для тестирования mini-swe-agent v1 и адаптировали его к особенностям разработки под Android, чтобы получить базовые показатели возможностей моделей для выполнения распространенных задач.
Чтобы и дальше предоставлять вам современные оценки, точно отражающие возможности последних моделей в разработке для Android, мы стандартизируем наш бенчмарк на основе фреймворка Harbor. Harbor определяет стандарты и интеграции, которые позволяют любому пользователю запускать тесты, оценивать предпочитаемые настройки и делиться результатами, обеспечивая дополнительную прозрачность и видимость.
Это обновление позволяет нам более тщательно оценивать модели и их возможности. Мы повторно провели тестирование всех моделей, чтобы получить актуальные базовые показатели. Это означает, что оценки немного изменятся, но вы по-прежнему сможете просматривать их в архиве на нашем сайте.
Мы хотим, чтобы Android Bench был полезен для вас, поэтому будем постоянно обновлять его по мере развития наших оценок и отрасли.
Добавление в таблицу лидеров восьми новых моделей
Мы добавили в рейтинг Android Bench новые модели: Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus и Qwen 3.7 Max.
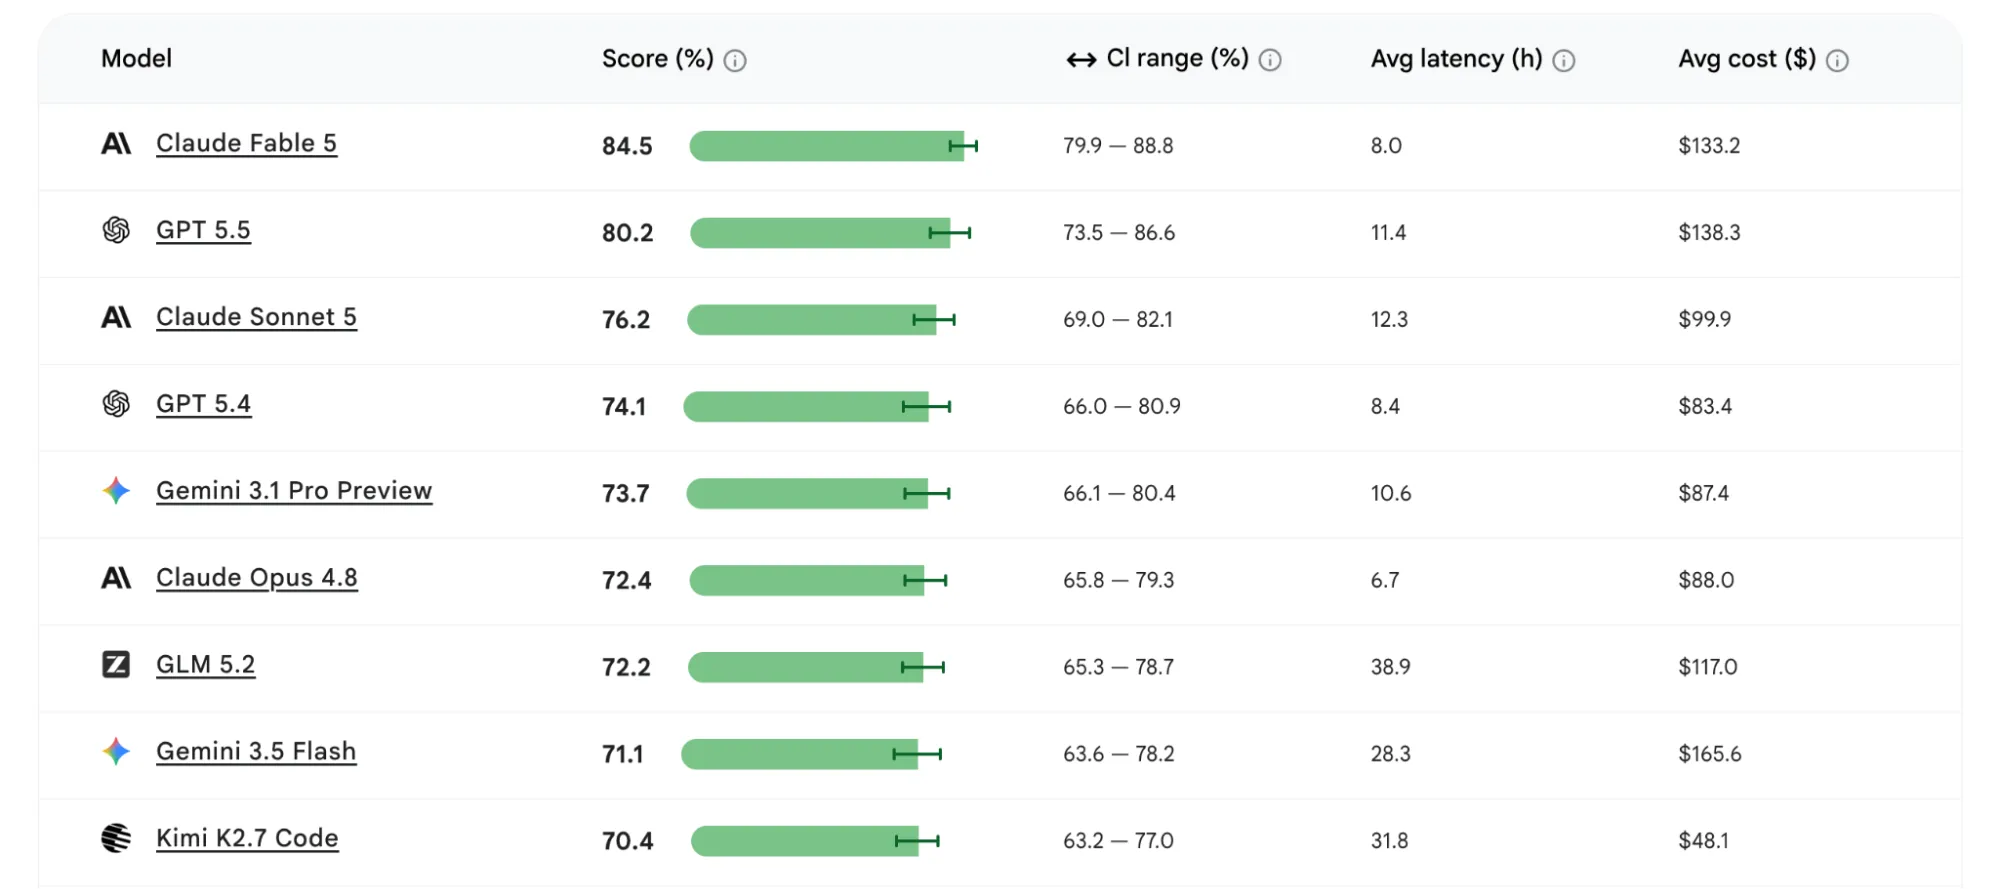
Вы увидите, что Claude Fable 5 занимает первое место с результатом 84,5, за ним следует GPT 5.5 с результатом 80,2, а на третьем месте – Claude Sonnet 5 с результатом 76,2.
Если сравнивать только модели с открытым исходным кодом, то GLM 5.2 занимает первое место с результатом 72,2, а Kimi K2.7 Code – второе с результатом 70,4.
В обновленной таблице лидеров можно посмотреть показатели эффективности и производительности моделей, чтобы узнать, как новые и предыдущие модели справляются с задачами, связанными с Android, например с переносом Jetpack Compose, работой в сети носимых устройств и обновлениями API платформы.
Открываем Android Bench для участия сообщества
С самого начала мы придерживались открытого и прозрачного подхода, поэтому опубликовали на GitHub исходную методологию и тестовый стенд. Мы решили сделать сотрудничество ещё более тесным и предоставить вам, сообществу разработчиков Android, возможность влиять на развитие Android Bench.
С сегодняшнего дня вы можете внести свой вклад в развитие Android Bench двумя способами:
- Создавайте и отправляйте собственные задачи по разработке для Android, чтобы оценить, как модели справляются с важными для вас сценариями.
- Проводите и публикуйте оценки производительности, тестируя предпочитаемые вами модели на нашем наборе данных или собственных задачах.
Мы проверим отправленные задачи и решим, добавлять ли их в контрольный показатель. Мы хотим создать ориентир, который будет отражать повседневные реалии сообщества разработчиков Android.
Планы на будущее
Поскольку вариантов разработки агентных систем становится все больше, поддержание передового стандарта гарантирует, что ИИ-помощник, на который вы полагаетесь, будет становиться умнее, полезнее и эффективнее. Ознакомиться с задачами можно в нашем репозитории GitHub. Вы можете отправить нам задание на проверку и изучить набор данных или отправить оценки на сайте Harbor Hub.
Как всегда, вы можете посмотреть обновленный рейтинг или ознакомиться с методологией на нашем сайте.
-
 Новости продуктов
У разработчиков Android есть множество вариантов выбора агентов, больших языковых моделей (LLM), инструментов и интерфейсов командной строки (CLI), которые можно использовать для разработки приложений. Наша цель – помочь вам создавать красивые и качественные приложения для Android, независимо от того, как вы это делаете.
Simona Milanovic • Время на чтение: 4 минуты -
 Новости продуктов
В прошлом году мы открыли Android Studio для любых моделей ИИ. Сегодня мы делаем следующий шаг и добавляем поддержку агентов для написания кода.
Matthew Warner • Время на чтение: 3 минуты -
 Новости продуктов
Сегодня мы выпускаем первый набор задач с длительным горизонтом (LHT) – очень сложных задач, на выполнение которых у инженера уходит несколько дней или даже неделя. Мы также представляем агентную оценку, начиная с агентов от соответствующих поставщиков моделей.
Matthew McCullough • Время на чтение: 3 минуты
Получайте свежие новости о разработке приложений для Android на свою электронную почту каждую неделю.