Wir bei Google möchten die leistungsstärksten KI-Modelle direkt auf die Android-Geräte in Ihrer Tasche bringen. Heute freuen wir uns, die Veröffentlichung unseres neuesten hochmodernen offenen Modells bekannt zu geben: Gemma 4.
Diese Modelle sind die Grundlage für die nächste Generation von Gemini Nano. Code, den Sie heute für Gemma 4 schreiben, funktioniert also automatisch auf Geräten mit Gemini Nano 4, die im Laufe des Jahres verfügbar sein werden. Mit Gemini Nano 4 profitieren Sie von unseren zusätzlichen Leistungsoptimierungen, sodass Sie im gesamten Android-Ökosystem mit der effizientesten On-Device-Inferenz in die Produktion gehen können.
Über die AICore-Entwicklervorschau kannst du schon heute Vorabzugriff auf dieses Modell erhalten.
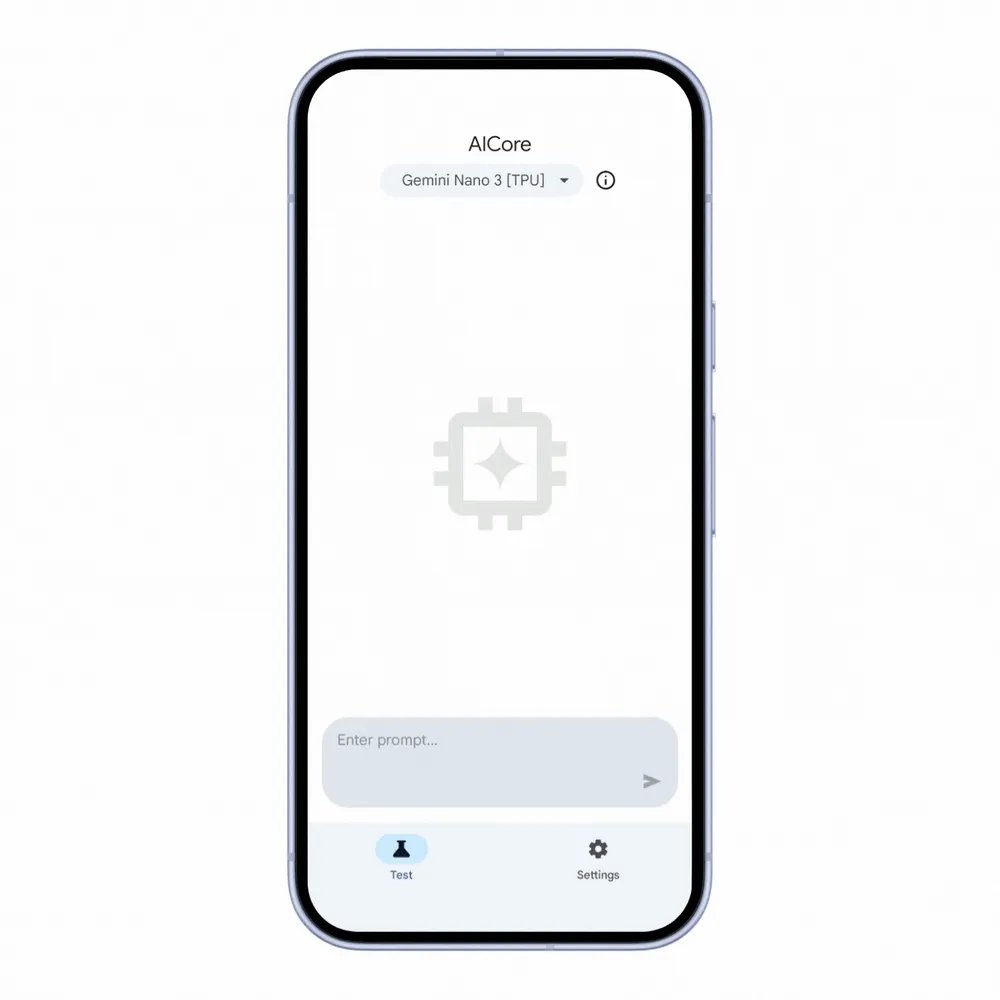
Wählen Sie in der Benutzeroberfläche der Entwicklervorschau das Modell Gemini Nano 4 Fast aus, um die extrem schnelle Inferenzgeschwindigkeit in Aktion zu sehen, bevor Sie Code schreiben.
Da Gemma 4 nativ über 140 Sprachen unterstützt, können Sie Ihrem globalen Publikum verbesserte lokalisierte, mehrsprachige Inhalte bieten. Darüber hinaus bietet Gemma 4 branchenführende Leistung mit multimodalem Verständnis, sodass Ihre Apps Text, Bilder und Audio verstehen und verarbeiten können. Damit Sie die beste Balance zwischen Leistung und Effizienz erhalten, ist Gemma 4 für Android in zwei Größen verfügbar:
- E4B: Für höhere Reasoning-Leistung und komplexe Aufgaben konzipiert.
- E2B: Optimiert für maximale Geschwindigkeit (3-mal schneller als das E4B-Modell!) und geringere Latenz.
Das neue Modell ist bis zu viermal schneller als frühere Versionen und verbraucht bis zu 60% weniger Akku. Ab heute können Sie mit verbesserten Funktionen experimentieren, darunter:
- Logisches Denken: Chain-of-Thought-Befehle und bedingte Anweisungen liefern jetzt voraussichtlich hochwertigere Ergebnisse. Beispiel: „Prüfe, ob der folgende Kommentar für einen Diskussionsthread den Community-Richtlinien entspricht. Der Kommentar verstößt gegen die Community-Richtlinien, wenn er einen oder mehrere dieser reason_for_flag enthält: Obszönitäten, abfällige Sprache, Hassrede. Wenn die Rezension die Community-Richtlinien erfüllt, geben Sie {true} zurück. Andernfalls wird {false, reason_for_flag} zurückgegeben.
- Mathematik:Dank verbesserter mathematischer Fähigkeiten kann das Modell Fragen jetzt genauer beantworten. Beispiel: „Wenn ich 26 Gehaltsschecks pro Jahr erhalte, wie viel sollte ich dann von jedem Gehaltsscheck sparen,um im Laufe eines Jahres mein Sparziel von 10.000 € zu erreichen?“
- Zeitverständnis:Das Modell kann jetzt besser mit Zeitangaben umgehen und ist daher genauer bei Anwendungsfällen, die Kalender, Erinnerungen und Wecker betreffen. Beispiel: „Die Veranstaltung findet am 18. August um 18:00 Uhr statt und 10 Stunden vor der Veranstaltung soll eine Erinnerung gesendet werden. Gib die Uhrzeit und das Datum zurück, zu denen die Erinnerung gesendet werden soll.“
- Bildverständnis: Anwendungsfälle, die OCR (optische Zeichenerkennung) beinhalten, wie das Verständnis von Diagrammen, die visuelle Datenextraktion und die Handschrifterkennung, liefern jetzt genauere Ergebnisse.
Nehmen Sie noch heute an der Entwicklervorschau teil, um diese Modelle in der Vorabversion herunterzuladen und sofort mit der Entwicklung von Funktionen der nächsten Generation zu beginnen.
Modell testen
Sie können das Modell ohne Code ausprobieren, indem Sie der Anleitung für die Entwicklervorschau folgen. Wenn Sie diese Modelle direkt in Ihren bestehenden Workflow einbinden möchten, ist das ganz einfach. In Android Studio können Sie Ihren Prompt verfeinern und mit der vertrauten ML Kit Prompt API entwickeln. Wir haben eine neue Funktion eingeführt, mit der Sie ein Modell angeben können, um die E2B- (schnell) oder E4B-Varianten (vollständig) für Tests anzusprechen.
// Define the configuration with a specific track and preference
val previewFullConfig = generationConfig {
    modelConfig = ModelConfig {
        releaseTrack = ModelReleaseTrack.PREVIEW
        preference = ModelPreference.FULL
    }
}

// Initialize the GenerativeModel with the configuration
val previewModel = GenerativeModel.getClient(previewFullConfig)

// Verify that the specific preview model is available
val previewModelStatus = previewModel.checkStatus()
if (previewModelStatus == FeatureStatus.AVAILABLE) {
    // Proceed with inference
    val response = previewModel.generateContent("If I get 26 paychecks per year, how much I should contribute each paycheck to reach my savings goal of $10k over the course of a year? Return only the amount.")

} else {
    // Handle the case where the preview model is not available
    // (e.g., print out log statements)
}
Was Sie während der Entwicklervorschau erwartet
Diese Entwicklervorschau soll Ihnen einen Vorsprung bei der Optimierung der Prompt-Genauigkeit und der Erkundung neuer Anwendungsfälle für Ihre spezifischen Apps verschaffen.
Während der Vorschauphase werden wir mehrere Updates veröffentlichen, darunter Unterstützung für Toolaufrufe, strukturierte Ausgabe, System-Prompts und den Denkmodus in der Prompt API. So können Sie die neuen Funktionen in Gemma 4 leichter nutzen und von erheblichen Leistungsoptimierungen profitieren.
Die Vorschaumodelle sind zum Testen auf AICore-fähigen Geräten verfügbar. Diese Modelle werden auf der neuesten Generation von speziellen KI-Beschleunigern von Google, MediaTek und Qualcomm Technologies ausgeführt. Auf anderen Geräten werden die Modelle anfangs auf einer CPU-Implementierung ausgeführt, die nicht repräsentativ für die endgültige Produktionsleistung ist. Wenn Ihr Gerät nicht AICore-fähig ist, können Sie diese Modelle auch über die App AI Edge Gallery testen. In Zukunft werden weitere Geräte unterstützt.
Einstieg
Sind Sie bereit, zu erfahren, was Gemma 4 für Ihre Nutzer tun kann?
- Aktivieren:Melde dich für die AICore-Entwicklervorschau an.
- Herunterladen:Nach der Aktivierung können Sie die neuesten Gemma 4-Modelle direkt auf Ihr unterstütztes Testgerät herunterladen.
- Entwickeln: Aktualisieren Sie Ihre ML Kit-Implementierung, um die neuen Modelle zu verwenden, und beginnen Sie mit der Entwicklung in Android Studio.
-
 Produktneuigkeiten
Um Sie bei der Umsetzung Ihrer ML Kit Prompt API-Anwendungsfälle in der Produktion zu unterstützen, kündigen wir die automatische Prompt-Optimierung (APO) für On-Device-Modelle in Vertex AI an. Die automatische Prompt-Optimierung ist ein Tool, mit dem Sie automatisch den optimalen Prompt für Ihre Anwendungsfälle finden können.
Chetan Tekur, Chao Zhao, Paul Zhou, Caren Chang • Lesezeit: 3 Minuten -
 Produktneuigkeiten
Mit KI ist es einfacher, personalisierte App-Inhalte zu erstellen, die für Nutzer in das richtige Format gebracht werden. Bisher konnten Entwickler Gemini Nano über ML Kit GenAI APIs einbinden, die auf bestimmte Anwendungsfälle wie Zusammenfassungen und Bildbeschreibungen zugeschnitten sind.
Caren Chang, Chengji Yan, Penny Li • Lesezeit: 2 Minuten -
 Produktneuigkeiten
Apps, die auf die kommende Android-Version ausgerichtet sind, können mit der Berechtigung WRITE_CONTACTS nicht mehr direkt in Kontakte schreiben.
Roxanna Aliabadi Walker • Lesezeit: 6 Minuten
Lassen Sie sich Woche für Woche die neuesten Informationen zur Android-Entwicklung zusenden.