Ulepszanie programowania na Androida wspomaganego przez AI i modeli LLM za pomocą Android Bench
Czas czytania: 2 min
Chcemy, aby tworzenie wysokiej jakości aplikacji na Androida było szybsze i łatwiejsze. Jednym ze sposobów na zwiększenie produktywności jest udostępnienie Ci AI. Wiemy, że zależy Ci na AI, która naprawdę rozumie niuanse platformy Android. Dlatego sprawdzamy, jak duże modele językowe radzą sobie z zadaniami związanymi z programowaniem na Androida. Dziś udostępniliśmy pierwszą wersję Android Bench, naszej oficjalnej tabeli wyników modeli LLM do tworzenia aplikacji na Androida.
Chcemy zapewnić twórcom modeli punkt odniesienia do oceny możliwości LLM w zakresie programowania aplikacji na Androida. Ustalając jasne i wiarygodne podstawy tego, jak wygląda wysokiej jakości programowanie aplikacji na Androida, pomagamy twórcom modeli identyfikować luki i przyspieszać wprowadzanie ulepszeń. Dzięki temu deweloperzy mogą wydajniej pracować z szerszą gamą przydatnych modeli, które zapewniają pomoc opartą na AI. W efekcie w ekosystemie Androida powstają aplikacje o wyższej jakości.
Zaprojektowane z myślą o rzeczywistych zadaniach związanych z programowaniem na Androida
Porównanie zostało utworzone na podstawie zestawu zadań obejmujących różne typowe obszary tworzenia aplikacji na Androida. Składa się z prawdziwych wyzwań o różnym stopniu trudności, pochodzących z publicznych repozytoriów Androida na GitHubie. Obejmują one m.in. rozwiązywanie problemów ze zmianami powodującymi niezgodność w różnych wersjach Androida, wykonywanie zadań związanych z określonymi obszarami, takich jak obsługa sieci na urządzeniach do noszenia, oraz migrację do najnowszej wersji Jetpack Compose.
W ramach każdej oceny model LLM próbuje rozwiązać problem zgłoszony w zadaniu, a my weryfikujemy to za pomocą testów jednostkowych lub testów instrumentacyjnych. To podejście niezależne od modelu pozwala nam mierzyć jego zdolność do poruszania się po złożonych bazach kodu, rozumienia zależności i rozwiązywania problemów, z którymi stykasz się na co dzień.
Zatwierdziliśmy tę metodologię u kilku twórców LLM, w tym w firmie JetBrains.
„Pomiar wpływu AI na Androida to ogromne wyzwanie, dlatego cieszę się, że powstała tak solidna i realistyczna platforma. Chociaż sami aktywnie przeprowadzamy testy porównawcze, Android Bench jest wyjątkowym i mile widzianym dodatkiem. Ta metodologia to dokładnie ten rodzaj rygorystycznej oceny, jakiej potrzebują obecnie deweloperzy Androida”.
– Kirill Smelov, szef integracji AI w JetBrains
Pierwsze wyniki Android Bench
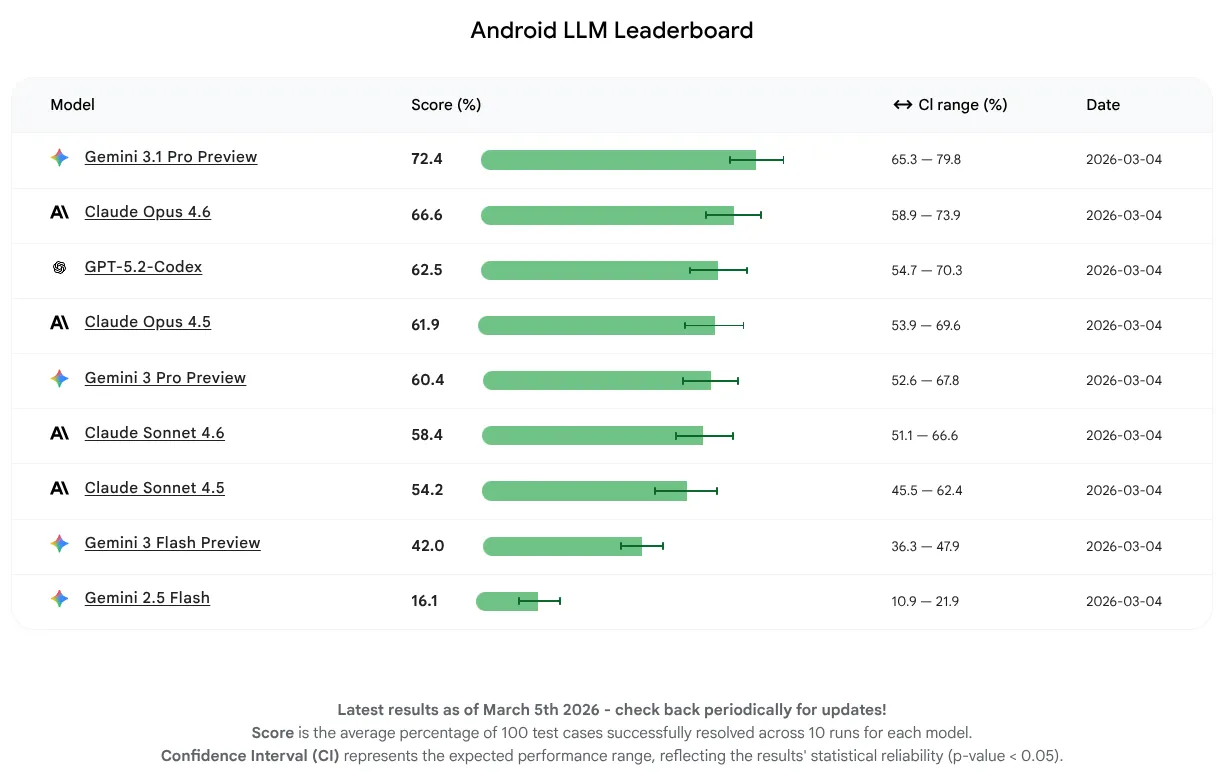
W tej pierwszej wersji chcieliśmy po prostu zmierzyć wydajność modelu, a nie skupiać się na korzystaniu z agentów ani narzędzi. Modele były w stanie wykonać 16–72% zadań. To szeroki zakres, który pokazuje, że niektóre duże modele językowe mają już solidne podstawy wiedzy o Androidzie, a inne mają większe możliwości rozwoju. Niezależnie od tego, na jakim etapie rozwoju są obecnie modele, spodziewamy się dalszego postępu, ponieważ zachęcamy twórców LLM do ulepszania swoich modeli pod kątem tworzenia aplikacji na Androida.
W przypadku tej pierwszej wersji LLM-em z najwyższym średnim wynikiem jest Gemini 3.1 Pro, a za nim plasuje się Claude Opus 4.6. Możesz wypróbować wszystkie modele, które oceniliśmy pod kątem pomocy AI w projektach na Androida, używając kluczy interfejsu API w najnowszej stabilnej wersji Androida Studio.
Zapewnianie przejrzystości deweloperom i twórcom LLM
Cenimy otwarte i przejrzyste podejście, dlatego udostępniliśmy naszą metodologię, zbiór danych i platformę testową publicznie w GitHubie.
Jednym z wyzwań związanych z dowolnym publicznym testem porównawczym jest ryzyko zanieczyszczenia danych, czyli sytuacja, w której modele mogły mieć kontakt z zadaniami ewaluacyjnymi podczas procesu trenowania. Podjęliśmy działania, aby nasze wyniki odzwierciedlały prawdziwe rozumowanie, a nie zapamiętywanie lub zgadywanie. Obejmują one dokładną ręczną weryfikację trajektorii agenta lub integrację ciągu kanarkowego, aby zniechęcić do trenowania.
W przyszłości będziemy nadal rozwijać naszą metodologię, aby zachować integralność zbioru danych, a także wprowadzać ulepszenia w kolejnych wersjach testu porównawczego, np. zwiększać liczbę i złożoność zadań.
Z niecierpliwością czekamy na to, jak Android Bench może długoterminowo ulepszyć pomoc AI. Naszą wizją jest zmniejszenie różnicy między koncepcją a kodem wysokiej jakości. Tworzymy fundamenty przyszłości, w której wszystko, co sobie wyobrazisz, będzie można stworzyć na Androidzie.
-
 Wiadomości o usługach
Dziś udostępniamy pierwszy zestaw zadań długoterminowych (LHT), czyli bardzo złożonych zadań, których wykonanie zajmuje inżynierowi kilka dni, a nawet tydzień. Wprowadzamy też ocenę agentów, zaczynając od agentów od odpowiednich dostawców modeli.
Matthew McCullough • Czas czytania: 3 minuty -
 Wiadomości o usługach
Dziś udostępniamy Androida 17 na większości obsługiwanych urządzeń Pixel. W najbliższych miesiącach pojawią się nowe urządzenia z Androidem 17.
Matthew McCullough • Czas czytania: 13 min -
 Wiadomości o usługach
Na konferencji Google I/O 26 przedstawiliśmy 17 najważniejszych ogłoszeń dla deweloperów Androida, które dotyczą produktywności opartej na agentach, standardu interfejsu użytkownika Compose First oraz wydajnych multimediów i adaptacyjnego rozwoju w rozszerzającym się ekosystemie.
Matthew McCullough • Czas czytania: 8 minut
Otrzymuj co tydzień najnowsze informacje o tworzeniu aplikacji na Androida na swoją skrzynkę odbiorczą.