Android के लिए एलएलएम को मेज़र करने के तरीके में बदलाव: Android Bench का अगला वर्शन
पढ़ने में 3 मिनट लगेंगे
हमने मार्च में, Android Bench लॉन्च किया था. यह असल दुनिया के Android डेवलपमेंट टास्क के लिए, एलएलएम लीडरबोर्ड है. हमारा मकसद, Android पर ऐप्लिकेशन बनाने के लिए मॉडल की क्षमताओं के बारे में पारदर्शिता बनाए रखना है. साथ ही, मॉडल को बेहतर बनाने के लिए बढ़ावा देना है, ताकि आपको रोज़मर्रा के काम के लिए एआई के ज़्यादा मददगार विकल्प मिल सकें. तब से, हमने आपके सुझाव, शिकायत या राय के आधार पर बेंचमार्क को बेहतर बनाया है. इसमें ओपन-वेट मॉडल का आकलन करना और लीडरबोर्ड में लागत और परफ़ॉर्मेंस डाइमेंशन जोड़ना शामिल है.
हालांकि, एआई की क्षमताएं लगातार बेहतर हो रही हैं. इसलिए, मेज़रमेंट के तरीकों को भी इसके हिसाब से अपडेट करना ज़रूरी है. जुलाई में रिलीज़ किए गए अपडेट के तहत, हमने Harbor फ़्रेमवर्क को अपनाया है. इसमें मॉडल का आकलन करने के लिए इस्तेमाल किए जाने वाले बेंचमार्किंग एजेंट का अपडेट किया गया वर्शन शामिल है.
हमारा आकलन करने का तरीका बदल गया है. इसके साथ ही, जुलाई में रिलीज़ होने वाले इस अपडेट में हम लीडरबोर्ड में आठ नए मॉडल (Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus, और Qwen 3.7 Max) जोड़ रहे हैं. हम Android डेवलपर कम्यूनिटी के लिए, बेंचमार्क में योगदान देने के मौके भी शेयर कर रहे हैं.
Harbor फ़्रेमवर्क की मदद से, अनुमान लगाने के तरीके को अपग्रेड करना
Android Bench को डिज़ाइन करते समय, हमने अपनी कार्यप्रणाली को उस समय उपलब्ध इंडस्ट्री के मुख्य मानकों के आधार पर तैयार किया था. हमने मिनी-एसडब्ल्यूई-एजेंट v1 का इस्तेमाल किया. यह एक सामान्य बेंचमार्किंग एजेंट है. हमने इसे Android डेवलपमेंट की बारीकियों के हिसाब से बनाया है, ताकि Android डेवलपमेंट के सामान्य कामों के लिए मॉडल की क्षमताओं का बुनियादी मेज़रमेंट किया जा सके.
हम आपको Android डेवलपमेंट के लिए, सबसे आधुनिक आकलन उपलब्ध कराते रहेंगे. इससे आपको यह पता चलेगा कि नए मॉडल की क्षमताओं को सटीक तरीके से मेज़र किया जा सकता है. इसके लिए, हम अपने बेंचमार्क को Harbor फ़्रेमवर्क के हिसाब से स्टैंडर्ड बना रहे हैं. Harbor, ऐसे स्टैंडर्ड और इंटिग्रेशन तय करता है जिनकी मदद से कोई भी व्यक्ति आसानी से बेंचमार्क चला सकता है, अपने पसंदीदा सेटअप का आकलन कर सकता है या नतीजे शेयर कर सकता है. इससे आपको ज़्यादा पारदर्शिता और विज़िबिलिटी मिलती है.
इस अपग्रेड की मदद से, हम मॉडल और उनकी क्षमताओं का बेहतर तरीके से आकलन कर सकते हैं. साथ ही, हमने सभी मॉडल पर बेंचमार्क को फिर से चलाया है, ताकि अपडेट किया गया बेसलाइन तैयार किया जा सके. इसका मतलब है कि स्कोर में थोड़ा बदलाव हुआ है. हालांकि, हमारी वेबसाइट पर संग्रह में जाकर, अब भी पुराने स्कोर देखे जा सकते हैं.
हम यह पक्का करना चाहते हैं कि Android Bench आपके लिए मददगार हो. इसलिए, हम इसे लगातार अपडेट करते रहेंगे, क्योंकि हमारे मूल्यांकन और उद्योग परिपक्व हो रहे हैं.
लीडरबोर्ड में आठ नए मॉडल शामिल किए गए हैं
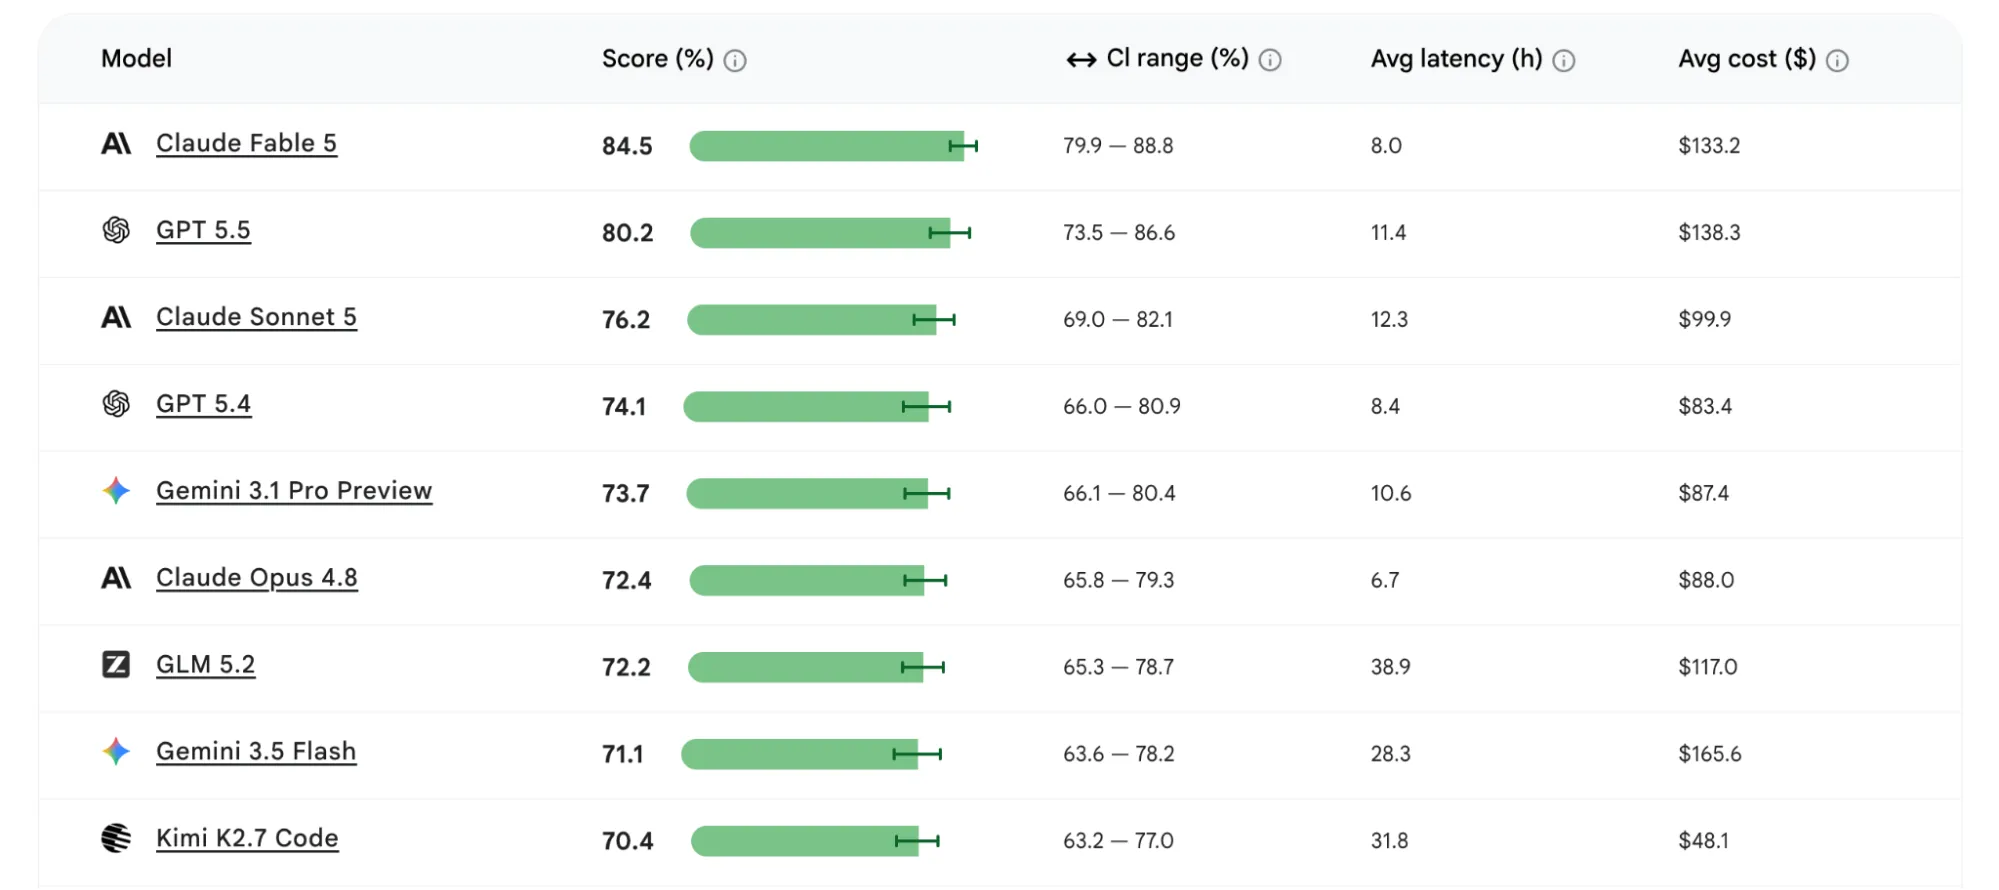
लीडरबोर्ड को अपडेट रखने के लिए, हमने Android Bench के लीडरबोर्ड में Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus, और Qwen 3.7 Max को शामिल किया है.
आपको दिखेगा कि Claude Fable 5, 84.5 के स्कोर के साथ लीडरबोर्ड में सबसे ऊपर है. इसके बाद, 80.2 के स्कोर के साथ GPT 5.5 दूसरे नंबर पर है. वहीं, 76.2 के स्कोर के साथ Claude Sonnet 5 तीसरे नंबर पर है.
सिर्फ़ ओपन-वेट मॉडल की तुलना करने पर, GLM 5.2 सबसे ऊपर है. इसका स्कोर 72.2 है. इसके बाद, Kimi K2.7 Code का स्कोर 70.4 है.
अपडेट किए गए लीडरबोर्ड पर, मॉडल की परफ़ॉर्मेंस और असरदार होने से जुड़ी मेट्रिक देखी जा सकती हैं. इससे यह पता चलता है कि नए और पुराने मॉडल, Android से जुड़ी चुनौतियों को कैसे हल करते हैं. जैसे, Jetpack Compose माइग्रेशन, पहनने लायक डिवाइसों की नेटवर्किंग, और प्लैटफ़ॉर्म एपीआई अपडेट.
Android Bench को कम्यूनिटी के योगदान के लिए उपलब्ध कराना
हम शुरू से ही, ओपन और पारदर्शी तरीके को अहमियत देते हैं. इसलिए, हमने अपनी ओरिजनल कार्यप्रणाली और टेस्ट हार्नेस को GitHub पर सार्वजनिक तौर पर उपलब्ध कराया है. आपने हमारे डेटासेट के बारे में सुझाव/राय देने या शिकायत करने का तरीका पूछा था. इसलिए, अब हम सहयोग को एक कदम आगे बढ़ा रहे हैं. हम Android डेवलपर कम्यूनिटी को Android Bench को बेहतर बनाने का मौका दे रहे हैं.
आज से, Android Bench में दो तरीकों से योगदान दिया जा सकता है:
- अपनी पसंद के मुताबिक Android डेवलपमेंट टास्क डिज़ाइन करें और उन्हें सबमिट करें. इससे आपको यह आकलन करने में मदद मिलेगी कि मॉडल, आपके लिए ज़रूरी स्थितियों को कैसे हैंडल करते हैं.
- बेंचमार्क के आधार पर आकलन करें और उन्हें शेयर करें. इसके लिए, हमारे डेटासेट या अपने कस्टम टास्क के हिसाब से, अपने पसंदीदा मॉडल की टेस्टिंग करें.
हम सबमिट किए गए टास्क की समीक्षा करेंगे. साथ ही, यह आकलन करेंगे कि उन्हें बेंचमार्क में जोड़ा जाए या नहीं. हम एक ऐसा बेंचमार्क बनाना चाहते हैं जो दुनिया भर की Android डेवलपर कम्यूनिटी की अलग-अलग और रोज़मर्रा की ज़रूरतों को पूरा करे.
आगे की जानकारी
एजेंटिक डेवलपमेंट के लिए ज़्यादा से ज़्यादा विकल्प उपलब्ध होने की वजह से, एआई की मदद से काम करने के लिए, सबसे नए स्टैंडर्ड को बनाए रखना ज़रूरी है. इससे यह पक्का किया जा सकता है कि एआई की मदद से काम करने की सुविधा, ज़्यादा स्मार्ट, मददगार, और असरदार बनी रहे. टास्क देखने के लिए, हमारी GitHub रिपॉज़िटरी पर जाएं. हम आपको अपनी टीम को समीक्षा के लिए कोई टास्क सबमिट करने का न्योता देते हैं. साथ ही, डेटासेट एक्सप्लोर करने या आकलन सबमिट करने के लिए, Harbor Hub पर जाएं.
हमेशा की तरह, हमारी वेबसाइट पर अपडेट किया गया लीडरबोर्ड देखा जा सकता है. इसके अलावा, मेथडोलॉजी के बारे में भी पढ़ा जा सकता है.
-
 प्रॉडक्ट से जुड़ी खबरें
पिछले साल, Android Studio को किसी भी एआई मॉडल के लिए उपलब्ध कराया गया था. आज हम एक और कदम आगे बढ़ाते हुए, आपकी पसंद के कोडिंग एजेंट के लिए सहायता उपलब्ध करा रहे हैं.
Matthew Warner • 3 मिनट में पढ़ा जा सकता है -
 प्रॉडक्ट से जुड़ी खबरें
आज हम लॉन्ग-हॉरिज़न टास्क (एलएचटी) का पहला सेट रिलीज़ कर रहे हैं. ये ऐसे मुश्किल टास्क होते हैं जिन्हें पूरा करने में इंजीनियर को कई दिन या एक हफ़्ता भी लग सकता है. हम एजेंटिक इवैल्यूएशन भी पेश कर रहे हैं. इसकी शुरुआत, मॉडल उपलब्ध कराने वाली कंपनियों के एजेंट से की जाएगी.
Matthew McCullough • 3 मिनट में पढ़ा जा सकता है -
 प्रॉडक्ट से जुड़ी खबरें
हम Google Play पर अपने सदस्यता प्लैटफ़ॉर्म का लगातार विस्तार कर रहे हैं, ताकि आपको अपने कारोबार को आगे बढ़ाने, नए कारोबारी मॉडल अपनाने, और अपने उपयोगकर्ताओं की ज़रूरतों को पूरा करने में मदद मिल सके.
Sheenam Mittal • 4 मिनट में पढ़ें
Android डेवलपमेंट से जुड़ी नई अहम जानकारी, हर हफ़्ते अपने इनबॉक्स में पाएं.