18% तेज़ी से कंपाइल होता है, परफ़ॉर्मेंस में कोई समझौता नहीं
8 मिनट में पढ़ा जा सकता है
Android Runtime (ART) टीम ने कंपाइल होने में लगने वाले समय को 18% तक कम कर दिया है. हालांकि, इससे कंपाइल किए गए कोड या मेमोरी के इस्तेमाल में कोई कमी नहीं आई है. यह सुधार, 2025 में शुरू की गई हमारी उस पहल का हिस्सा था जिसमें कंपाइल होने में लगने वाले समय को कम करने के साथ-साथ, मेमोरी के इस्तेमाल या कंपाइल किए गए कोड की क्वालिटी को बेहतर बनाने का लक्ष्य रखा गया था.
ART के लिए, कंपाइल होने में लगने वाले समय को ऑप्टिमाइज़ करना ज़रूरी है. उदाहरण के लिए, जस्ट-इन-टाइम (जेआईटी) कंपाइलिंग के दौरान, यह सीधे तौर पर ऐप्लिकेशन की परफ़ॉर्मेंस और डिवाइस की कुल परफ़ॉर्मेंस पर असर डालता है. तेज़ी से कंपाइल करने पर, ऑप्टिमाइज़ेशन शुरू होने में कम समय लगता है. इससे, उपयोगकर्ता को बेहतर और ज़्यादा रिस्पॉन्सिव अनुभव मिलता है. इसके अलावा, JIT और AOT, दोनों के लिए कंपाइल होने में लगने वाले समय को कम करने से, कंपाइलेशन प्रोसेस के दौरान संसाधनों का इस्तेमाल कम होता है. इससे बैटरी लाइफ़ और डिवाइस के तापमान को फ़ायदा मिलता है. खास तौर पर, कम सुविधाओं वाले डिवाइसों पर.
कंपाइल करने में लगने वाले समय को कम करने से जुड़े कुछ सुधार, Android के जून 2025 वाले वर्शन में लॉन्च किए गए थे. बाकी सुधार, Android के साल के आखिर में रिलीज़ होने वाले वर्शन में उपलब्ध होंगे. इसके अलावा, Android 12 और इसके बाद के वर्शन का इस्तेमाल करने वाले सभी लोग, मेनलाइन अपडेट के ज़रिए इन सुधारों को पा सकते हैं.
ऑप्टिमाइज़ करने वाले कंपाइलर को ऑप्टिमाइज़ करना
कंपाइलर को ऑप्टिमाइज़ करना हमेशा एक मुश्किल काम होता है. आपको स्पीड मुफ़्त में नहीं मिलेगी. इसके लिए, आपको कुछ त्याग करना होगा. हमने अपने लिए एक बहुत ही मुश्किल लक्ष्य तय किया है: कंपाइलर को तेज़ बनाना है, लेकिन ऐसा मेमोरी रिग्रेशन को शामिल किए बिना करना है. साथ ही, सबसे अहम बात यह है कि कंपाइलर को जनरेट किए गए कोड की क्वालिटी को कम किए बिना तेज़ बनाना है. अगर कंपाइलर तेज़ है, लेकिन ऐप्लिकेशन धीरे चलते हैं, तो हम फ़ेल हो गए हैं.
हमारा एक ही मकसद था कि हम डेवलपमेंट में लगने वाले समय को कम करें. इसके लिए, हमने गहराई से रिसर्च की, जांच की, और ऐसे स्मार्ट समाधान खोजे जो इन ज़रूरी शर्तों को पूरा करते हों. आइए, इस बारे में ज़्यादा जानें कि हम किन चीज़ों को बेहतर बनाने के लिए काम करते हैं. साथ ही, अलग-अलग समस्याओं के सही समाधान कैसे ढूंढते हैं.
काम के संभावित ऑप्टिमाइज़ेशन ढूंढना
किसी मेट्रिक को ऑप्टिमाइज़ करने से पहले, आपको उसे मेज़र करना होगा. ऐसा न करने पर, आपको कभी पता नहीं चलेगा कि आपने इसमें सुधार किया है या नहीं. हमारे लिए अच्छी बात यह है कि कंपाइल टाइम की स्पीड में ज़्यादा बदलाव नहीं होता. हालांकि, इसके लिए आपको कुछ सावधानियां बरतनी होंगी. जैसे, बदलाव से पहले और बाद में मेज़रमेंट के लिए एक ही डिवाइस का इस्तेमाल करना. साथ ही, यह पक्का करना कि आपका डिवाइस ज़्यादा गर्म न हो. इसके अलावा, हमारे पास कंपाइलर के आंकड़ों जैसे डिटरमिनिस्टिक मेज़रमेंट भी हैं. इनसे हमें यह समझने में मदद मिलती है कि बैकग्राउंड में क्या हो रहा है.
इन सुधारों के लिए, हमें डेवलपमेंट में लगने वाले समय को कम करना पड़ा. इसलिए, हम चाहते थे कि हम जितनी जल्दी हो सके, उतनी जल्दी बदलाव कर सकें. इसका मतलब है कि हमने कुछ ऐप्लिकेशन (पहले पक्ष के ऐप्लिकेशन, तीसरे पक्ष के ऐप्लिकेशन, और Android ऑपरेटिंग सिस्टम का मिक्स) को चुना, ताकि हम समाधानों का प्रोटोटाइप बना सकें. बाद में, हमने मैन्युअल और अपने-आप होने वाली टेस्टिंग की मदद से यह पुष्टि की कि फ़ाइनल तौर पर लागू किया गया बदलाव सही है.
चुने गए APK के उस सेट की मदद से, हम मैन्युअल तरीके से स्थानीय तौर पर कंपाइल करने की प्रोसेस शुरू करेंगे. इसके बाद, कंपाइलेशन की प्रोफ़ाइल पाएंगे. साथ ही, pprof का इस्तेमाल करके यह देखेंगे कि हम अपना समय कहां खर्च कर रहे हैं.
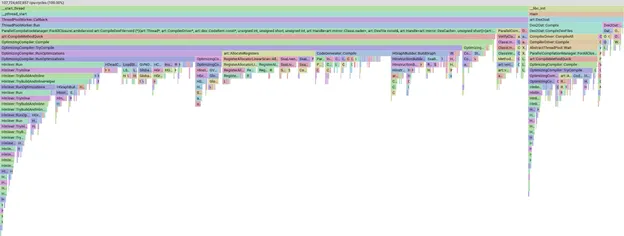
pprof में प्रोफ़ाइल के फ़्लेम ग्राफ़ का उदाहरण
pprof टूल बहुत काम का है. इसकी मदद से, हम डेटा को स्लाइस, फ़िल्टर, और क्रम से लगा सकते हैं. उदाहरण के लिए, यह देखा जा सकता है कि कंपाइलर के किन फ़ेज़ या तरीकों में ज़्यादा समय लग रहा है. हम pprof के बारे में ज़्यादा जानकारी नहीं देंगे. बस यह जान लें कि अगर बार बड़ा है, तो इसका मतलब है कि कंपाइल होने में ज़्यादा समय लगा.
इनमें से एक व्यू “बॉटम अप” होता है. इसमें यह देखा जा सकता है कि कौनसे तरीके में सबसे ज़्यादा समय लग रहा है. नीचे दी गई इमेज में, हमें Kill नाम का एक तरीका दिख रहा है. इसमें कंपाइल होने में एक प्रतिशत से ज़्यादा समय लगता है. इस ब्लॉग पोस्ट में, बाद में कुछ अन्य तरीकों के बारे में भी बताया जाएगा.
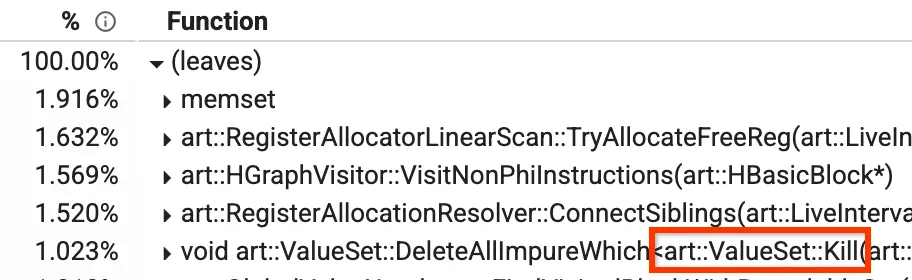
प्रोफ़ाइल का बॉटम अप व्यू
हमारे ऑप्टिमाइज़िंग कंपाइलर में, ग्लोबल वैल्यू नंबरिंग (जीवीएन) नाम का एक फ़ेज़ होता है. आपको इस बात की चिंता करने की ज़रूरत नहीं है कि यह फ़ंक्शन क्या करता है. हालांकि, यह जानना ज़रूरी है कि इसमें `Kill` नाम का एक तरीका है. इसके तहत, यह फ़िल्टर के हिसाब से कुछ नोड मिटा देगा. इसमें समय लगता है, क्योंकि इसे सभी नोड को दोहराना होता है और एक-एक करके उनकी जांच करनी होती है. हमें पता चला है कि कुछ मामलों में, हमें पहले से ही पता होता है कि जांच के नतीजे गलत होंगे. भले ही, उस समय हमारे पास कितने भी नोड मौजूद हों. ऐसे मामलों में, हम इटरेशन को पूरी तरह से स्किप कर सकते हैं. इससे, जीवीएन के रनटाइम में ~15% की बढ़ोतरी होती है और यह 1.023% से घटकर ~0.3% हो जाता है.
काम के ऑप्टिमाइज़ेशन लागू करना
हमने यह बताया कि समय को कैसे मेज़र किया जाता है और यह कैसे पता लगाया जाता है कि समय कहां खर्च हो रहा है. हालांकि, यह सिर्फ़ शुरुआत है. अगला चरण, कंपाइल करने में लगने वाले समय को ऑप्टिमाइज़ करने का तरीका है.
आम तौर पर, ऊपर दिए गए `Kill` जैसे मामले में, हम यह देखते हैं कि नोड को कैसे दोहराया जाता है. साथ ही, हम इसे तेज़ी से करने के लिए, उदाहरण के तौर पर, चीज़ों को पैरलल में करते हैं या एल्गोरिदम में सुधार करते हैं. दरअसल, हमने शुरुआत में यही तरीका आज़माया था. जब हमें कोई और तरीका नहीं मिला, तब हमें लगा कि “एक मिनट रुको…” और हमने देखा कि कुछ मामलों में, समस्या को ठीक करने के लिए किसी भी तरीके का इस्तेमाल नहीं करना था! इस तरह के ऑप्टिमाइज़ेशन करते समय, यह मुमकिन है कि आप छोटी-छोटी बातों पर ध्यान दें और बड़ी तस्वीर को नज़रअंदाज़ कर दें.
अन्य मामलों में, हमने कुछ अलग-अलग तकनीकों का इस्तेमाल किया. जैसे:
- ह्यूरिस्टिक्स का इस्तेमाल करके यह तय करना कि क्या ऑप्टिमाइज़ेशन से काम के नतीजे नहीं मिलेंगे. इसलिए, इसे स्किप किया जा सकता है
- कंप्यूट किए गए डेटा को कैश मेमोरी में सेव करने के लिए, अतिरिक्त डेटा स्ट्रक्चर का इस्तेमाल करना
- स्पीड बढ़ाने के लिए, मौजूदा डेटा स्ट्रक्चर में बदलाव करना
- कुछ मामलों में साइकल से बचने के लिए, नतीजों की गणना धीरे-धीरे करना
- सही ऐब्स्ट्रैक्शन का इस्तेमाल करें - गै़रज़रूरी सुविधाओं से कोड की स्पीड कम हो सकती है
- बार-बार इस्तेमाल किए जाने वाले पॉइंटर को कई लोड के ज़रिए ऐक्सेस करने से बचें
हमें कैसे पता चलेगा कि ऑप्टिमाइज़ेशन करना फ़ायदेमंद है या नहीं?
सबसे अच्छी बात यह है कि आपको ऐसा करने की ज़रूरत नहीं है. जब आपको पता चलता है कि किसी कोड को कंपाइल करने में बहुत ज़्यादा समय लग रहा है और उसे बेहतर बनाने के लिए डेवलपमेंट में समय देने के बाद भी, आपको कोई समाधान नहीं मिलता. ऐसा हो सकता है कि कुछ भी न किया जा सके, इसे लागू करने में बहुत समय लगे, इससे कोई दूसरी मेट्रिक काफ़ी हद तक कम हो जाए, कोड बेस की जटिलता बढ़ जाए वगैरह. इस ब्लॉग पोस्ट में आपको हर सफल ऑप्टिमाइज़ेशन के बारे में बताया गया है. हालांकि, ऐसे कई ऑप्टिमाइज़ेशन हैं जो सफल नहीं हुए.
अगर आपकी स्थिति भी ऐसी ही है, तो कम से कम काम करके मेट्रिक को बेहतर बनाने का अनुमान लगाएं. इसका मतलब है कि:
- पहले से इकट्ठा की गई मेट्रिक के आधार पर अनुमान लगाना या सिर्फ़ अंदाज़ा लगाना
- तेज़ी से तैयार किए गए प्रोटोटाइप की मदद से अनुमान लगाना
- कोई समाधान लागू करें.
अपने समाधान की कमियों का अनुमान लगाना न भूलें. उदाहरण के लिए, अगर आपको अतिरिक्त डेटा स्ट्रक्चर पर भरोसा करना है, तो आपको कितनी मेमोरी का इस्तेमाल करना है?
ज़्यादा जानकारी
देर न करते हुए, आइए हम उन बदलावों के बारे में जानते हैं जिन्हें हमने लागू किया है.
हमने FindReferenceInfoOf नाम के तरीके को ऑप्टिमाइज़ करने के लिए बदलाव किया है. इस तरीके में, किसी एंट्री को ढूंढने के लिए वेक्टर की लीनियर सर्च की जाती थी. हमने उस डेटा स्ट्रक्चर को अपडेट किया है, ताकि उसे निर्देश के आईडी के हिसाब से इंडेक्स किया जा सके. इससे FindReferenceInfoOf, O(n) के बजाय O(1) हो जाएगा. साथ ही, हमने वेक्टर को पहले से ही असाइन कर दिया है, ताकि उसका साइज़ न बदले. हमने मेमोरी को थोड़ा बढ़ा दिया है, क्योंकि हमें एक अतिरिक्त फ़ील्ड जोड़ना था. इससे यह पता चलता है कि हमने वेक्टर में कितनी एंट्री डाली हैं. हालांकि, मेमोरी में मामूली बढ़ोतरी हुई है, इसलिए यह बदलाव ज़्यादा असर नहीं डालेगा. इससे LoadStoreAnalysis फ़ेज़ में 34 से 66% तक की तेज़ी आई. इससे कंपाइल होने में लगने वाले समय में ~0.5 से 1.8% तक की कमी आई.
हमारे पास HashSet का कस्टम वर्शन है, जिसका इस्तेमाल हम कई जगहों पर करते हैं. इस डेटा स्ट्रक्चर को बनाने में काफ़ी समय लग रहा था. हमें इसकी वजह पता चल गई है. कई साल पहले, इस डेटा स्ट्रक्चर का इस्तेमाल सिर्फ़ कुछ जगहों पर किया जाता था. ये ऐसी जगहें थीं जहां बहुत बड़े HashSets का इस्तेमाल किया जाता था. इसलिए, इसे उन जगहों के लिए ऑप्टिमाइज़ किया गया था. हालांकि, आजकल इसका इस्तेमाल कम समय के लिए किया जाता है. साथ ही, इसमें कुछ ही एंट्री होती हैं. इसका मतलब है कि हमने इस बड़े HashSet को बनाकर साइकल बर्बाद कर दीं, लेकिन हमने इसका इस्तेमाल सिर्फ़ कुछ एंट्री के लिए किया और फिर इसे हटा दिया. इस बदलाव की वजह से, कंपाइल होने में लगने वाले समय में ~1.3 से 2% की कमी आई है. इसके अलावा, मेमोरी का इस्तेमाल भी ~0.5-1% तक कम हो गया, क्योंकि अब हम पहले की तरह बड़े डेटा स्ट्रक्चर का इस्तेमाल नहीं कर रहे थे.
हमने कंपाइल होने में लगने वाले समय को ~0.5-1% तक कम किया है. इसके लिए, हमने लैंबडा को डेटा स्ट्रक्चर को रेफ़रंस के तौर पर पास किया है, ताकि उन्हें कॉपी करने से बचा जा सके. यह एक ऐसी समस्या थी जो मूल समीक्षा में नहीं मिली थी और सालों तक हमारे कोडबेस में बनी रही. pprof में मौजूद प्रोफ़ाइलों को देखने के बाद, हमें पता चला कि ये तरीके कई डेटा स्ट्रक्चर बना रहे हैं और उन्हें मिटा रहे हैं. इसके बाद, हमने इनकी जांच की और इन्हें ऑप्टिमाइज़ किया.
हमने कंपाइल किए गए आउटपुट को लिखने वाले फ़ेज़ की स्पीड बढ़ा दी है. इसके लिए, हमने कैलकुलेट की गई वैल्यू को कैश मेमोरी में सेव किया है. इससे कंपाइल करने में लगने वाले कुल समय में ~1.3 से 2.8% की कमी आई है. हालांकि, ज़्यादा बुककीपिंग की वजह से हमें काफ़ी परेशानी हुई. साथ ही, ऑटोमेटेड टेस्टिंग से हमें मेमोरी रिग्रेशन के बारे में सूचना मिली. बाद में, हमने उसी कोड की दोबारा जांच की और नया वर्शन लागू किया. इससे न सिर्फ़ मेमोरी रिग्रेशन की समस्या ठीक हुई, बल्कि कंपाइल टाइम में भी ~0.5-1.8% की बढ़ोतरी हुई! दूसरे बदलाव में, हमें इस फ़ेज़ के काम करने के तरीके को फिर से तैयार करना पड़ा, ताकि दो डेटा स्ट्रक्चर में से एक को हटाया जा सके.
हमारे ऑप्टिमाइज़िंग कंपाइलर में एक फ़ेज़ होता है. इसमें बेहतर परफ़ॉर्मेंस पाने के लिए, फ़ंक्शन कॉल को इनलाइन किया जाता है. हम यह तय करने के लिए कि किन तरीकों को इनलाइन करना है, कंप्यूटेशन करने से पहले और काम पूरा करने के बाद, दोनों बार अनुमानित तरीकों का इस्तेमाल करते हैं. हालांकि, इनलाइन करने की प्रोसेस को फ़ाइनल करने से ठीक पहले, हम आखिरी बार जांच करते हैं. अगर इनमें से किसी भी तरीके से यह पता चलता है कि इनलाइन करने से कोई फ़ायदा नहीं होगा (उदाहरण के लिए, बहुत सारे नए निर्देश जोड़े जाएंगे), तो हम तरीके को इनलाइन नहीं करते हैं.
हमने “फ़ाइनल चेक” कैटगरी से दो चेक को “ह्यूरिस्टिक” कैटगरी में ट्रांसफ़र कर दिया है. इससे हमें यह अनुमान लगाने में मदद मिलती है कि इनलाइनिंग सफल होगी या नहीं. ऐसा हम समय लेने वाली किसी भी गणना को करने से पहले करते हैं. यह अनुमानित डेटा है, इसलिए यह पूरी तरह से सटीक नहीं है. हालांकि, हमने पुष्टि की है कि हमारे नए ह्यूरिस्टिक, परफ़ॉर्मेंस पर असर डाले बिना, पहले इनलाइन किए गए 99.9% डेटा को कवर करते हैं. इनमें से एक नई ह्यूरिस्टिक, ज़रूरी DEX रजिस्टर के बारे में थी. इससे परफ़ॉर्मेंस में ~0.2 से 1.3% का सुधार हुआ. दूसरी ह्यूरिस्टिक, निर्देशों की संख्या के बारे में थी. इससे परफ़ॉर्मेंस में ~2% का सुधार हुआ.
हमारे पास BitVector का कस्टम वर्शन है, जिसका इस्तेमाल हम कई जगहों पर करते हैं. हमने कुछ तय साइज़ वाले बिट वेक्टर के लिए, BitVectorView को BitVector क्लास से बदल दिया है. BitVectorView का साइज़ बदला जा सकता है. इससे कुछ इनडायरेक्शन और रन-टाइम रेंज की जांच खत्म हो जाती है. साथ ही, बिट वेक्टर ऑब्जेक्ट बनाने की प्रोसेस तेज़ हो जाती है.
इसके अलावा, BitVectorView क्लास को अंडरलाइंग स्टोरेज टाइप पर टेंप्लेट किया गया था. ऐसा इसलिए किया गया, ताकि पुराने BitVector की तरह हमेशा uint32_t का इस्तेमाल न किया जाए. इससे कुछ कार्रवाइयां की जा सकती हैं. जैसे, Union() फ़ंक्शन का इस्तेमाल करके 64-बिट प्लैटफ़ॉर्म पर एक साथ दो गुना बिट प्रोसेस की जा सकती हैं. Android OS को कंपाइल करते समय, असर डालने वाले फ़ंक्शन के सैंपल में कुल मिलाकर 1% से ज़्यादा की कमी आई. यह बदलाव कई बार किया गया है [1, 2, 3, 4, 5, 6]
अगर हम सभी ऑप्टिमाइज़ेशन के बारे में विस्तार से बात करें, तो हमें पूरा दिन लग जाएगा! अगर आपको कुछ और ऑप्टिमाइज़ेशन के बारे में जानना है, तो हमने कुछ और बदलाव भी किए हैं. इनके बारे में यहां जानें:
- कंपाइलेशन में लगने वाले समय को ~0.6-1.6% तक कम करने के लिए, Add bookkeeping जोड़ें.
- अगर हो सके, तो साइकल से बचने के लिए डेटा को धीरे-धीरे प्रोसेस करें.
- हमारे कोड को रीफ़ैक्टर करें, ताकि जब प्रीकंप्यूटिंग का इस्तेमाल न किया जाए, तो उसे स्किप किया जा सके.
- जब ऐलोकेटर को अन्य जगहों से आसानी से हासिल किया जा सकता है, तब कुछ डिपेंडेंट लोड चेन से बचें.
- ज़रूरत से ज़्यादा काम से बचने के लिए, जांच जोड़ने का एक और उदाहरण.
- रजिस्टर ऐलोकेटर में, रजिस्टर टाइप (कोर/एफ़पी) पर बार-बार ब्रांचिंग करने से बचें.
- पक्का करें कि कंपाइल करने के समय कुछ ऐरे शुरू किए गए हों. इसके लिए, clang पर भरोसा न करें.
- कुछ लूप हटाएं. रेंज लूप का इस्तेमाल करें, ताकि क्लैंग उन्हें बेहतर तरीके से ऑप्टिमाइज़ कर सके. ऐसा इसलिए, क्योंकि लूप के साइड इफ़ेक्ट की वजह से, इसे कंटेनर के इंटरनल पॉइंटर को फिर से लोड करने की ज़रूरत नहीं होती. हर इनपुट के लिए, इनलाइन किए गए `InputAt(.)` के ज़रिए लूप में वर्चुअल फ़ंक्शन `HInstruction::GetInputRecords()` को कॉल करने से बचें.
- Accept() फ़ंक्शन से बचें, ताकि कंपाइलर ऑप्टिमाइज़ेशन का इस्तेमाल करके विज़िटर पैटर्न का पता लगाया जा सके.
नतीजा
हम एआरटी की कंपाइल-टाइम स्पीड को बेहतर बनाने के लिए लगातार काम कर रहे हैं. इससे हमें काफ़ी फ़ायदा मिला है. अब Android ज़्यादा आसानी से और बेहतर तरीके से काम करता है. साथ ही, इससे बैटरी लाइफ़ और डिवाइस के तापमान को बेहतर बनाने में भी मदद मिलती है. हमने ऑप्टिमाइज़ेशन की पहचान करके उन्हें लागू किया है. इससे हमने यह दिखाया है कि मेमोरी के इस्तेमाल या कोड की क्वालिटी से समझौता किए बिना, कंपाइल होने में लगने वाले समय को काफ़ी कम किया जा सकता है.
इस प्रोसेस में, हमने pprof जैसे टूल का इस्तेमाल करके प्रोफ़ाइलिंग की. साथ ही, हमने बार-बार कोशिश की और कभी-कभी कम फ़ायदेमंद तरीकों को छोड़ भी दिया. एआरटी टीम के सामूहिक प्रयासों से, कंपाइल होने में लगने वाले समय में काफ़ी कमी आई है. साथ ही, इससे आने वाले समय में होने वाले सुधारों के लिए भी आधार तैयार हुआ है.
ये सभी सुधार, साल 2025 के आखिर में Android के अपडेट में उपलब्ध होंगे. साथ ही, Android 12 और इसके बाद के वर्शन के लिए, ये मेनलाइन अपडेट के ज़रिए उपलब्ध होंगे. हमें उम्मीद है कि ऑप्टिमाइज़ेशन की हमारी प्रोसेस के बारे में इस गहराई से दी गई जानकारी से, आपको कंपाइलर इंजीनियरिंग की जटिलताओं और फ़ायदों के बारे में अहम जानकारी मिली होगी!
-
 प्रॉडक्ट से जुड़ी खबरें
हम Google Play पर अपने सदस्यता प्लैटफ़ॉर्म का लगातार विस्तार कर रहे हैं, ताकि आपको अपने कारोबार को आगे बढ़ाने, नए कारोबारी मॉडल अपनाने, और अपने उपयोगकर्ताओं की ज़रूरतों को पूरा करने में मदद मिल सके.
Sheenam Mittal • 4 मिनट में पढ़ें -
 प्रॉडक्ट से जुड़ी खबरें
पिछले साल, Android Studio को किसी भी एआई मॉडल के लिए उपलब्ध कराया गया था. आज हम एक और कदम आगे बढ़ाते हुए, आपकी पसंद के कोडिंग एजेंट के लिए सहायता उपलब्ध करा रहे हैं.
Matthew Warner • 3 मिनट में पढ़ा जा सकता है -
 प्रॉडक्ट से जुड़ी खबरें
Googlebook, Android पर आधारित लैपटॉप की नई कैटगरी पेश करता है. HP, Dell, Lenovo, Acer, और Asus जैसे पार्टनर के बेहतरीन हार्डवेयर में, मोबाइल की सुविधा के साथ-साथ डेस्कटॉप की पावर भी मिलती है.
Fahd Imtiaz, Loryn Hairston • 4 मिनट में पढ़ें
Android डेवलपमेंट से जुड़ी नई अहम जानकारी, हर हफ़्ते अपने इनबॉक्स में पाएं.