Cómo la optimización automatizada de instrucciones abre las ganancias de calidad para la API de Prompt de IA generativa de ML Kit
Lectura de 3 min
Optimización automatizada de instrucciones (APO)
Para ayudarte a llevar a producción tus casos de uso de la API de Prompt de ML Kit, nos complace anunciar la optimización automatizada de instrucciones (APO) orientada a modelos integrados en el dispositivo en Vertex AI. La optimización automatizada de instrucciones es una herramienta que te ayuda a encontrar automáticamente la instrucción óptima para tus casos de uso.
La era de la IA integrada en el dispositivo ya no es una promesa, sino una realidad en producción. Con el lanzamiento de Gemini Nano v3, ponemos en manos de los usuarios capacidades multimodales y de comprensión del lenguaje sin precedentes. A través de la familia de modelos de Gemini Nano, tenemos una amplia cobertura de dispositivos compatibles en todo el ecosistema Android. Sin embargo, para los desarrolladores que crean la próxima generación de apps inteligentes, el acceso a un modelo potente es solo el primer paso. El verdadero desafío radica en la personalización: ¿Cómo adaptas un modelo de base para que tenga un rendimiento de nivel experto en tu caso de uso específico sin romper las restricciones del hardware móvil?
En el mundo del servidor, los LLM más grandes tienden a ser muy capaces y requieren menos adaptación de dominio. Incluso cuando es necesario, las opciones más avanzadas, como el ajuste fino de LoRA (adaptación de bajo rango), pueden ser opciones viables. Sin embargo, la arquitectura única de Android AICore prioriza un modelo de sistema compartido y con uso eficiente de la memoria. Esto significa que implementar adaptadores de LoRA personalizados para cada app individual presenta desafíos en estos servicios del sistema compartidos.
Sin embargo, hay un camino alternativo que puede ser igual de impactante. Aprovechando la optimización automatizada de instrucciones (APO) en Vertex AI, los desarrolladores pueden lograr una calidad cercana al ajuste, todo mientras trabajan sin problemas dentro del entorno de ejecución nativo de Android. Al enfocarse en instrucciones del sistema superiores, la APO permite que los desarrolladores adapten el comportamiento del modelo con mayor solidez y escalabilidad que las soluciones de ajuste tradicionales.
Nota: Gemini Nano V3 es una versión con calidad optimizada del aclamado modelo Gemma 3N. Cualquier optimización de instrucciones que se realice en el modelo de código abierto Gemma 3N también se aplicará a Gemini Nano V3. En los dispositivos compatibles, las APIs de IA generativa de ML Kit aprovechan el modelo nano-v3 para maximizar la calidad para los desarrolladores de Android.
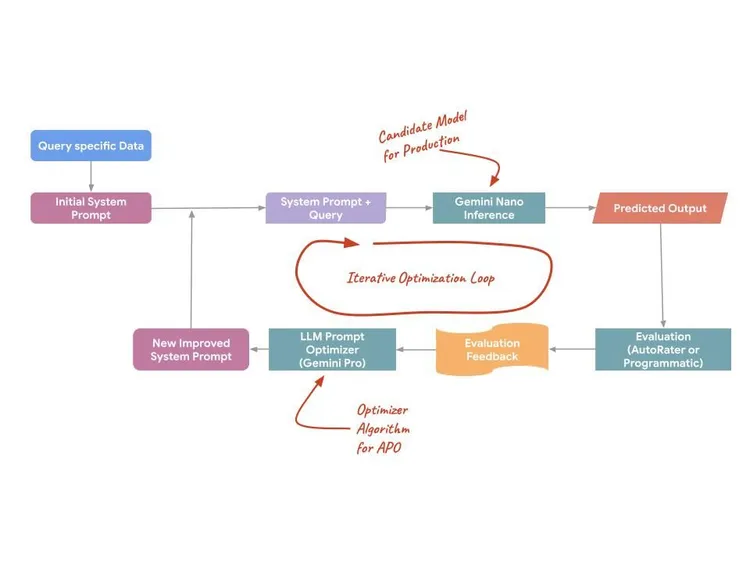
La APO no trata la instrucción como un texto estático, sino como una superficie programable que se puede optimizar. Aprovecha los modelos del servidor (como Gemini Pro y Flash) para proponer instrucciones, evaluar variaciones y encontrar la óptima para tu tarea específica. Este proceso emplea tres mecanismos técnicos específicos para maximizar el rendimiento:
- Análisis de errores automatizado: La APO analiza los patrones de error de los datos de entrenamiento para identificar automáticamente las debilidades específicas de la instrucción inicial.
- Destilación de instrucciones semánticas: Analiza ejemplos de entrenamiento masivos para destilar la "intención verdadera" de una tarea, lo que crea instrucciones que reflejan con mayor precisión la distribución de datos real.
- Pruebas paralelas de candidatos: En lugar de probar una idea a la vez, la APO genera y prueba numerosos candidatos de instrucciones en paralelo para identificar el máximo global de calidad.
Por qué la APO puede acercarse a la calidad del ajuste fino
Existe la idea errónea de que el ajuste siempre produce una mejor calidad que las instrucciones. En el caso de los modelos de base modernos, como Gemini Nano v3, la ingeniería de instrucciones puede ser eficaz por sí sola:
- Preservación de las capacidades generales: El ajuste ( PEFT/LoRA) fuerza los pesos de un modelo para que se indexen en exceso en una distribución específica de datos. Esto suele provocar un "olvido catastrófico", en el que el modelo mejora en tu sintaxis específica, pero empeora en la lógica y la seguridad generales. La APO no modifica los pesos, lo que preserva las capacidades del modelo base.
- Seguimiento de instrucciones y descubrimiento de estrategias: Gemini Nano v3 se entrenó de forma rigurosa para seguir instrucciones complejas del sistema. La APO aprovecha esto encontrando la estructura de instrucciones exacta que desbloquea las capacidades latentes del modelo, lo que a menudo permite descubrir estrategias que podrían ser difíciles de encontrar para los ingenieros humanos.
Para validar este enfoque, evaluamos la APO en diversas cargas de trabajo de producción. Nuestra validación demostró mejoras constantes del 5% al 8% en la exactitud en varios casos de uso.En varias funciones integradas en el dispositivo, la APO proporcionó mejoras significativas en la calidad.
| Caso de uso | Tipo de tarea | Descripción de la tarea | Métrica | Mejora de la APO |
| Clasificación de temas | Clasificación de texto | Clasificar un artículo de noticia en temas como finanzas, deportes, etcétera | Exactitud | +5% |
| Clasificación de intenciones | Clasificación de texto | Clasifica una consulta de atención al cliente en intents | Exactitud | +8.0% |
| Traducción de páginas web | Traducción de texto | Traducir una página web del inglés a un idioma local | BLEU | +8.57% |
Un flujo de trabajo de desarrollador continuo y de extremo a extremo
Existe la idea errónea de que el ajuste siempre produce una mejor calidad que las instrucciones. En el caso de los modelos de base modernos, como Gemini Nano v3, la ingeniería de instrucciones puede ser eficaz por sí sola:
- Preservación de las capacidades generales: El ajuste ( PEFT/LoRA) fuerza los pesos de un modelo para que se indexen en exceso en una distribución específica de datos. Esto suele provocar un "olvido catastrófico", en el que el modelo mejora en tu sintaxis específica, pero empeora en la lógica y la seguridad generales. La APO no modifica los pesos, lo que preserva las capacidades del modelo base.
- Seguimiento de instrucciones y descubrimiento de estrategias: Gemini Nano v3 se entrenó de forma rigurosa para seguir instrucciones complejas del sistema. La APO aprovecha esto encontrando la estructura de instrucciones exacta que desbloquea las capacidades latentes del modelo, lo que a menudo permite descubrir estrategias que podrían ser difíciles de encontrar para los ingenieros humanos.
Para validar este enfoque, evaluamos la APO en diversas cargas de trabajo de producción. Nuestra validación demostró mejoras constantes del 5% al 8% en la exactitud en varios casos de uso.En varias funciones integradas en el dispositivo, la APO proporcionó mejoras significativas en la calidad.
Conclusión
El lanzamiento de la optimización automatizada de instrucciones (APO) marca un punto de inflexión para la IA generativa integrada en el dispositivo. Al cerrar la brecha entre los modelos de base y el rendimiento de nivel experto, les brindamos a los desarrolladores las herramientas para crear aplicaciones para dispositivos móviles más sólidas. Ya sea que recién estés comenzando con la optimización sin ejemplos o que estés escalando a la producción con un perfeccionamiento basado en datos, el camino hacia una inteligencia integrada en el dispositivo de alta calidad ahora es más claro. Lanza hoy mismo tus casos de uso integrados en el dispositivo a producción con la API de Prompt de ML Kit y la optimización automatizada de instrucciones de Vertex AI.
Vínculos pertinentes:
-
 Novedades de productos
En Google, nos comprometemos a llevar los modelos de IA más potentes directamente a los dispositivos Android que llevas en el bolsillo. Hoy nos complace anunciar el lanzamiento de nuestro modelo abierto de última generación más reciente: Gemma 4.
Caren Chang, David Chou • Lectura de 3 min -
 Novedades de productos
La IA facilita la creación de experiencias personalizadas en las apps que transforman el contenido en el formato adecuado para los usuarios. Anteriormente, permitimos que los desarrolladores se integraran con Gemini Nano a través de las APIs de IA generativa de ML Kit adaptadas para casos de uso específicos, como el resumen y la descripción de imágenes.
Caren Chang, Chengji Yan, Penny Li • Lectura de 2 min -
 Novedades de productos
Las apps que se orienten a la próxima versión de Android ya no podrán escribir directamente en los contactos con el permiso WRITE_CONTACTS.
Roxanna Aliabadi Walker • Lectura de 6 min
Recibe la información más reciente sobre el desarrollo de Android en tu bandeja de entrada todas las semanas.