Wie R8 Kotlin-Koroutinen unter Android doppelt so schnell gemacht hat
Lesezeit: 7 Minuten
Ab AGP 9.2.0 optimiert R8 die meisten Atomic*FieldUpdater-Aufrufe in Unsafe-Varianten, die bei gängigen Vorgängen 2- bis 4-mal schneller sind. Dies hat besonders große Auswirkungen auf die Bibliothek „kotlinx.atomicfu“, die Atomics für kotlinx.coroutines implementiert. Dadurch werden das Starten und Abbrechen von Coroutinen um bis zu 2-mal schneller. Damit Sie die Vorteile nutzen können, müssen Sie AGP auf Version 9.2.0 oder höher aktualisieren.
Da die meisten Android-Apps Kotlin als primäre Sprache verwenden, ist kotlinx.coroutines zum De-facto-Standard für die asynchrone Programmierung geworden. Die Bibliothek bietet eine gut konzipierte und strukturierte Möglichkeit, gleichzeitige Flows zu verwalten, die nativ in Kotlin ist. Jetpack Compose ist da keine Ausnahme. Hier werden Coroutinen verwendet, um Zeigerereignisse, Animationen und andere Interaktionen zu verwalten. Zum Zeitpunkt der Erstellung dieses Dokuments rufen die meisten gleichzeitigen APIs in Compose im Hintergrund suspend-Funktionen auf und starten und/oder beenden Coroutinen, um Aktualisierungen zu verarbeiten.
Als das Compose-Team begann, die Leistung zu untersuchen, stellten sie fest, dass Coroutinen für viele Vorgänge, die außerhalb der Komposition stattfinden, einen Engpass darstellen. Beispielsweise wurden 80% der Zeit, die für das Erstellen und Aktualisieren von Modifier.clickable aufgewendet wurde, für das Starten und Abbrechen interner Coroutinen verwendet, die InteractionSource-Aktualisierungen verarbeitet haben. Auf Grundlage dieser Beobachtungen konzentrierte sich ein Großteil der frühen Leistungsoptimierung darauf, Coroutinen aus dem Standardpfad zu entfernen und die Initialisierung bis zum erforderlichen Zeitpunkt zu verzögern.
Die Kosten einer Coroutine
Am einfachsten lässt sich das interne Verhalten einer Funktion unter Android analysieren, indem Sie einen ART-Methoden-Trace (Android Runtime) erfassen. Ein ART-Methoden-Trace ist ein Tool, mit dem der Ausführungsablauf einer App aufgezeichnet wird. Es zeigt genau, welche Methoden aufgerufen werden, in welcher Reihenfolge und wie viel Zeit für jede Methode aufgewendet wird. So können Entwickler Leistungsengpässe erkennen. Für einen leeren LaunchedEffect { }-Aufruf würde das so aussehen:
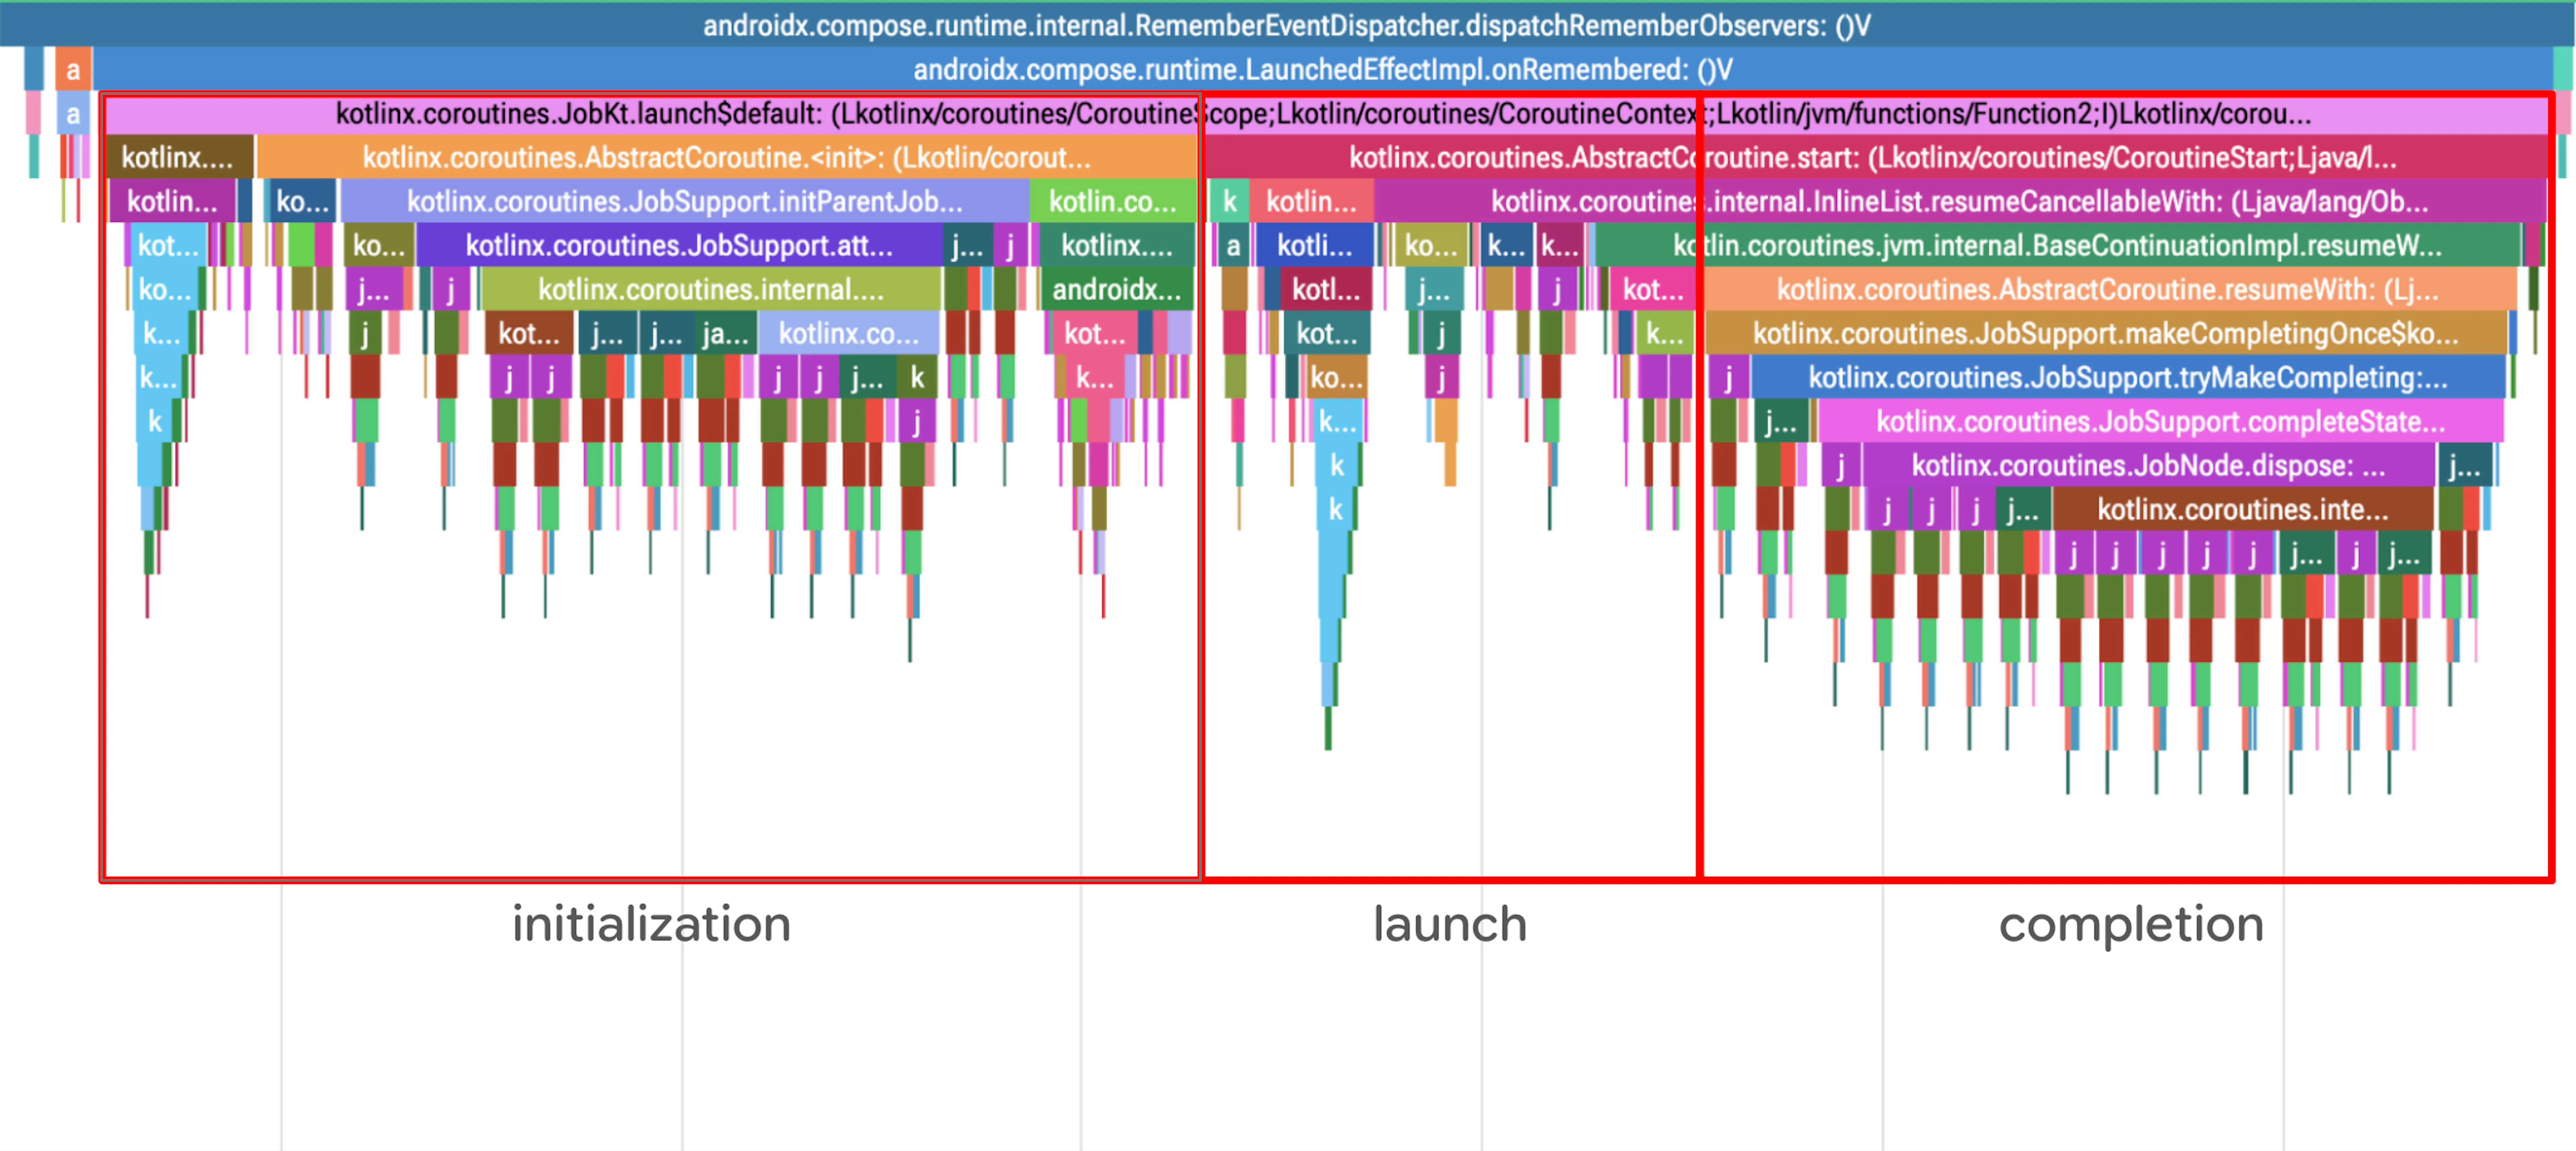
Der oben gezeigte Methodentrace kann in drei Teile unterteilt werden:
- Neue Coroutine wird initialisiert
- Coroutine wird gestartet
- Coroutine wird abgeschlossen (weil sie sofort beendet wird)
Das Abbrechen von LaunchedEffect ähnelt dem normalen Abschluss, es wird jedoch auch ein CancellationException erstellt.
Im obigen Profil fällt sofort auf, dass häufig java.util.concurrent.AtomicReferenceFieldUpdater aufgerufen wird (lila oder grüne Kästchen mit j…-Labels). Zwar ist jeder Aufruf relativ schnell, die Häufigkeit ist jedoch bedenklich. Jeder nicht unerhebliche Overhead, der auf mehrere Aufrufe verteilt wird, kann zu einer spürbaren Regression führen. Wenn Sie in einen Anruf hineinzoomen, sehen Sie, dass die meiste Zeit für Reflexionsprüfungen aufgewendet wird.
Coroutinen implementieren eine sperrenfreie Baumstruktur für über- und untergeordnete Beziehungen, die strukturierte Parallelität ermöglicht. Die kotlinx.atomicfu-Bibliothek implementiert sperrenfreie atomare Operationen mithilfe eines bekannten JVM-Primitivs, AtomicReferenceFieldUpdater. Der Updater verwendet eine Klassenreferenz und einen Feldnamen, um atomare Vorgänge zur Laufzeit auszuführen. Außerdem müssen mehrere reflektierende Sicherheitsprüfungen durchgeführt werden, um sicherzustellen, dass das Feld vorhanden und zugänglich ist. Bei jedem Vorgang in Coroutinen (Starten, Anhalten, Abbrechen, Abschließen) wird mindestens ein atomarer Vorgang aufgerufen. Wenn dieser langsam ist, ist die Leistung von Coroutinen schlecht.
AtomicReferenceFieldUpdater untersuchen
Aber eines nach dem anderen. AtomicReferenceFieldUpdater ist auf der JVM seit über 10 Jahren gut optimiert. Methodentraces erfassen möglicherweise Overhead, der durch eine Optimierung auf VM-Ebene vollständig entfernt wird: Just-in-time- (JIT) oder Ahead-of-time-Kompilierungen (AOT). Um die Leistung zu überprüfen, schreiben wir einige Benchmarks, um den Unterschied zwischen atomaren Referenzen aus kotlinx.atomicfu und java.util.concurrent.atomic zu messen.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
Wenn dieser Benchmark auf einem Pixel 5 ausgeführt wird (wobei sichergestellt wird, dass AtomicReferenceFieldUpdater#compareAndSet während des Warm-ups JIT-kompiliert wird), ergeben sich die folgenden Ergebnisse auf dem Pixel 5 (API 33):
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
Die Messungen bestätigen die Lücke.Die kotlinx.atomicfu-Version ist etwa 2, 7-mal langsamer. Das bestätigt, dass ART keine verborgene Optimierung durchführt und dass Prüfungen des reflektiven Zugriffs zur Laufzeit zusätzlichen Aufwand verursachen.
Wenn wir uns den ursprünglichen Methodentrace ansehen, ist die einzige sinnvolle Arbeit, die von AtomicReferenceFieldUpdater ausgeführt wird, der interne Aufruf von Unsafe.getObjectVolatile, der die zugrunde liegende atomare Operation ausführt. In den meisten Fällen ist die Updater-Initialisierung statisch und kann anhand der Struktur der umgebenden Klasse immer als korrekt nachgewiesen werden. Daher können die meisten AtomicReferenceFieldUpdater-Verwendungen statisch analysiert und während der Kompilierung durch eine interne Unsafe-Variante ersetzt werden. Die Android-Build-Toolchain hat einen eigenen optimierenden Compiler, der genau das kann.
Optimierung mit R8
Die Atomic*FieldUpdater -Klassen unterstützen eine subtile, dynamische und auf Reflexion basierende Verwendung, werden aber oft in statisch offensichtlichen Mustern verwendet. Das erklärt sowohl die langsame Baseline-Leistung als auch den Wunsch nach Optimierung. R8 ist ein Compiler zur Optimierung des gesamten Programms und eignet sich gut, um die einfacheren Muster zu erkennen und den Overhead der reflektierenden Sicherheitsprüfungen zu reduzieren. R8 empfängt JVM-Bytecode nach dem Java- oder Kotlin-Compiler. Zur besseren Lesbarkeit werden diese Beispiele jedoch in Java-Syntax dargestellt. Deshalb gibt es keine Typargumente für AtomicReferenceFieldUpdater.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
Im Basisbeispiel wird ein statischer Final-Updater erstellt, der mit einfachen konstanten Argumenten für den Inhaber, den Typ und den Namen des Felds auf ein flüchtiges Feld zugreift. Die verwendete Spiegelung ist vollkommen transparent. Es ist klar zu erkennen, dass dieser Updater auf ein gültiges Feld verweist und dass die Website, auf der der Updater erstellt wurde, gültigen Zugriff auf das Feld hat.
Im Wesentlichen ist Atomic*FieldUpdater ein Wrapper für einen Feld-Offset und Aufrufe von Unsafe. Im besten Fall wird das Updater-Feld durch ein Offset-Feld ersetzt und die Updater-Aufrufe durch Aufrufe von Unsafe.
Atomic*FieldUpdater optimieren
Die Optimierung erfolgt in drei Schritten: Instrumentierung, Ersetzung und Bereinigung.
Instrumentierung
Im ersten Schritt werden neben dem Updater-Feld auch Offset-Felder eingeführt, um den direkten Zugriff über den Unsafe -Aufruf zu ermöglichen.
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
Auf das Feld wird über die Reflektion zugegriffen und Unsafe wird verwendet, um den Feld-Offset in der Klasse zu extrahieren. Dieser Code stellt die Interna von Atomic*FieldUpdater dar, wenn Sie die Reflektionsvalidierung ignorieren. Stattdessen werden der Inhabertyp des Aktualisierers und der Feldtyp des flüchtigen Felds statisch im Compiler erfasst.
Das ursprüngliche Feld und seine Initialisierung bleiben unverändert. Im Optimierungsprozess werden Verwendungen optimistisch ermöglicht und optimiert und dann bereinigt. Dies ist ein einfacher Ansatz für die Implementierung, der aber auch eine teilweise Optimierung von Updater-Feldern ermöglicht, bei der einige Verwendungen unverändert bleiben, während andere optimiert werden.
Ersetzen
An diesem Punkt im Compiler, nach einem geeigneten Join-Point für die Nebenläufigkeit, haben wir eine Liste der instrumentierten Updater-Felder. Das bedeutet, dass wir jede Anruf-Website anhand einiger Bedingungen individuell optimieren können. Hier ein Beispiel für einen Aufruf:
updater.compareAndSet(holder, expectedValue, newValue);
Für Atomic*FieldUpdater gelten folgende Bedingungen:
- Stammt
updateraus einem instrumentierten Feld? Kann die statische Analyse den Wert des Objekts bis zu einem Feldlesevorgang eines instrumentierten Updater zurückverfolgen? - Ist
holderdieselbe Klasse oder eine Unterklasse des ursprünglich definierten Platzhaltertyps? - Ist
newValuedieselbe Klasse oder eine Unterklasse des ursprünglich definierten Feldtyps?
Wenn alle Bedingungen erfüllt sind, wird der Aufruf durch einen Aufruf von Unsafe ohne Reflexionsprüfungen ersetzt.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
Dieser neue Aufruf ist schneller und einfacher, unterscheidet sich aber vom ursprünglichen Aufruf in Bezug auf die Verarbeitung von Nullwerten in updater und holder. Sofern nicht statisch ausgeschlossen, werden für beide Nullprüfungen eingefügt.
Klären
An diesem Punkt enthält die Holding-Klasse das ursprüngliche Updater-Feld und das neue Offset-Feld sowie Aufrufstellen, die eines der beiden verwenden können. Wenn keine der Anrufstandorte optimiert wurde, sollte das Offset-Feld entfernt werden. Wenn alle Anrufstandorte optimiert wurden, sollte das Updater-Feld entfernt werden. In beiden Fällen sollte auch der Initialisierungsaufruf gelöscht werden. Das Löschen nicht verwendeter Felder und das Entfernen von Dead Code erfolgt bereits im Compiler. Das Entfernen des Initialisierungscodes erfordert jedoch einige zusätzliche Tricks.
Sowohl der Aufruf von newUpdater als auch von getDeclaredField kann Nebeneffekte haben, da Ausnahmen ausgelöst werden können. Außerdem ist die Implementierung unbekannt, da sie von der API-Version abhängt. Das bedeutet, dass sie durch generische Optimierung nicht sicher entfernt werden können. Für diese Bereinigung mussten die instrumentierten Felder explizit berücksichtigt werden, da statisch bekannt ist, dass sie keine Ausnahmen enthalten.
Das oben gezeigte einfache Updater-Beispiel sieht nach der Optimierung so aus:
Ergebnisse
Nach diesen Optimierungen entspricht die Leistung von kotlinx.atomicfu und den meisten expliziten Verwendungen von AtomicInt/Long/ReferenceFieldUpdater jetzt der Leistung von AtomicReference mit angewendetem R8. Tatsächlich ist es in einigen Benchmarks sogar schneller. kotlinx.atomicfu hat ein Compiler-Plug-in, mit dem atomic-Instanzen in Felder eingefügt werden können. Dadurch werden weniger Zuweisungen benötigt, um ein atomar aktualisiertes Feld zu erstellen.
Jetpack Compose hat am meisten von dieser Arbeit profitiert. Die Compose-Laufzeit hat eine Reihe von Microbenchmarks, die die Leistung von Coroutinen sehr genau verfolgen, um Leistungsbeeinträchtigungen frühzeitig zu erkennen. Als die Benchmarks auf eine neue Version von R8 aktualisiert wurden, stellten wir eine Verdopplung beim Starten und Abbrechen von Coroutinen in LaunchedEffect fest.
Außerdem implementiert das ART-Team diese Optimierungen nativ auf VM-Ebene. Wenn Ihre App auf API 36 ausgerichtet ist und auf einer aktuellen Android-Version ausgeführt wird, ist es möglich, dass Ihr Gerät Coroutinen bereits auf ähnliche Weise optimiert. Bei den oben genannten Coroutine-Benchmarks wurde nach JIT-Updates in den aktuellen Versionen von ART eine Leistungssteigerung von etwa 15% beobachtet.
Ihre App wird standardmäßig optimiert, wenn Sie ein Upgrade auf AGP 9.2.0 durchführen oder R8 9.2.0 direkt verwenden. Weitere Informationen finden Sie unter D8-Dexer und R8-Shrinker.
-
 Fallstudien
Das Team entwickelte eine KI-native UI-Codebasis, die 50% kleiner als die ursprüngliche Implementierung ist. Gleichzeitig konnte die Ausführungszeit des KI-Agenten um 35 %, die Anzahl der Engineer-Agent-Austausche um 32% und die Tokenkosten um 33% gesenkt werden.
Pavlo Stavytskyi, Rebecca Franks • Lesezeit: 11 Minuten -
 Fallstudien
WhatsApp ist die weltweit größte Messaging-Plattform mit Milliarden von Nutzern weltweit. Es ist das Standardkommunikationstool für Menschen in verschiedenen Regionen und verbindet Nutzer über private, zuverlässige und sichere Nachrichten.
Niharika Arora, Tracy Agyemang, Mayank Jain • Lesezeit: 8 Minuten -
 Fallstudien
Tinder möchte echte Kontakte ermöglichen und inspirieren, indem es für jede neue Generation von Singles einfach und unterhaltsam ist, neue Leute kennenzulernen.
Ajesh Pai, Ulises Uriel Verduzco Díaz , Tracy Agyemang • Lesezeit: 4 Minuten
Lassen Sie sich Woche für Woche die neuesten Informationen zur Android-Entwicklung zusenden.