In che modo R8 ha reso le coroutine Kotlin su Android due volte più veloci
Tempo di lettura: 7 min
A partire da AGP 9.2.0, R8 ottimizza la maggior parte delle chiamate Atomic*FieldUpdater in varianti non sicure che offrono prestazioni da 2 a 4 volte migliori nelle operazioni comuni. Ciò ha un impatto particolarmente significativo sulla libreria kotlinx.atomicfu che implementa gli atomici per kotlinx.coroutines, rendendo l'avvio e l'annullamento delle coroutine fino a due volte più veloci. Per usufruire dei vantaggi, aggiorna AGP alla versione 9.2.0 o successive.
Con la maggior parte delle app per Android che adottano Kotlin come lingua principale, kotlinx.coroutines è diventato uno standard di fatto per la programmazione asincrona. La libreria offre un modo ben progettato e strutturato per gestire i flussi simultanei nativi di Kotlin. Jetpack Compose non fa eccezione e adotta le coroutine per gestire eventi puntatore, animazioni e altre interazioni. Al momento della stesura, la maggior parte delle API simultanee in Compose chiama le funzioni suspend sotto il cofano e avvia e/o annulla le coroutine per gestire gli aggiornamenti.
Quando il team di Compose ha iniziato a esaminare le prestazioni, ha scoperto che le coroutine erano un collo di bottiglia per molte operazioni che avvengono al di fuori della composizione. Ad esempio, l'80% del tempo dedicato alla creazione e all'aggiornamento di Modifier.clickable è stato utilizzato per avviare e annullare le coroutine interne che gestivano gli aggiornamenti di InteractionSource. Sulla base di queste osservazioni, gran parte del lavoro iniziale sul rendimento si è concentrato sulla rimozione delle coroutine dal percorso predefinito e sul ritardo dell'inizializzazione fino a quando non è necessario.
Il costo di una coroutine
Il modo più semplice per analizzare il comportamento interno di una funzione su Android è acquisire una traccia del metodo Android Runtime (ART). Una traccia metodo ART è uno strumento che registra il flusso di esecuzione di un'app, mostrando esattamente quali metodi vengono chiamati, il loro ordine e quanto tempo viene trascorso in ciascuno, consentendo agli sviluppatori di identificare i colli di bottiglia delle prestazioni. Per una chiamata LaunchedEffect { } vuota, l'aspetto sarà simile al seguente:
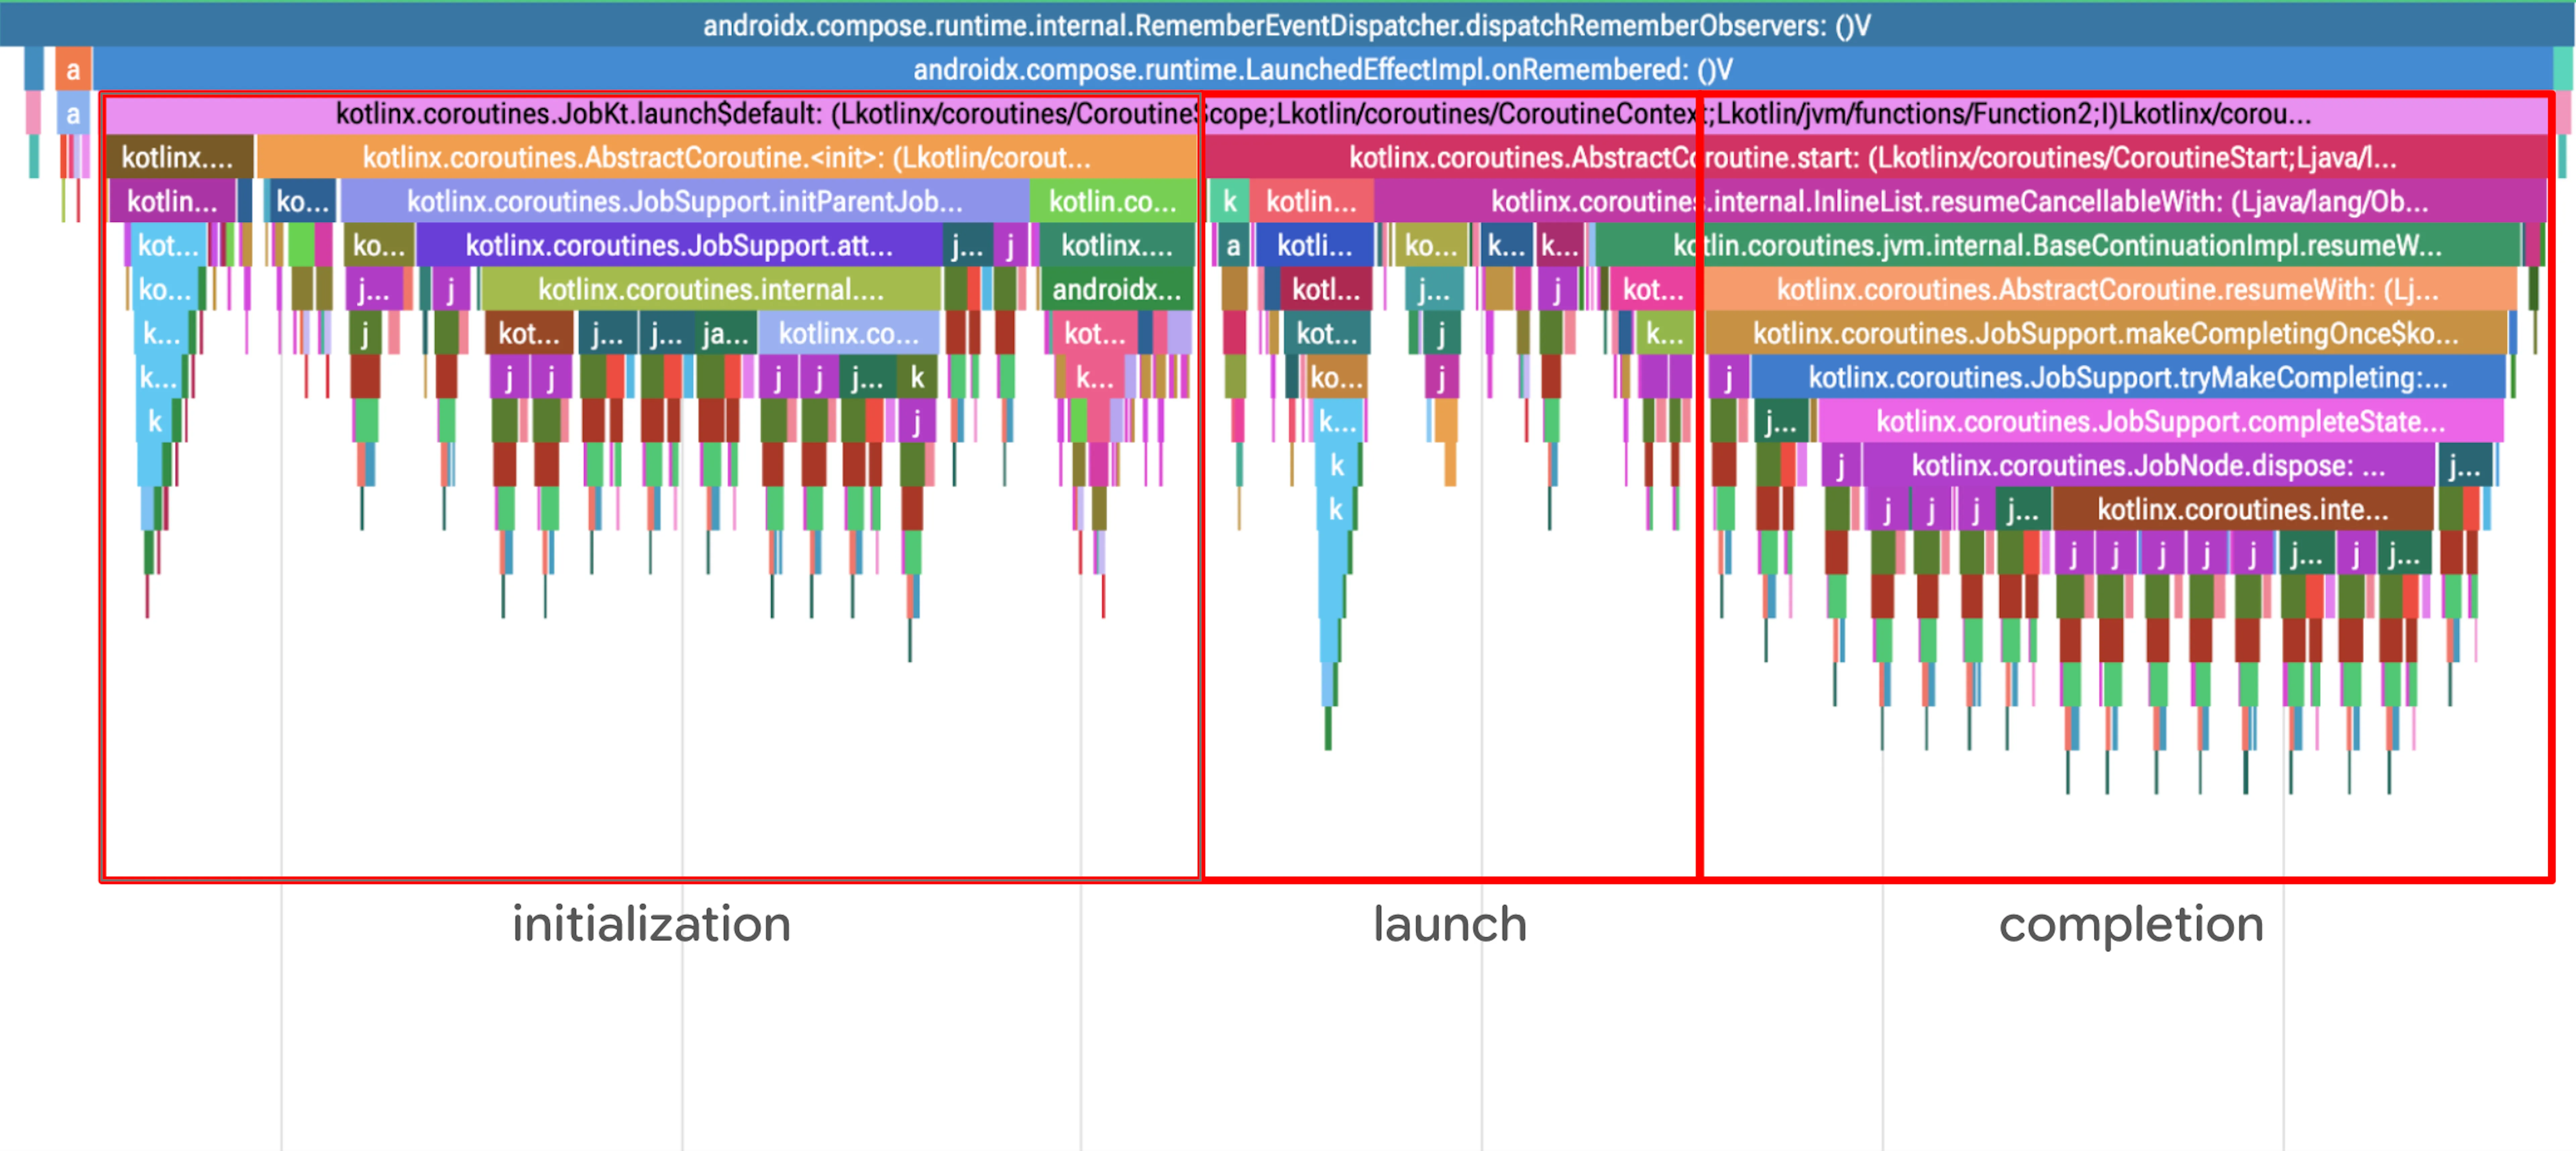
La traccia del metodo riportata sopra può essere suddivisa in tre parti:
- Inizializzazione di una nuova coroutine
- Avvio della coroutine
- Completamento della coroutine (perché termina immediatamente)
L'annullamento di LaunchedEffect è simile al completamento normale, tranne per il fatto che viene creato anche un CancellationException.
Dal profilo sopra, una cosa immediatamente sospetta sono le chiamate frequenti a java.util.concurrent.AtomicReferenceFieldUpdater (caselle viola o verdi con etichette j…). Sebbene ogni chiamata sia relativamente veloce, la frequenza è preoccupante: qualsiasi overhead non trascurabile distribuito su più invocazioni potrebbe sommarsi a una regressione notevole. Se ingrandisci una chiamata, noterai che la maggior parte del tempo viene dedicata ai controlli di riflessione.
Le coroutine implementano una struttura ad albero senza blocchi per le relazioni padre-figlio che rende possibile la concorrenza strutturata. Si è scoperto che la libreria kotlinx.atomicfu implementa operazioni atomiche senza blocchi utilizzando una primitiva JVM nota, AtomicReferenceFieldUpdater. Il programma di aggiornamento utilizza un riferimento di classe e un nome di campo per eseguire operazioni atomiche in fase di runtime e deve eseguire diversi controlli di sicurezza riflessivi per assicurarsi che il campo esista e sia accessibile. Ogni operazione nelle coroutine (avvio, sospensione, annullamento, completamento) chiama almeno un'operazione atomica, quindi se è lenta, le coroutine non funzioneranno bene.
Investigating AtomicReferenceFieldUpdater
Ma non corriamo troppo. AtomicReferenceFieldUpdater è in realtà ben ottimizzato sulla JVM da oltre 10 anni e le tracce dei metodi potrebbero acquisire un overhead completamente rimosso da un'ottimizzazione a livello di VM: compilazioni just-in-time (JIT) o ahead-of-time (AOT). Per verificare il rendimento, scriviamo alcuni benchmark per misurare la differenza tra i riferimenti atomici di kotlinx.atomicfu e java.util.concurrent.atomic.
@RunWith(AndroidJUnit4::class)
class AtomicReferenceBenchmark {
    @get:Rule
    val benchmarkRule = BenchmarkRule()

    private val atomicReference = java.util.concurrent.atomic.AtomicReference(false)
    private val atomicRef = kotlinx.atomicfu.atomic<Boolean>(false)

    @Test
    fun atomicReference_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicReference.compareAndSet(true, false)
            atomicReference.compareAndSet(false, true)
        }
    }

     @Test
    fun atomicRef_compareAndSet() {
        benchmarkRule.measureRepeated {
            atomicRef.compareAndSet(true, false)
            atomicRef.compareAndSet(false, true)
        }
    }

    /* measuring other methods from the method traces above */
}
L'esecuzione di questo benchmark su Pixel 5 (assicurandosi che AtomicReferenceFieldUpdater#compareAndSet venga compilato JIT durante il riscaldamento) produce i seguenti risultati su Pixel 5 (API 33):
 50.7 ns  atomicReference_compareAndSet
135   ns  atomicRef_compareAndSet
Le misurazioni confermano il divario, con la versione kotlinx.atomicfu chiaramente circa 2,7 volte più lenta. Ciò conferma che ART non esegue alcuna ottimizzazione nascosta e che i controlli di accesso riflessivo aggiungono un sovraccarico reale durante l'esecuzione.
Se esaminiamo la traccia del metodo originale, l'unico lavoro significativo eseguito da AtomicReferenceFieldUpdater è la chiamata interna a Unsafe.getObjectVolatile che esegue effettivamente l'operazione atomica sottostante. Nella maggior parte dei casi, l'inizializzatore del programma di aggiornamento è statico e può essere dimostrato che è sempre corretto in base alla struttura della classe circostante. Pertanto, è possibile analizzare staticamente la maggior parte degli utilizzi di AtomicReferenceFieldUpdater e sostituirli con una variante interna di Unsafe durante la compilazione. Inoltre, la toolchain di compilazione di Android ha un proprio compilatore di ottimizzazione in grado di fare esattamente questo.
Ottimizzazione con R8
Le classi Atomic*FieldUpdater supportano l'uso sottile, dinamico e basato sulla reflection, ma vengono spesso utilizzate in pattern statici ovvi. Ciò spiega sia il lento rendimento della baseline sia la necessità di ottimizzazione. R8 è un compilatore di ottimizzazione completo del programma ed è adatto a individuare i pattern più semplici per ridurre il sovraccarico dei controlli di sicurezza riflessivi. R8 riceve il bytecode JVM dopo il compilatore Java o Kotlin, ma per facilitare la leggibilità questi esempi sono presentati nella sintassi Java. Per questo motivo non esistono argomenti di tipo per AtomicReferenceFieldUpdater.
class Example {
    volatile String data = "";
    static final AtomicReferenceFieldUpdater updater =
        AtomicReferenceFieldUpdater.newUpdater(Example.class, String.class, "data");

    void example() {
        // ...
        updater.compareAndSet(this, "", "new");
        // ...
    }
}
L'esempio di base crea un updater finale statico che accede a un campo volatile con argomenti costanti semplici per il titolare, il tipo e il nome del campo. Il riflesso utilizzato è completamente trasparente. È chiaro che questo programma di aggiornamento fa riferimento a un campo valido e che il sito di creazione del programma di aggiornamento ha un accesso valido al campo.
Nella sua essenza, Atomic*FieldUpdater è un wrapper attorno a un offset di campo e alle chiamate a Unsafe. Lo scenario migliore per l'ottimizzazione è sostituire il campo dell'aggiornamento con un campo di offset e sostituire le chiamate all'aggiornamento con chiamate a Unsafe.
Ottimizzazione di Atomic*FieldUpdater
L'ottimizzazione viene implementata in tre parti: strumentazione, sostituzione e pulizia.
Strumentazione
Il primo passo consiste nell'introdurre i campi di offset insieme al campo del programma di aggiornamento per facilitare l'accesso diretto tramite la chiamata Unsafe .
static final long updater$offset =
    SyntheticUnsafe.UNSAFE.objectFieldOffset(Example.class.getDeclaredField("data"))
Si accede al campo tramite reflection e Unsafe viene utilizzato per estrarre l'offset del campo nella classe. Questo codice rappresenta gli elementi interni di Atomic*FieldUpdater se non tieni conto della convalida della reflection. Al contrario, il tipo di titolare dell'aggiornamento e il tipo di campo del campo volatile vengono monitorati staticamente nel compilatore.
Tieni presente che il campo originale e la relativa inizializzazione vengono lasciati invariati. La procedura di ottimizzazione facilita e ottimizza in modo ottimistico gli utilizzi e poi esegue la pulizia. Si tratta di un approccio semplice all'implementazione, ma consente anche l'ottimizzazione parziale dei campi del programma di aggiornamento, in cui alcuni utilizzi vengono lasciati invariati mentre altri vengono ottimizzati.
Sostituzione
A questo punto del compilatore, dopo un punto di unione della concorrenza adatto, abbiamo un elenco di campi di aggiornamento strumentati. Ciò significa che possiamo ottimizzare ogni sito di chiamata singolarmente in base ad alcune condizioni. Considera una chiamata di esempio:
updater.compareAndSet(holder, expectedValue, newValue);
Le condizioni richieste da Atomic*FieldUpdater sono le seguenti:
updaterproviene da un campo strumentato? ovvero, l'analisi statica può tracciare il valore dell'oggetto fino a una lettura del campo di un programma di aggiornamento strumentato?holderè la stessa classe o una sottoclasse del tipo di titolare definito originariamente?newValueè la stessa classe o una sottoclasse del tipo di campo definito originariamente?
Se tutte le condizioni sono soddisfatte, la chiamata viene sostituita da una chiamata a Unsafe senza alcun controllo di riflessione.
SyntheticUnsafe.UNSAFE.compareAndSwapObject(holder, Example.updater$offset, expectedValue, newValue)
Questa nuova chiamata è più veloce e semplice, ma differisce dalla chiamata originale per quanto riguarda la gestione dei valori nulli in updater e holder. A meno che non siano esclusi staticamente, vengono inseriti controlli null per entrambi.
Eliminazione
A questo punto, la classe di attesa ha il campo aggiornatore originale e il nuovo campo offset, insieme ai siti di chiamata che potrebbero utilizzare uno dei due. Se nessuno dei siti di chiamata è stato ottimizzato, il campo offset deve essere rimosso e se tutti i siti di chiamata sono stati ottimizzati, il campo aggiornamento deve essere rimosso. In entrambi i casi, anche la chiamata di inizializzazione deve essere eliminata. L'eliminazione dei campi inutilizzati e la rimozione del codice inutilizzato vengono già eseguite nel compilatore, ma la rimozione del codice di inizializzazione qui richiede qualche trucco in più.
Sia la chiamata a newUpdater che a getDeclaredField potrebbero avere effetti collaterali, in quanto possono generare eccezioni (e la loro implementazione è sconosciuta, poiché dipende dalla versione dell'API). Ciò significa che, a causa dell'ottimizzazione generica, non possono essere rimossi in modo sicuro. Pertanto, questa pulizia ha richiesto una considerazione esplicita dei campi strumentati, poiché è noto che sono staticamente privi di eccezioni.
Alla fine, l'esempio di programma di aggiornamento semplice mostrato sopra appare così dopo l'ottimizzazione:
Risultati
Dopo queste ottimizzazioni, kotlinx.atomicfu e la maggior parte degli utilizzi espliciti di AtomicInt/Long/ReferenceFieldUpdater ora corrispondono al rendimento di AtomicReference con R8 applicato. Infatti, in alcuni benchmark è ancora più veloce: kotlinx.atomicfu ha un plug-in del compilatore che può incorporare istanze di atomic nei campi, riducendo le allocazioni necessarie per creare un campo aggiornato in modo atomico.
Jetpack Compose è stato il principale beneficiario di questo lavoro. Compose Runtime dispone di una serie di microbenchmark che monitorano le prestazioni delle coroutine molto da vicino per rilevare tempestivamente le regressioni delle prestazioni. Quando i benchmark sono stati aggiornati a una nuova versione di R8, abbiamo notato un miglioramento di 2 volte durante l'avvio e l'annullamento delle coroutine in LaunchedEffect.
A parte questo, il team ART sta implementando queste ottimizzazioni in modo nativo a livello di VM. Se la tua app ha come target l'API 36 e viene eseguita su una versione recente di Android, è possibile che il tuo dispositivo stia già ottimizzando le coroutine in modo simile. I benchmark delle coroutine riportati sopra hanno osservato un miglioramento del rendimento di circa il 15% dopo gli aggiornamenti JIT nelle versioni recenti di ART.
La tua app riceverà questa ottimizzazione per impostazione predefinita quando esegui l'upgrade ad AGP 9.2.0 o quando utilizzi direttamente R8 9.2.0. Per saperne di più, vedi D8 dexer e R8 shrinker.
-
 Case study
Il team ha creato un codebase dell'interfaccia utente nativa dell'AI che è il 50% più piccola dell'implementazione originale, ottenendo una riduzione del 35% del tempo di esecuzione dell'agente AI, il 32% in meno di scambi tra ingegnere e agente e una riduzione del 33% del costo dei token.
Pavlo Stavytskyi, Rebecca Franks • Tempo di lettura: 11 minuti -
 Case study
WhatsApp è la più grande piattaforma di messaggistica al mondo, con miliardi di utenti a livello globale. È lo strumento di comunicazione predefinito per le persone di diverse regioni, che collega gli utenti tramite messaggistica privata, affidabile e sicura.
Niharika Arora, Tracy Agyemang, Mayank Jain • Tempo di lettura: 8 min -
 Case study
La missione di Tinder è quella di favorire e ispirare connessioni reali rendendo gli incontri facili e divertenti per ogni nuova generazione di single.
Ajesh Pai, Ulises Uriel Verduzco Díaz , Tracy Agyemang • Tempo di lettura: 4 minuti
Ricevi gli ultimi approfondimenti sullo sviluppo per Android direttamente nella tua casella di posta ogni settimana.