Android Bench 2.0: Mendorong batas kemampuan dengan tugas-tugas yang menantang dan berjangka panjang
Waktu baca: 3 menit
Saat pertama kali meluncurkan Android Bench, kami membangun fondasi yang ketat untuk mengevaluasi cara model bahasa besar (LLM) membantu developer dalam tugas Android di dunia nyata. Seiring dengan perkembangan pesat model dan agen AI, kami telah memperbarui metodologi kami, seperti menyelaraskan framework tolok ukur kami dengan framework Harbor. Hari ini kami merilis kumpulan pertama tugas jangka panjang (LHT), yaitu tugas yang sangat kompleks yang memerlukan waktu beberapa hari atau bahkan seminggu bagi seorang engineer untuk menyelesaikannya. Kami juga memperkenalkan evaluasi berbasis agen, yang dimulai dengan agen dari penyedia model yang sesuai. Penambahan ini membawa kita ke Android Bench 2.0—upgrade besar yang dirancang untuk mengevaluasi model dan agen AI berdasarkan skala, ambiguitas, dan pemecahan masalah multi-langkah yang kompleks yang Anda lakukan setiap hari.
Dari perbaikan inkremental hingga tugas jangka panjang
Iterasi pertama Android Bench, bersama dengan tolok ukur coding AI awal yang serupa, berfokus pada perubahan inkremental pada repositori yang ada, yang dalam banyak kasus terbatas pada perbaikan bug atau permintaan fitur yang lebih kecil. Hal ini mencerminkan kemampuan bantuan AI pada saat itu, serta cara Anda menggunakannya.
Untuk terus membantu Anda menemukan model dan agen coding yang paling sesuai dengan alur kerja pengembangan Anda, kami telah meningkatkan standar evaluasi kami agar sesuai dengan tugas yang Anda delegasikan ke AI. Android Bench 2.0 mencerminkan tantangan ambisius ini dengan LHT yang mencakup mengupgrade dependensi, menambahkan fitur baru, membangun aplikasi dari awal, atau mengonversi aplikasi lintas platform ke Android.
Tugas yang kompleks memerlukan evaluasi dan pemberian skor yang lebih bernuansa
Pada tugas engineering multi-hari, penilaian lulus atau gagal biner tidak mencakup gambaran lengkapnya.
Misalnya, agen mungkin memfaktorkan ulang 40 layar ke Jetpack Compose, menyiapkan tabel database, dan memenuhi 90% persyaratan, tetapi gagal dalam satu pernyataan kasus ekstrem. Pemberian skor biner menilai proses ini sebagai 0%, sehingga menyamarkan kemampuan arsitektur model. Kami beralih ke pemberian skor berkelanjutan untuk memberikan sinyal yang lebih bermakna, baik untuk pengembangan model maupun untuk pemahaman Anda tentang cara AI dapat membantu Anda.
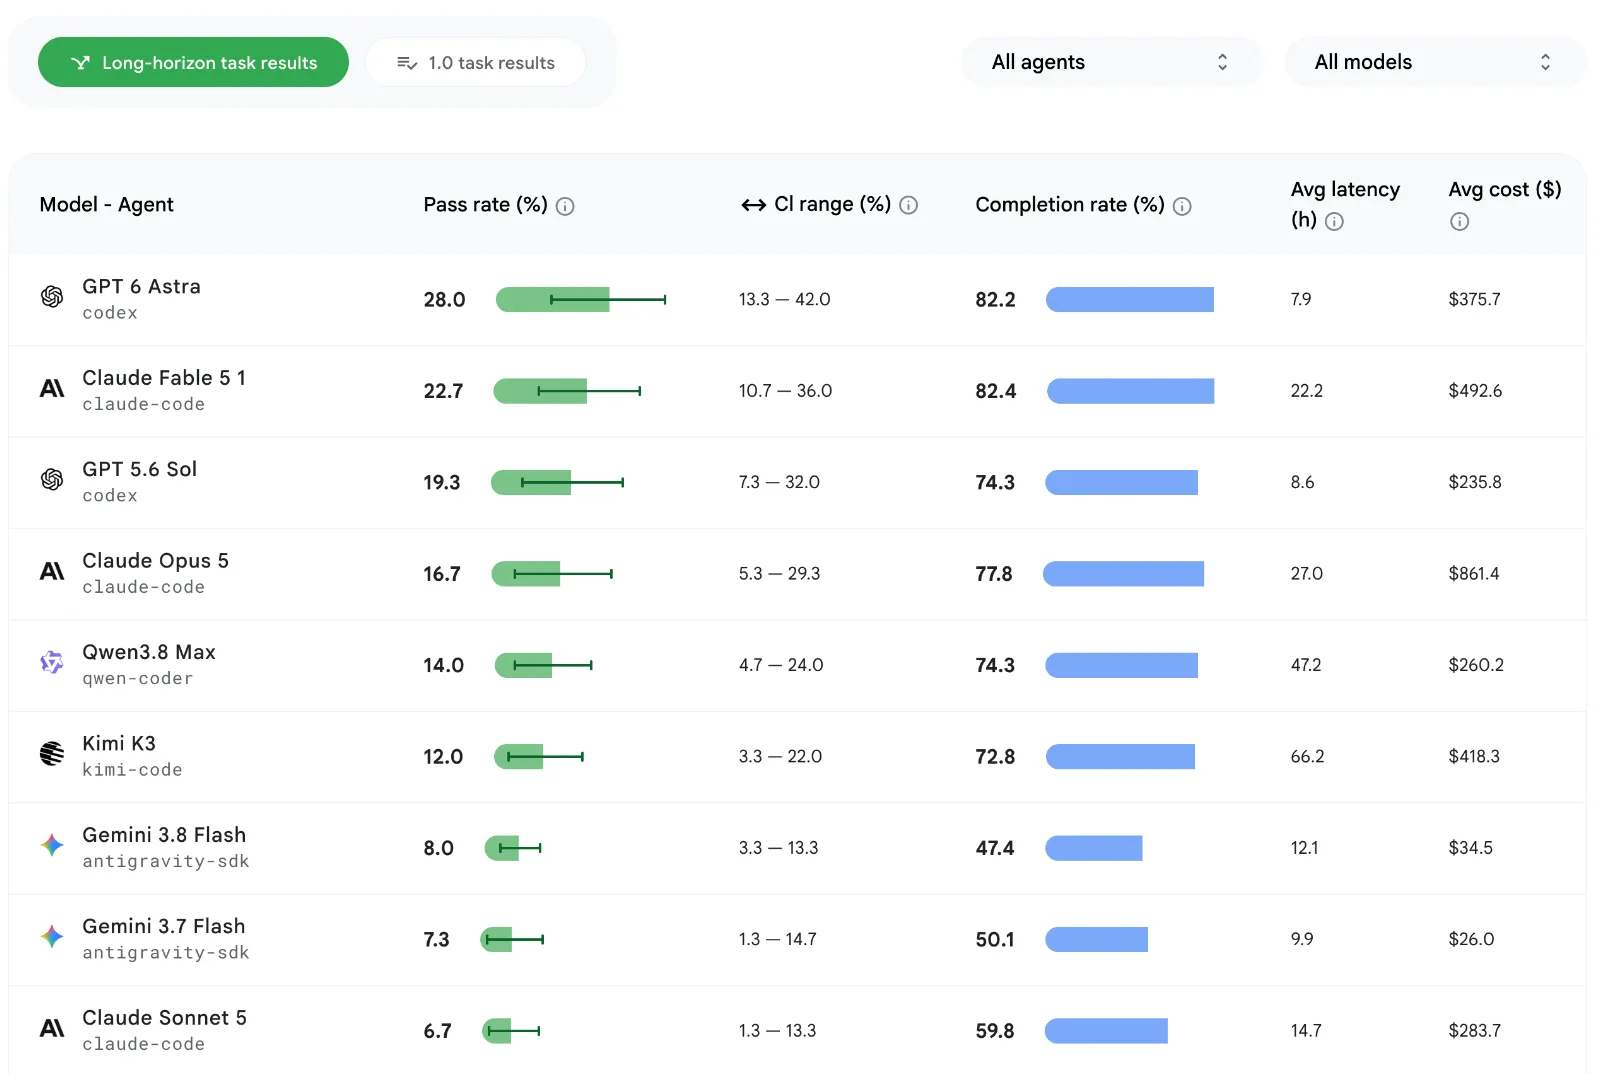
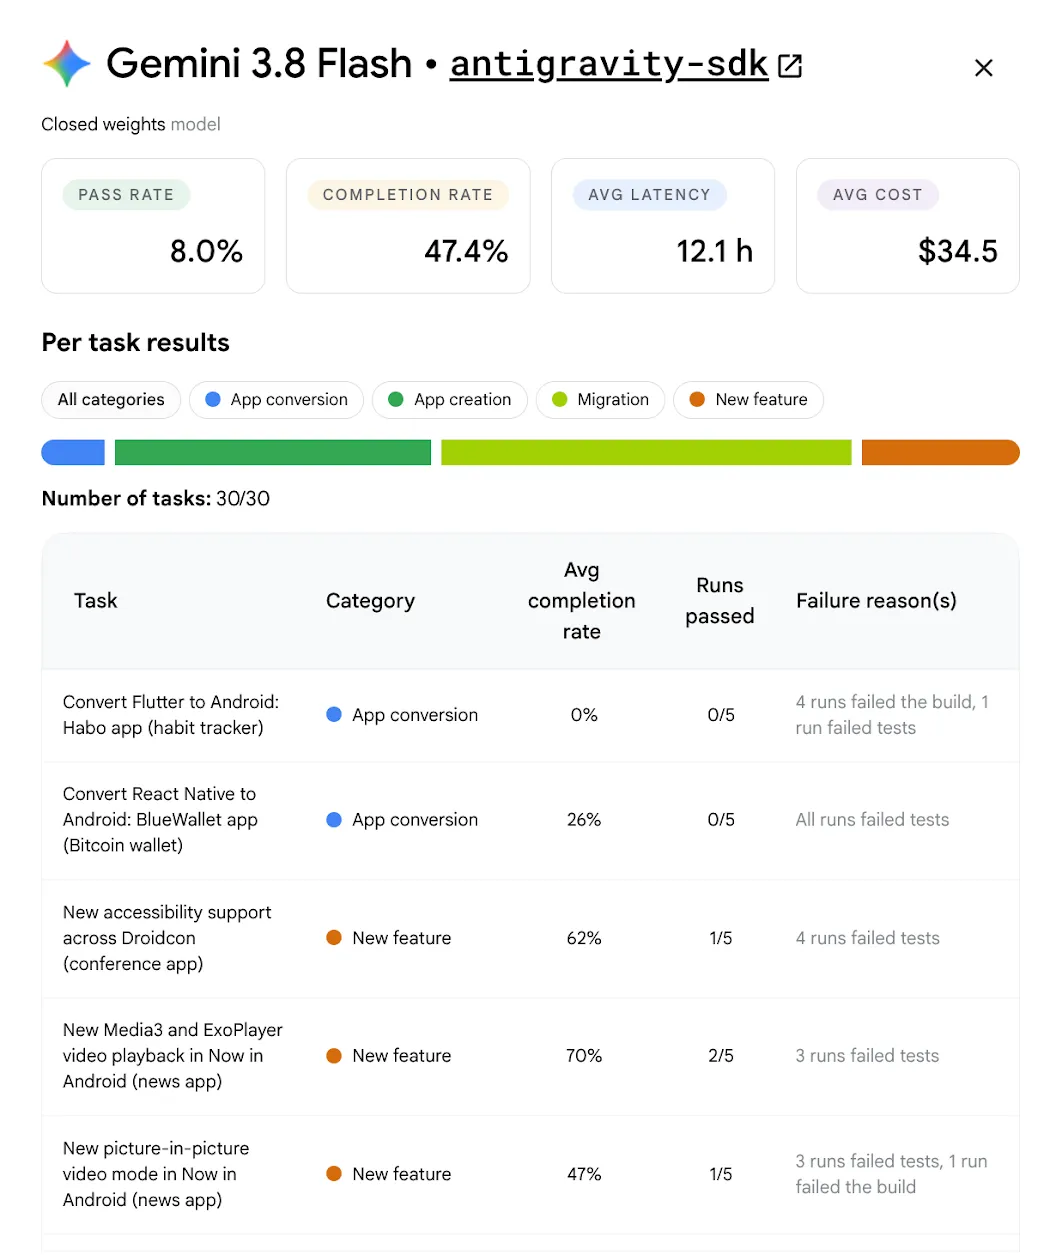
Kami menghitung rasio penyelesaian ini melalui kombinasi faktor seperti fungsi, kesetiaan visual, dan menghindari regresi. Kami juga menerapkan penalti pemberian skor objektif untuk penyimpangan dari petunjuk evaluasi atau batasan struktural. Lihat papan peringkat yang diperbarui dan klik tampilan kartu setiap model untuk melihat elemen tambahan seperti tingkat kelulusan, tingkat penyelesaian, dan biaya rata-rata per model dan per tugas.
Tingkat kelulusan tertinggi untuk LHT adalah sekitar 28%, jauh lebih rendah daripada ~91% untuk tugas asli dalam tolok ukur.
Tugas dengan cakupan waktu yang panjang akan mengungkap insight bermanfaat untuk bantuan AI
Selain mengukur seberapa baik AI menangani tugas yang berjalan lama, set data LHT membantu kami mempelajari lebih lanjut kekuatan dan kelemahan model yang diuji, dan kami menawarkan panduan yang lebih praktis kepada Anda.
Di seluruh tingkat model, AI lebih baik dalam menulis kode baru daripada melakukan refaktorisasi kode yang ada. Pemfaktoran ulang dan migrasi menjadi lebih rumit karena keberhasilannya bergantung pada kompleksitas arsitektur, bukan volume kode.
Model menunjukkan kemampuan yang kuat pada transformasi deterministik yang sudah mapan, seperti mengonversi Java ke Kotlin, menukar Retrofit dengan Ktor, atau memperkenalkan lapisan ViewModel. Mereka menerapkan pola ini secara konsisten, bahkan di lebih dari 125 file dan 8.000 baris kode.
Namun, model akan kesulitan saat tugas memerlukan validasi runtime (seperti grafik injeksi dependensi yang hilang), melibatkan perubahan framework yang merusak, atau mengalami kesenjangan pengetahuan dengan library yang belum dirilis. Meng-porting aplikasi lintas platform ke Android tetap menjadi tantangan terbuka—tidak ada model yang mencapai tingkat kelulusan 100%, dan model terdepan paling banyak mencapai tingkat penyelesaian 80%.
Memperkenalkan evaluasi agen
Untuk membantu Anda lebih memahami performa model saat diintegrasikan ke dalam alur kerja agentic, kami menambahkan agen yang umum digunakan ke dalam evaluasi kami. Kami memulai dengan menjalankan model baru terhadap LHT dengan agen dari penyedia model yang sesuai. Misalnya, kami menjalankan GPT 5.6 Sol di Codex, dan Gemini 3.8 Flash di Google Antigravity. Penyandingan ini menunjukkan bagaimana desain harness berdampak positif pada hasil developer, karena kita telah melihat bahwa penyimpanan dalam cache perintah dan penyesuaian jendela alat yang ringkas dapat menghasilkan pengurangan token.
Kami akan memperluasnya pada masa mendatang dengan juga menandai hasil di berbagai kombinasi model dan agen, untuk membantu Anda menemukan kombinasi yang paling cocok untuk Anda dan tim Anda.
Kami berinvestasi dalam pengukuran ini karena penting bagi Anda untuk dapat menggunakan agen dan model pilihan Anda untuk pengembangan Android, dan kami akan menyampaikan informasi selengkapnya kepada Anda dalam beberapa minggu mendatang.
Model baru ditambahkan
Selain itu, kami terus memperluas papan peringkat untuk memastikan Anda memiliki data terbaru untuk keputusan pengembangan Anda. Kami menambahkan Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 dari OpenAI, Fable 5.1 dari Anthropic, Kimi K3, dan Qwen 3.8 Max, dengan GPT-6 Astra dari OpenAI di posisi teratas dengan tingkat kelulusan 28%.
Rencana ke depan
Android Bench 2.0 menyediakan lingkungan yang andal untuk mengukur AI untuk pengembangan Android. Dengan menggabungkan tugas jangka panjang, evaluasi multimodal, agen, dan pemberian skor berkelanjutan, kami berharap dapat memberdayakan tim riset AI untuk membangun partner coding AI yang lebih mumpuni dan andal, serta memberikan lebih banyak transparansi terkait opsi Anda untuk pengembangan AI.
Lihat papan peringkat yang diperbarui beserta metodologi yang diperbarui. Masukan Anda secara langsung memengaruhi cara kami mengembangkan Android Bench, jadi terus sampaikan masukan Anda kepada kami di GitHub, serta saluran media sosial kami seperti X dan LinkedIn.
-
 Berita Produk
Sebagai developer Android, Anda memiliki banyak pilihan terkait agen, LLM, alat, dan antarmuka command line (CLI) yang digunakan untuk pengembangan aplikasi. Sasaran kami adalah membantu Anda membangun aplikasi Android yang indah dan berkualitas tinggi, apa pun cara yang Anda pilih untuk membangunnya.
Simona Milanovic • Waktu baca: 4 menit -
 Berita Produk
Tahun lalu, Android Studio membuka diri untuk model AI apa pun. Hari ini, kami mengambil langkah selanjutnya dengan memperkenalkan dukungan untuk agen coding pilihan Anda.
Matthew Warner • Waktu baca: 3 menit -
 Berita Produk
Pada bulan Maret lalu, kami memperkenalkan Android Bench—papan peringkat LLM kami untuk tugas pengembangan Android di dunia nyata. Sejak saat itu, kami telah meningkatkan kualitas tolok ukur berdasarkan masukan Anda, termasuk mengevaluasi model berat terbuka dan menambahkan dimensi biaya dan efisiensi ke papan peringkat.
Zoe Lopez-Latorre • Waktu baca: 3 menit
Dapatkan insight pengembangan Android terbaru yang dikirim ke kotak masuk Anda setiap minggu.