Améliorer le développement Android assisté par l'IA et les LLM avec Android Bench
Temps de lecture : 2 min
Nous voulons vous aider à créer plus rapidement et plus facilement des applications Android de haute qualité. Pour cela, nous mettons l'IA à votre disposition. Nous savons que vous souhaitez une IA qui comprenne vraiment les nuances de la plate-forme Android. C'est pourquoi nous avons mesuré les performances des LLM pour les tâches de développement Android. Nous venons de publier la première version d'Android Bench, notre classement officiel des LLM pour le développement Android.
Notre objectif est de fournir aux créateurs de modèles un benchmark pour évaluer les capacités des LLM pour le développement Android. En établissant une référence claire et fiable pour le développement Android de haute qualité, nous aidons les créateurs de modèles à identifier les lacunes et à accélérer les améliorations. Les développeurs peuvent ainsi travailler plus efficacement avec un plus large éventail de modèles utiles pour l'assistance IA. Cela permettra, à terme, de créer des applications de meilleure qualité dans l'écosystème Android.
Conçu pour les tâches de développement Android concrètes
Nous avons créé le benchmark en sélectionnant un ensemble de tâches dans différents domaines de développement Android courants. Il se compose de vrais défis de difficulté variable, provenant de dépôts GitHub Android publics. Par exemple, résoudre les problèmes de compatibilité entre les versions d'Android, effectuer des tâches spécifiques à un domaine comme la mise en réseau sur les wearables ou migrer vers la dernière version de Jetpack Compose.
Chaque évaluation tente de faire en sorte qu'un LLM corrige le problème signalé dans la tâche, que nous vérifions ensuite à l'aide de tests unitaires ou d'instrumentation. Cette approche indépendante du modèle nous permet de mesurer la capacité d'un modèle à parcourir des bases de code complexes, à comprendre les dépendances et à résoudre les types de problèmes que vous rencontrez tous les jours.
Nous avons validé cette méthodologie auprès de plusieurs fabricants de LLM, dont JetBrains.
Mesurer l'impact de l'IA sur Android est un défi de taille. C'est donc formidable de voir un framework aussi solide et réaliste. Bien que nous effectuions régulièrement des analyses comparatives, Android Bench est un ajout unique et bienvenu. Cette méthodologie est exactement le type d'évaluation rigoureuse dont les développeurs Android ont besoin en ce moment.
- Kirill Smelov, responsable des intégrations d'IA chez JetBrains.
Premiers résultats d'Android Bench
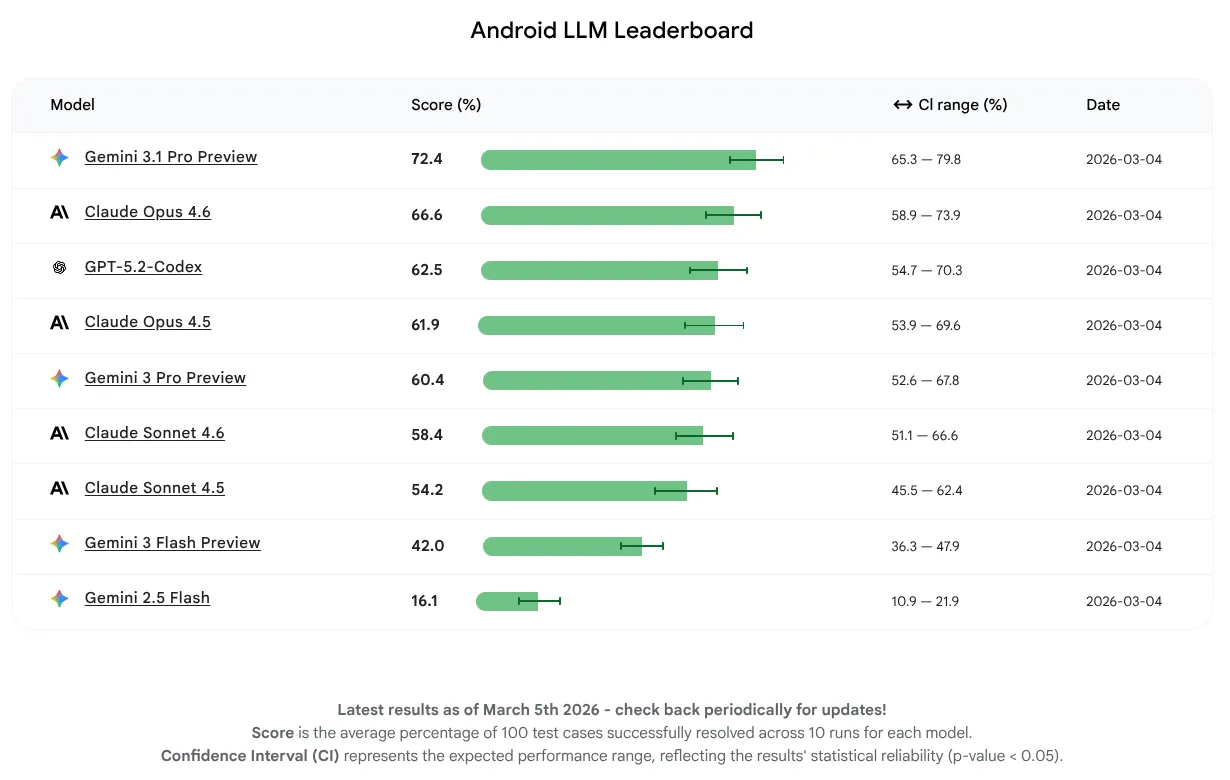
Pour cette première version, nous voulions mesurer uniquement les performances du modèle, sans nous concentrer sur l'utilisation d'agents ou d'outils. Les modèles ont réussi à accomplir entre 16 % et 72 % des tâches. Cette large plage montre que certains LLM disposent déjà d'une base solide de connaissances sur Android, tandis que d'autres ont encore une marge de progression. Quel que soit l'état actuel des modèles, nous prévoyons une amélioration continue, car nous encourageons les créateurs de LLM à améliorer leurs modèles pour le développement Android.
Le LLM ayant obtenu le score moyen le plus élevé pour cette première version est Gemini 3.1 Pro, suivi de près par Claude Opus 4.6. Vous pouvez essayer tous les modèles que nous avons évalués pour l'assistance IA pour vos projets Android en utilisant des clés API dans la dernière version stable d'Android Studio.
Fournir de la transparence aux développeurs et aux créateurs de LLM
Nous accordons de l'importance à une approche ouverte et transparente. C'est pourquoi nous avons rendu publics notre méthodologie, notre ensemble de données et notre plate-forme de test sur GitHub.
L'un des défis de tout benchmark public est le risque de contamination des données, où les modèles peuvent avoir vu des tâches d'évaluation au cours de leur processus d'entraînement. Nous avons pris des mesures pour nous assurer que nos résultats reflètent un raisonnement authentique plutôt qu'une mémorisation ou une devinette. Cela inclut un examen manuel approfondi des trajectoires des agents ou l'intégration d'une chaîne Canary pour décourager l'entraînement.
À l'avenir, nous continuerons à faire évoluer notre méthodologie pour préserver l'intégrité de l'ensemble de données, tout en apportant des améliorations aux futures versions du benchmark (par exemple, en augmentant la quantité et la complexité des tâches).
Nous sommes impatients de découvrir comment Android Bench peut améliorer l'assistance par l'IA à long terme. Notre objectif est de combler le fossé entre le concept et le code de qualité. Nous posons les bases d'un avenir où, quoi que vous imaginiez, vous pourrez le créer sur Android.
-
 Nouveautés produit
Aujourd'hui, nous lançons le premier ensemble de tâches à long terme (LHT, Long-Horizon Tasks). Il s'agit de tâches très complexes qui nécessitent plusieurs jours, voire une semaine, pour être accomplies par un ingénieur. Nous lançons également l'évaluation agentique, en commençant par les agents des fournisseurs de modèles correspondants.
Matthew McCullough • Temps de lecture : 3 min -
 Nouveautés produit
Aujourd'hui, nous lançons Android 17 et le rendons disponible sur la plupart des appareils Pixel compatibles. De nouveaux appareils fonctionnant sous Android 17 seront disponibles dans les prochains mois.
Matthew McCullough • Temps de lecture : 13 min -
 Nouveautés produit
Google I/O 2026 présente 17 annonces clés pour les développeurs Android, axées sur la productivité pilotée par les agents, Compose First comme norme d'UI, et les médias hautes performances et le développement adaptatif pour l'écosystème en expansion.
Matthew McCullough • Temps de lecture : 8 min
Recevez chaque semaine les dernières informations sur le développement Android directement dans votre boîte de réception.