

যদিও মেমরিকে প্রায়শই একটি একক, অভিন্ন স্টোরেজ পুল হিসাবে ভাবা হয়, এর ভৌত গঠন এবং সিপিইউ যেভাবে এটি অ্যাক্সেস করে, তা অ্যাপ্লিকেশনের পারফরম্যান্সের উপর গভীর প্রভাব ফেলে। সিপিইউ-এর ক্যাশ হায়ারার্কির কার্যকর ব্যবহার করে এমন উচ্চ-পারফরম্যান্স কোড লেখার জন্য মেমরি লোকালিটি বোঝা অত্যন্ত গুরুত্বপূর্ণ।
সিপিইউ ক্যাশে শ্রেণিবিন্যাস
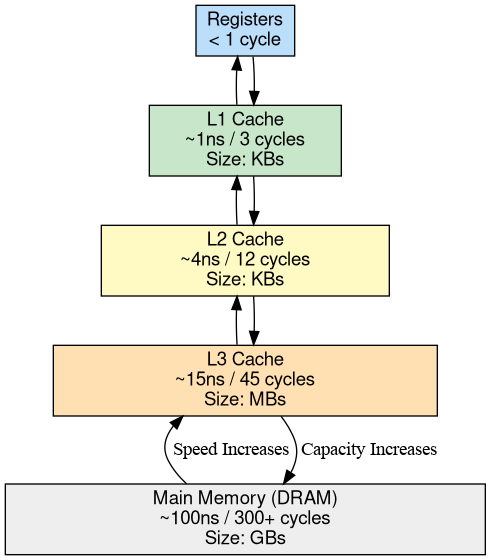
একটি আধুনিক মোবাইল সিপিইউ সিস্টেমের প্রধান র্যাম (ডিআরএএম) থেকে অনেক বেশি দ্রুত। পারফরম্যান্সের এই ব্যবধান পূরণ করতে, সিপিইউগুলো ক্যাশ নামক বিভিন্ন স্তরের ক্ষুদ্র ও অত্যন্ত দ্রুতগতির মেমরি ব্যবহার করে।
- L1 ক্যাশে (লেভেল 1) : সবচেয়ে ছোট এবং দ্রুততম (~1ns)। একটি 3GHz সিপিইউতে, এটি প্রায় 3 ক্লক সাইকেলের সমান।
- L2 ক্যাশে (লেভেল ২) : আকারে বড় এবং কিছুটা ধীরগতির (~৩-৫ ন্যানোসেকেন্ড, বা ~১০-১৫ সাইকেল)।
- L3 ক্যাশে (লেভেল ৩) : সবচেয়ে বড় ক্যাশে (~১০-২০ ন্যানোসেকেন্ড, বা ~৩০-৬০ সাইকেল)।
- প্রধান মেমরি (DRAM) : সবচেয়ে বড় এবং সবচেয়ে ধীরগতির (~১০০ ন্যানোসেকেন্ড+, বা ~৩০০+ সাইকেল)।
বিলম্বের প্রেক্ষাপট: স্থবিরতার খরচ
এই সংখ্যাগুলোর প্রভাব বোঝার জন্য, একটি আধুনিক সুপারস্কেলার সিপিইউ-এর কথা বিবেচনা করুন যা প্রতি ক্লক সাইকেলে ৪ থেকে ৮টি ইনস্ট্রাকশন সম্পন্ন করতে পারে।
যদি সিপিইউ সমস্ত ক্যাশে খুঁজে না পায় এবং ডিআরএএম রিডের জন্য ১০০ ন্যানোসেকেন্ড (৩০০ সাইকেল) অপেক্ষা করতে হয়:
- হারানো সাইকেল : ~৩০০ সাইকেল।
- "ব্যর্থ" নির্দেশাবলী : ১,২০০ থেকে ২,৪০০টি নির্দেশাবলী , যেগুলো কার্যকর করা যেত যদি ডেটা আগে থেকেই কোনো লোকাল রেজিস্টার বা L1 ক্যাশে থাকত।
যখন আপনার কোডের মেমোরি লোকালিটি দুর্বল থাকে, তখন সিপিইউ যে সবসময় জটিল গাণিতিক কাজে ব্যস্ত থাকে, এমনটা নয়; বরং এটি প্রায়শই "থেমে" যায় এবং মেমোরি সাবসিস্টেমের জন্য অপেক্ষা করতে গিয়ে হাজার হাজার ইন্সট্রাকশন-ইকুইভ্যালেন্ট পর্যন্ত নিষ্ক্রিয়ভাবে বসে থাকে।
প্রতি চক্রে নির্দেশাবলী (IPC)
এই দক্ষতা পরিমাপের একটি প্রধান মেট্রিক হলো ইনস্ট্রাকশনস পার সাইকেল (IPC) । IPC নির্দেশ করে যে, সিপিইউ প্রতিটি ক্লক সাইকেলে গড়ে কতগুলো ইনস্ট্রাকশন সফলভাবে "রিটায়ার" (সম্পূর্ণ) করে।
- উচ্চ আইপিসি (যেমন, ৩.০ - ৫.০) : সিপিইউ উচ্চ দক্ষতার সাথে কাজ করছে এবং সম্ভবত এর বেশিরভাগ ডেটা L1/L2 ক্যাশে বা রেজিস্টার থেকে সংগ্রহ করছে।
- নিম্ন আইপিসি (যেমন, < ০.৫) : সিপিইউ মারাত্মকভাবে বাধাগ্রস্ত হচ্ছে। সিস্টেম মনিটরে সিপিইউ-এর "ব্যবহার" ১০০% দেখালেও, এটি আসলে বেশিরভাগ সময় মেমোরির জন্য অপেক্ষা করতে ব্যয় করে—এই অবস্থাকে মেমোরি স্টল বলা হয়।
মেমরি লোকালিটিই হলো প্রধান নিয়ামক যা নির্ধারণ করে যে একটি ডেটা-ইনটেনসিভ লুপ উচ্চ আইপিসি-তে চলবে, নাকি একাধিক স্টলে পর্যবসিত হবে।
ক্যাশ লাইন
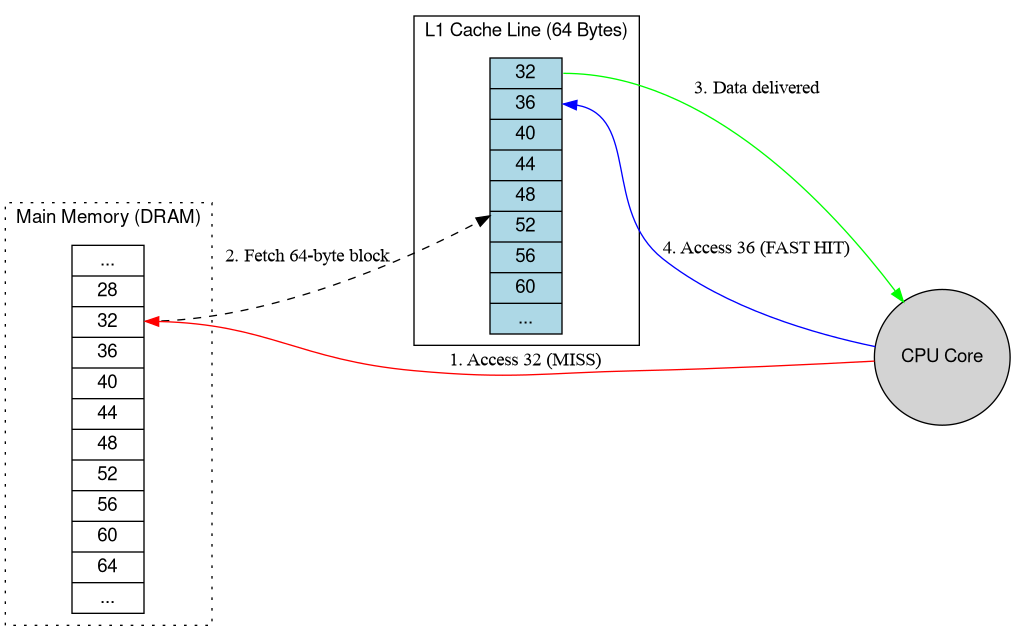
সিপিইউ মেমরি থেকে একক বাইট লোড করে না। এর পরিবর্তে, এটি ক্যাশ লাইন নামক নির্দিষ্ট আকারের ব্লক লোড করে, যা সাধারণত ৬৪ বাইটের হয়ে থাকে। যখন আপনি একটি একক ভেরিয়েবল অ্যাক্সেস করেন, তখন সিপিইউ সেটিকে ধারণকারী সম্পূর্ণ ৬৪-বাইটের অংশটি ক্যাশে নিয়ে আসে।
TLB (অনুবাদ লুকসাইড বাফার)
অ্যান্ড্রয়েড ভার্চুয়াল মেমরি ব্যবহার করে। প্রতিটি মেমরি অ্যাক্সেসের জন্য একটি ভার্চুয়াল অ্যাড্রেসকে ফিজিক্যাল অ্যাড্রেসে রূপান্তর করতে হয়। TLB হলো একটি বিশেষায়িত ক্যাশে যা সাম্প্রতিক রূপান্তরগুলো সংরক্ষণ করে। TLB মিস হলে কার্নেলকে মেইন মেমরির পেজ টেবিলগুলো ওয়াক করতে হয়, যা TLB হিটের তুলনায় একটি অপেক্ষাকৃত ব্যয়বহুল অপারেশন।
হার্ডওয়্যার প্রোফাইল: পিক্সেল ১০ প্রো ফোল্ড
নিম্নলিখিত অনুশীলনগুলোর জন্য আমরা একটি পিক্সেল ১০ প্রো ফোল্ড হার্ডওয়্যার ডিভাইস ব্যবহার করেছি। এই ডিভাইসটিতে গুগল টেনসর জি৫ এসওসি রয়েছে।
হার্ডওয়্যারকে জিজ্ঞাসাবাদ করা
মেমরি সাবসিস্টেমটি বোঝার জন্য, আমরা প্রথমে সিপিইউ কনফিগারেশন এবং ক্যাশ প্যারামিটারগুলো পরীক্ষা করি।
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
সিপিইউ অংশগুলি ডিকোড করা
/proc/cpuinfo তে থাকা CPU part মানগুলো হলো ARM CPU কোরগুলোর হেক্সাডেসিমাল শনাক্তকারী। Pixel 10 Pro Fold-এ থাকা Laguna SoC-এর ক্ষেত্রে, এগুলোর মান হলো:
-
0xd8b: এআরএম কর্টেক্স-এ৫২০ (দক্ষতা কোর) -
0xd90: এআরএম কর্টেক্স-এ৭২০ (পারফরম্যান্স কোর) -
0xd8c: এআরএম কর্টেক্স-এক্স৪ (প্রাইম কোর)
এই ৪+৩+১ কনফিগারেশনটি আধুনিক মোবাইল এসওসি-গুলোতে প্রচলিত, যেখানে বিভিন্ন ক্লাস্টারের ক্যাশ সাইজ এবং ল্যাটেন্সি ভিন্ন হতে পারে।
এলাকার প্রকারভেদ
কার্যকরী সফ্টওয়্যার ডিজাইন প্রধানত দুই ধরনের স্থানীয়তার উপর নির্ভর করে:
- স্থানিক নৈকট্য (Spatial Locality) : যদি কোনো মেমোরি লোকেশন অ্যাক্সেস করা হয়, তাহলে কাছাকাছি থাকা মেমোরি লোকেশনগুলোও শীঘ্রই অ্যাক্সেস হওয়ার সম্ভাবনা থাকে। ক্রমানুসারে অ্যারে ট্রাভার্সাল এর একটি উৎকৃষ্ট উদাহরণ। যেহেতু সিপিইউ একটি সম্পূর্ণ ক্যাশ লাইন লোড করে, তাই কোনো অ্যারের পরবর্তী এলিমেন্ট যদি আগে থেকেই ক্যাশ লাইনে থাকে, তবে সেটি অ্যাক্সেস করা প্রায় "বিনামূল্যে" হয়ে যায়।
- টেম্পোরাল লোকালিটি : যদি কোনো মেমোরি লোকেশন অ্যাক্সেস করা হয়, তাহলে শীঘ্রই সেই একই লোকেশন আবার অ্যাক্সেস করার সম্ভাবনা থাকে। ভালো অ্যালগরিদমগুলো ক্যাশে থাকা অবস্থায়ই ডেটা পুনরায় ব্যবহার করে।
হাতে-কলমে অনুশীলন: সিম্পলপার্ফ দিয়ে অবস্থান পরিমাপ
এই অনুশীলনীতে, আমরা একটি ২৫৬ মেগাবাইট ম্যাট্রিক্সের দুটি ভিন্ন ট্রাভার্সাল চালানোর সময় হার্ডওয়্যার পারফরম্যান্স কাউন্টারগুলো নিরীক্ষণ করতে simpleperf ব্যবহার করব।
- রো-মেজর ট্রাভার্সাল : এটি ম্যাট্রিক্সের উপাদানগুলোকে মেমরিতে সংরক্ষিত ক্রমানুসারে অ্যাক্সেস করে। এটি ক্যাশ-বান্ধব এবং স্পেশিয়াল লোকালিটির সুবিধা গ্রহণ করে।
- কলাম-মেজর ট্র্যাভার্সাল : এটি কলাম অনুসারে এলিমেন্ট অ্যাক্সেস করার জন্য মেমোরি জুড়ে লাফিয়ে লাফিয়ে যায়। এর ফলে প্রায়শই ক্যাশে এবং টিএলবি (TLB) বাদ পড়ে যায়, যা সিপিইউকে স্টল করতে বাধ্য করে।
১. সিম্পলপার্ফ দিয়ে চালান
বাইনারিটি পুশ করুন, এটি এক্সিকিউটেবল কিনা তা নিশ্চিত করুন, এবং ক্যাশে ও টিএলবি ইভেন্ট পরিমাপ করতে simpleperf stat ব্যবহার করুন। ইউজারস্পেসে ইভেন্ট পরিমাপ করার জন্য আমরা :u সাফিক্সটি ব্যবহার করি। বেশিরভাগ ডিভাইসে হার্ডওয়্যার পিএমইউ কাউন্টার অ্যাক্সেস করার জন্য এই কমান্ডগুলো চালাতে adb root প্রয়োজন হয়।
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
প্রোফাইল সারি-প্রধান:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
প্রোফাইল কলাম-প্রধান:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
২. নমুনা পরিমাপ (পিক্সেল ১০ প্রো ফোল্ড)
নিম্নলিখিত ফলাফলগুলো একটি পিক্সেল ১০ প্রো ফোল্ড হার্ডওয়্যার ডিভাইসে পরিমাপ করা হয়েছে:
| মেট্রিক | রো-মেজর (বন্ধুত্বপূর্ণ) | কলাম-মেজর (অবন্ধুসুলভ) | পার্থক্য |
|---|---|---|---|
| কার্যকর করার সময় | ০.৮৩ সেকেন্ড | ৬৮.৩ সেকেন্ড | ~৮২ গুণ ধীর |
| নির্দেশাবলী | ৫.২৭ বিলিয়ন | ১০.২০ বিলিয়ন | ~১.৯ গুণ বেশি |
| সিপিইউ সাইকেল | ১.২০ বিলিয়ন | ৬২.১৮ বিলিয়ন | ~৫২ গুণ বেশি |
| প্রতি চক্রে নির্দেশাবলী (IPC) | ৪.৪০ | ০.১৬ | ২৭ গুণ কম দক্ষতা |
| L1 ডেটা ক্যাশে মিস | ২১০ মিলিয়ন | ৩,৩৬৯ মিলিয়ন | ১৬ গুণ বেশি মিস |
| dTLB লোড মিস | ০.১৩ মিলিয়ন | ২,৮৮৮ মিলিয়ন | ২২,০০০ গুণ বেশি ভুল |
৩. ফলাফলের বিশ্লেষণ
- আইপিসি ক্র্যাশ : রো-মেজর টেস্টে, সিপিইউ ৪.৪০-এর একটি আইপিসি অর্জন করে, যা নির্দেশ করে যে এটি প্রতি সাইকেলে একাধিক নির্দেশনা দক্ষতার সাথে সম্পাদন করছে। কলাম-মেজর টেস্টে, আইপিসি কমে ০.১৬-তে নেমে আসে। এর অর্থ হলো, সিপিইউ ৯৬% সময় ডিআরএএম থেকে ডেটা আসার অপেক্ষায় আটকে থাকে।
- TLB প্রতিবন্ধকতা : সবচেয়ে বড় পার্থক্যটি হলো dTLB-লোড-মিস-এর ক্ষেত্রে। অনুক্রমিক অ্যাক্সেস (রো-মেজর) একই মেমরি পেজের মধ্যেই সীমাবদ্ধ থাকে, ফলে TLB মিস খুব কম হয়। কলাম জুড়ে লাফিয়ে লাফিয়ে যাওয়া (কলাম-মেজর) সিপিইউকে ক্রমাগত নতুন পেজ রেফারেন্স করতে বাধ্য করে, যা TLB-কে ভারাক্রান্ত করে এবং ব্যয়বহুল পেজ টেবিল ওয়াক করতে বাধ্য করে।
- ক্যাশ দক্ষতা : কলাম-মেজর ট্র্যাভার্সালের ফলে ১৬ গুণ বেশি L1 ক্যাশ মিস হয়, যা সিপিইউকে ক্রমাগত অনেক ধীরগতির L3 বা DRAM থেকে ডেটা আনতে বাধ্য করে।
পর্যবেক্ষণ: যদিও উভয় ট্র্যাভার্সালই একই ডেটার উপর একই লজিক্যাল অপারেশন সম্পাদন করেছিল, কলাম-মেজর ট্র্যাভার্সালটি ৮০ গুণেরও বেশি ধীর ছিল। এই বিশাল পার্থক্যটি সম্পূর্ণরূপে সিপিইউ-এর মেমরি সাবসিস্টেমের ভৌত বাস্তবতার সাথে অ্যাক্সেস প্যাটার্নের মিথস্ক্রিয়ার কারণে ঘটে।
জাভা এবং কোটলিন ডেটা স্ট্রাকচারে পয়েন্টার চেজিং
যদিও 2D ম্যাট্রিক্স বেঞ্চমার্ক সংলগ্ন নেটিভ অ্যারেগুলিতে স্থানিক স্থানীয়তা প্রদর্শন করে, বেশিরভাগ অ্যান্ড্রয়েড অ্যাপ্লিকেশন এবং ফ্রেমওয়ার্ক কোড জাভা এবং কোটলিনে লেখা হয়। ম্যানেজড ল্যাঙ্গুয়েজগুলিতে, অবজেক্ট ভেরিয়েবল এবং কালেকশন এলিমেন্টগুলি ইনলাইনে অবজেক্ট সংরক্ষণ করে না; তারা ART হিপ জুড়ে ছড়িয়ে থাকা হিপ-অ্যালোকেটেড অবজেক্টগুলির রেফারেন্স (পয়েন্টার) সংরক্ষণ করে।
নেস্টেড রেফারেন্স গ্রাফের খরচ
অ্যান্ড্রয়েড অ্যাপ এবং সিস্টেম পরিষেবাগুলিতে ব্যবহৃত একটি সাধারণ প্যাটার্ন বিবেচনা করুন: স্টেট অবজেক্টের একটি ArrayList এর মতো নেস্টেড কালেকশনগুলি ট্র্যাভার্স করা, যার প্রতিটিতে লিসেনার বা কানেকশনের একটি ArrayMap বা ArraySet থাকে, এবং প্রতিটিই অন্য একটি স্টেট রেকর্ডকে নির্দেশ করে।
যদিও ArrayList , ArrayMap , এবং ArraySet তাদের অভ্যন্তরীণ Object[] অ্যারেগুলিকে অবিচ্ছিন্নভাবে সংরক্ষণ করে, তবুও সেই Object[] এর প্রতিটি উপাদানই একটি হিপ রেফারেন্স। process.services.valueAt(i).connections.valueAt(j).client এর মতো একটি চেইনকে ডিরেফারেন্স করতে পাঁচটি ক্রমিক নির্ভরশীল মেমরি লোডের প্রয়োজন হয়:
-
Object[]ব্যাকএন্ডservicesলোড করুন। -
ServiceRecordঅবজেক্টের হেডার এবং ফিল্ডগুলো লোড করুন। -
Object[]ব্যাকিংconnectionsলোড করুন। -
ConnectionRecordঅবজেক্টটি লোড করুন। - লক্ষ্য
ProcessRecordফিল্ডটি লোড করুন।
যেহেতু প্রতিটি লোডের মেমরি অ্যাড্রেস পূর্ববর্তী লোড থেকে প্রাপ্ত মানের উপর নির্ভর করে, তাই সিপিইউ-এর আউট-অফ-অর্ডার এক্সিকিউশন ইঞ্জিন এবং হার্ডওয়্যার প্রিফেচার সেগুলোকে ওভারল্যাপ করতে পারে না। যদি সেই অবজেক্টগুলো ভিন্ন ভিন্ন সময়ে অ্যালোকেট করা হতো অথবা গার্বেজ কালেকশনের সময় ভিন্ন ভিন্ন অঞ্চলে স্থানান্তরিত করা হতো, তাহলে প্রতিটি হপে L1 বা L2 ক্যাশে মিস হওয়ার ঝুঁকি থাকে।
বক্সড প্রিমিটিভ ( ArrayList<Integer> , HashMap<Long, Boolean> ) এবং জেনেরিক ল্যাম্বডা এই ওভারহেডকে আরও বাড়িয়ে তোলে: প্রতিটি এলিমেন্ট খোঁজার জন্য ভ্যালুটিকে আনবক্স করতে একটি অতিরিক্ত পয়েন্টার ডিরেফারেন্সের প্রয়োজন হয়, এবং জেনেরিক Consumer<T> কলব্যাকগুলো রানটাইম টাইপ-চেক ( CheckCast ) স্টাব যুক্ত করে যা ইন্সট্রাকশন ক্যাশে ( L1-icache ) এর উপর চাপ সৃষ্টি করে।
simpleperf ব্যবহার করে পয়েন্টার চেজিং নির্ণয় করা
বাস্তব-জগতের জাভা এবং কোটলিন ওয়ার্কলোডগুলিতে (যেমন system_server এর OomAdjuster যখন প্রসেস, সার্ভিস এবং প্রোভাইডার রেফারেন্স গ্রাফ ট্র্যাভার্স করে), পয়েন্টার চেজিং খুব কমই একটি সিন্থেটিক ২৫৬ এমবি কলাম-মেজর স্ক্যানের মতো IPC-কে একেবারে ০.১৬ পর্যন্ত নামিয়ে আনে, কারণ ওয়ার্কিং সেটের একটি অংশ L2 বা L3 ক্যাশে এঁটে যায়। এর পরিবর্তে, simpleperf এ এই বৈশিষ্ট্যসূচক সিগনেচারটি খুঁজুন:
- নিম্ন IPC (প্রায় ০.৬ থেকে ০.৯) : সিপিইউ-এর সুপারস্কেলার রিটায়ার উইডথের চেয়ে অনেক কম।
- উচ্চ ব্যাকএন্ড মেমোরি স্টল (
raw-stall-backend-mem) : প্রায়শই সমস্ত সিপিইউ সাইকেলের ৩৫% থেকে ৪৫% ডেটা ক্যাশে পূরণের জন্য অপেক্ষা করতে ব্যয় হয়। - উচ্চ
L1-dcache-load-missesএবংL1-icache-load-misses: যখন হট ট্র্যাভার্সাল লুপ ভার্চুয়াল মেথড এবং জেনেরিক ল্যাম্বডা স্টাব অতিক্রম করে, তখন ডেটা ক্যাশে মিসের উচ্চ হারের সাথে ইন্সট্রাকশন ক্যাশে মিসও দেখা যায়।
আপনি simpleperf stat ব্যবহার করে একটি চলমান প্রসেসের এই কাউন্টারগুলি পরিমাপ করতে পারেন:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
ম্যানেজড কোডে স্থানীয়তা উন্নত করা
- বক্সড কালেকশনের পরিবর্তে প্রিমিটিভ অ্যারে বা AndroidX কালেকশন ব্যবহার করুন : র্যাপার অবজেক্ট বাদ দিতে এবং একটিমাত্র অ্যারে অ্যালোকেশনের মধ্যে ভ্যালুগুলোকে সংলগ্ন রাখতে
IntArray,LongArray,SparseIntArrayবাandroidx.collectionপ্রিমিটিভ (IntList,LongLongMap,ScatterMap) ব্যবহার করুন। - হট ট্র্যাভার্সাল পাথ ফ্ল্যাট করুন : যদি কোনো হট লুপ একটিমাত্র বুলিয়ান বা ইন্টিজার ফ্ল্যাগ পড়ার জন্য কোনো অবজেক্ট গ্রাফ জুড়ে বারবার তিন বা চার হপ অতিক্রম করে, তবে সেই স্টেটটিকে একটি ডেন্স আইডি দ্বারা ইনডেক্স করা ফ্ল্যাট অ্যারে বা বিটমাস্কে হোইস্ট বা ক্যাশ করুন।
- সংকীর্ণ অভ্যন্তরীণ লুপে ক্যাপচারিং বা জেনেরিক ল্যাম্বডা ব্যবহার করা থেকে বিরত থাকুন : ইটারেটর অ্যালোকেশন, মেগামরফিক ডিসপ্যাচ এবং রানটাইম টাইপ-চেক ওভারহেড এড়াতে
forEachবা ইটারেটর চেইনের পরিবর্তেRandomAccessলিস্টের ওপর স্ট্যান্ডার্ড ইনডেক্সডforলুপ ব্যবহার করুন।
← থ্রেড | ↑ উপরে | সার্ভিস বাইন্ডিং →
,যদিও মেমরিকে প্রায়শই একটি একক, অভিন্ন স্টোরেজ পুল হিসাবে ভাবা হয়, এর ভৌত গঠন এবং সিপিইউ যেভাবে এটি অ্যাক্সেস করে, তা অ্যাপ্লিকেশনের পারফরম্যান্সের উপর গভীর প্রভাব ফেলে। সিপিইউ-এর ক্যাশ হায়ারার্কির কার্যকর ব্যবহার করে এমন উচ্চ-পারফরম্যান্স কোড লেখার জন্য মেমরি লোকালিটি বোঝা অত্যন্ত গুরুত্বপূর্ণ।
সিপিইউ ক্যাশে শ্রেণিবিন্যাস
একটি আধুনিক মোবাইল সিপিইউ সিস্টেমের প্রধান র্যাম (ডিআরএএম) থেকে অনেক বেশি দ্রুত। পারফরম্যান্সের এই ব্যবধান পূরণ করতে, সিপিইউগুলো ক্যাশ নামক বিভিন্ন স্তরের ক্ষুদ্র ও অত্যন্ত দ্রুতগতির মেমরি ব্যবহার করে।
- L1 ক্যাশে (লেভেল 1) : সবচেয়ে ছোট এবং দ্রুততম (~1ns)। একটি 3GHz সিপিইউতে, এটি প্রায় 3 ক্লক সাইকেলের সমান।
- L2 ক্যাশে (লেভেল ২) : আকারে বড় এবং কিছুটা ধীরগতির (~৩-৫ ন্যানোসেকেন্ড, বা ~১০-১৫ সাইকেল)।
- L3 ক্যাশে (লেভেল ৩) : সবচেয়ে বড় ক্যাশে (~১০-২০ ন্যানোসেকেন্ড, বা ~৩০-৬০ সাইকেল)।
- প্রধান মেমরি (DRAM) : সবচেয়ে বড় এবং সবচেয়ে ধীরগতির (~১০০ ন্যানোসেকেন্ড+, বা ~৩০০+ সাইকেল)।
বিলম্বের প্রেক্ষাপট: স্থবিরতার খরচ
এই সংখ্যাগুলোর প্রভাব বোঝার জন্য, একটি আধুনিক সুপারস্কেলার সিপিইউ-এর কথা বিবেচনা করুন যা প্রতি ক্লক সাইকেলে ৪ থেকে ৮টি ইনস্ট্রাকশন সম্পন্ন করতে পারে।
যদি সিপিইউ সমস্ত ক্যাশে খুঁজে না পায় এবং ডিআরএএম রিডের জন্য ১০০ ন্যানোসেকেন্ড (৩০০ সাইকেল) অপেক্ষা করতে হয়:
- হারানো সাইকেল : ~৩০০ সাইকেল।
- "ব্যর্থ" নির্দেশাবলী : ১,২০০ থেকে ২,৪০০টি নির্দেশাবলী , যেগুলো কার্যকর করা যেত যদি ডেটা আগে থেকেই কোনো লোকাল রেজিস্টার বা L1 ক্যাশে থাকত।
যখন আপনার কোডের মেমোরি লোকালিটি দুর্বল থাকে, তখন সিপিইউ যে সবসময় জটিল গাণিতিক কাজে ব্যস্ত থাকে, এমনটা নয়; বরং এটি প্রায়শই "থেমে" যায় এবং মেমোরি সাবসিস্টেমের জন্য অপেক্ষা করতে গিয়ে হাজার হাজার ইন্সট্রাকশন-ইকুইভ্যালেন্ট পর্যন্ত নিষ্ক্রিয়ভাবে বসে থাকে।
প্রতি চক্রে নির্দেশাবলী (IPC)
এই দক্ষতা পরিমাপের একটি প্রধান মেট্রিক হলো ইনস্ট্রাকশনস পার সাইকেল (IPC) । IPC নির্দেশ করে যে, সিপিইউ প্রতিটি ক্লক সাইকেলে গড়ে কতগুলো ইনস্ট্রাকশন সফলভাবে "রিটায়ার" (সম্পূর্ণ) করে।
- উচ্চ আইপিসি (যেমন, ৩.০ - ৫.০) : সিপিইউ উচ্চ দক্ষতার সাথে কাজ করছে এবং সম্ভবত এর বেশিরভাগ ডেটা L1/L2 ক্যাশে বা রেজিস্টার থেকে সংগ্রহ করছে।
- নিম্ন আইপিসি (যেমন, < ০.৫) : সিপিইউ মারাত্মকভাবে বাধাগ্রস্ত হচ্ছে। সিস্টেম মনিটরে সিপিইউ-এর "ব্যবহার" ১০০% দেখালেও, এটি আসলে বেশিরভাগ সময় মেমোরির জন্য অপেক্ষা করতে ব্যয় করে—এই অবস্থাকে মেমোরি স্টল বলা হয়।
মেমরি লোকালিটিই হলো প্রধান নিয়ামক যা নির্ধারণ করে যে একটি ডেটা-ইনটেনসিভ লুপ উচ্চ আইপিসি-তে চলবে, নাকি একাধিক স্টলে পর্যবসিত হবে।
ক্যাশ লাইন
সিপিইউ মেমরি থেকে একক বাইট লোড করে না। এর পরিবর্তে, এটি ক্যাশ লাইন নামক নির্দিষ্ট আকারের ব্লক লোড করে, যা সাধারণত ৬৪ বাইটের হয়ে থাকে। যখন আপনি একটি একক ভেরিয়েবল অ্যাক্সেস করেন, তখন সিপিইউ সেটিকে ধারণকারী সম্পূর্ণ ৬৪-বাইটের অংশটি ক্যাশে নিয়ে আসে।
TLB (অনুবাদ লুকসাইড বাফার)
অ্যান্ড্রয়েড ভার্চুয়াল মেমরি ব্যবহার করে। প্রতিটি মেমরি অ্যাক্সেসের জন্য একটি ভার্চুয়াল অ্যাড্রেসকে ফিজিক্যাল অ্যাড্রেসে রূপান্তর করতে হয়। TLB হলো একটি বিশেষায়িত ক্যাশে যা সাম্প্রতিক রূপান্তরগুলো সংরক্ষণ করে। TLB মিস হলে কার্নেলকে মেইন মেমরির পেজ টেবিলগুলো ওয়াক করতে হয়, যা TLB হিটের তুলনায় একটি অপেক্ষাকৃত ব্যয়বহুল অপারেশন।
হার্ডওয়্যার প্রোফাইল: পিক্সেল ১০ প্রো ফোল্ড
নিম্নলিখিত অনুশীলনগুলোর জন্য আমরা একটি পিক্সেল ১০ প্রো ফোল্ড হার্ডওয়্যার ডিভাইস ব্যবহার করেছি। এই ডিভাইসটিতে গুগল টেনসর জি৫ এসওসি রয়েছে।
হার্ডওয়্যারকে জিজ্ঞাসাবাদ করা
মেমরি সাবসিস্টেমটি বোঝার জন্য, আমরা প্রথমে সিপিইউ কনফিগারেশন এবং ক্যাশ প্যারামিটারগুলো পরীক্ষা করি।
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
সিপিইউ অংশগুলি ডিকোড করা
/proc/cpuinfo তে থাকা CPU part মানগুলো হলো ARM CPU কোরগুলোর হেক্সাডেসিমাল শনাক্তকারী। Pixel 10 Pro Fold-এ থাকা Laguna SoC-এর ক্ষেত্রে, এগুলোর মান হলো:
-
0xd8b: এআরএম কর্টেক্স-এ৫২০ (দক্ষতা কোর) -
0xd90: এআরএম কর্টেক্স-এ৭২০ (পারফরম্যান্স কোর) -
0xd8c: এআরএম কর্টেক্স-এক্স৪ (প্রাইম কোর)
এই ৪+৩+১ কনফিগারেশনটি আধুনিক মোবাইল এসওসি-গুলোতে প্রচলিত, যেখানে বিভিন্ন ক্লাস্টারের ক্যাশ সাইজ এবং ল্যাটেন্সি ভিন্ন হতে পারে।
এলাকার প্রকারভেদ
কার্যকরী সফ্টওয়্যার ডিজাইন প্রধানত দুই ধরনের স্থানীয়তার উপর নির্ভর করে:
- স্থানিক নৈকট্য (Spatial Locality) : যদি কোনো মেমোরি লোকেশন অ্যাক্সেস করা হয়, তাহলে কাছাকাছি থাকা মেমোরি লোকেশনগুলোও শীঘ্রই অ্যাক্সেস হওয়ার সম্ভাবনা থাকে। ক্রমানুসারে অ্যারে ট্রাভার্সাল এর একটি উৎকৃষ্ট উদাহরণ। যেহেতু সিপিইউ একটি সম্পূর্ণ ক্যাশ লাইন লোড করে, তাই কোনো অ্যারের পরবর্তী এলিমেন্ট যদি আগে থেকেই ক্যাশ লাইনে থাকে, তবে সেটি অ্যাক্সেস করা প্রায় "বিনামূল্যে" হয়ে যায়।
- টেম্পোরাল লোকালিটি : যদি কোনো মেমোরি লোকেশন অ্যাক্সেস করা হয়, তাহলে শীঘ্রই সেই একই লোকেশন আবার অ্যাক্সেস করার সম্ভাবনা থাকে। ভালো অ্যালগরিদমগুলো ক্যাশে থাকা অবস্থায়ই ডেটা পুনরায় ব্যবহার করে।
হাতে-কলমে অনুশীলন: সিম্পলপার্ফ দিয়ে অবস্থান পরিমাপ
এই অনুশীলনীতে, আমরা একটি ২৫৬ মেগাবাইট ম্যাট্রিক্সের দুটি ভিন্ন ট্রাভার্সাল চালানোর সময় হার্ডওয়্যার পারফরম্যান্স কাউন্টারগুলো নিরীক্ষণ করতে simpleperf ব্যবহার করব।
- রো-মেজর ট্রাভার্সাল : এটি ম্যাট্রিক্সের উপাদানগুলোকে মেমরিতে সংরক্ষিত ক্রমানুসারে অ্যাক্সেস করে। এটি ক্যাশ-বান্ধব এবং স্পেশিয়াল লোকালিটির সুবিধা গ্রহণ করে।
- কলাম-মেজর ট্র্যাভার্সাল : এটি কলাম অনুসারে এলিমেন্ট অ্যাক্সেস করার জন্য মেমোরি জুড়ে লাফিয়ে লাফিয়ে যায়। এর ফলে প্রায়শই ক্যাশে এবং টিএলবি (TLB) বাদ পড়ে যায়, যা সিপিইউকে স্টল করতে বাধ্য করে।
১. সিম্পলপার্ফ দিয়ে চালান
বাইনারিটি পুশ করুন, এটি এক্সিকিউটেবল কিনা তা নিশ্চিত করুন, এবং ক্যাশে ও টিএলবি ইভেন্ট পরিমাপ করতে simpleperf stat ব্যবহার করুন। ইউজারস্পেসে ইভেন্ট পরিমাপ করার জন্য আমরা :u সাফিক্সটি ব্যবহার করি। বেশিরভাগ ডিভাইসে হার্ডওয়্যার পিএমইউ কাউন্টার অ্যাক্সেস করার জন্য এই কমান্ডগুলো চালাতে adb root প্রয়োজন হয়।
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
প্রোফাইল সারি-প্রধান:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
প্রোফাইল কলাম-প্রধান:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
২. নমুনা পরিমাপ (পিক্সেল ১০ প্রো ফোল্ড)
নিম্নলিখিত ফলাফলগুলো একটি পিক্সেল ১০ প্রো ফোল্ড হার্ডওয়্যার ডিভাইসে পরিমাপ করা হয়েছে:
| মেট্রিক | রো-মেজর (বন্ধুত্বপূর্ণ) | কলাম-মেজর (অবন্ধুসুলভ) | পার্থক্য |
|---|---|---|---|
| কার্যকর করার সময় | ০.৮৩ সেকেন্ড | ৬৮.৩ সেকেন্ড | ~৮২ গুণ ধীর |
| নির্দেশাবলী | ৫.২৭ বিলিয়ন | ১০.২০ বিলিয়ন | ~১.৯ গুণ বেশি |
| সিপিইউ সাইকেল | ১.২০ বিলিয়ন | ৬২.১৮ বিলিয়ন | ~৫২ গুণ বেশি |
| প্রতি চক্রে নির্দেশাবলী (IPC) | ৪.৪০ | ০.১৬ | ২৭ গুণ কম দক্ষতা |
| L1 ডেটা ক্যাশে মিস | ২১০ মিলিয়ন | ৩,৩৬৯ মিলিয়ন | ১৬ গুণ বেশি মিস |
| dTLB লোড মিস | ০.১৩ মিলিয়ন | ২,৮৮৮ মিলিয়ন | ২২,০০০ গুণ বেশি ভুল |
৩. ফলাফলের বিশ্লেষণ
- আইপিসি ক্র্যাশ : রো-মেজর টেস্টে, সিপিইউ ৪.৪০-এর একটি আইপিসি অর্জন করে, যা নির্দেশ করে যে এটি প্রতি সাইকেলে একাধিক নির্দেশনা দক্ষতার সাথে সম্পাদন করছে। কলাম-মেজর টেস্টে, আইপিসি কমে ০.১৬-তে নেমে আসে। এর অর্থ হলো, সিপিইউ ৯৬% সময় ডিআরএএম থেকে ডেটা আসার অপেক্ষায় আটকে থাকে।
- TLB প্রতিবন্ধকতা : সবচেয়ে বড় পার্থক্যটি হলো dTLB-লোড-মিস-এর ক্ষেত্রে। অনুক্রমিক অ্যাক্সেস (রো-মেজর) একই মেমরি পেজের মধ্যেই সীমাবদ্ধ থাকে, ফলে TLB মিস খুব কম হয়। কলাম জুড়ে লাফিয়ে লাফিয়ে যাওয়া (কলাম-মেজর) সিপিইউকে ক্রমাগত নতুন পেজ রেফারেন্স করতে বাধ্য করে, যা TLB-কে ভারাক্রান্ত করে এবং ব্যয়বহুল পেজ টেবিল ওয়াক করতে বাধ্য করে।
- ক্যাশ দক্ষতা : কলাম-মেজর ট্র্যাভার্সালের ফলে ১৬ গুণ বেশি L1 ক্যাশ মিস হয়, যা সিপিইউকে ক্রমাগত অনেক ধীরগতির L3 বা DRAM থেকে ডেটা আনতে বাধ্য করে।
পর্যবেক্ষণ: যদিও উভয় ট্র্যাভার্সালই একই ডেটার উপর একই লজিক্যাল অপারেশন সম্পাদন করেছিল, কলাম-মেজর ট্র্যাভার্সালটি ৮০ গুণেরও বেশি ধীর ছিল। এই বিশাল পার্থক্যটি সম্পূর্ণরূপে সিপিইউ-এর মেমরি সাবসিস্টেমের ভৌত বাস্তবতার সাথে অ্যাক্সেস প্যাটার্নের মিথস্ক্রিয়ার কারণে ঘটে।
জাভা এবং কোটলিন ডেটা স্ট্রাকচারে পয়েন্টার চেজিং
যদিও 2D ম্যাট্রিক্স বেঞ্চমার্ক সংলগ্ন নেটিভ অ্যারেগুলিতে স্থানিক স্থানীয়তা প্রদর্শন করে, বেশিরভাগ অ্যান্ড্রয়েড অ্যাপ্লিকেশন এবং ফ্রেমওয়ার্ক কোড জাভা এবং কোটলিনে লেখা হয়। ম্যানেজড ল্যাঙ্গুয়েজগুলিতে, অবজেক্ট ভেরিয়েবল এবং কালেকশন এলিমেন্টগুলি ইনলাইনে অবজেক্ট সংরক্ষণ করে না; তারা ART হিপ জুড়ে ছড়িয়ে থাকা হিপ-অ্যালোকেটেড অবজেক্টগুলির রেফারেন্স (পয়েন্টার) সংরক্ষণ করে।
নেস্টেড রেফারেন্স গ্রাফের খরচ
অ্যান্ড্রয়েড অ্যাপ এবং সিস্টেম পরিষেবাগুলিতে ব্যবহৃত একটি সাধারণ প্যাটার্ন বিবেচনা করুন: স্টেট অবজেক্টের একটি ArrayList এর মতো নেস্টেড কালেকশনগুলি ট্র্যাভার্স করা, যার প্রতিটিতে লিসেনার বা কানেকশনের একটি ArrayMap বা ArraySet থাকে, এবং প্রতিটিই অন্য একটি স্টেট রেকর্ডকে নির্দেশ করে।
যদিও ArrayList , ArrayMap , এবং ArraySet তাদের অভ্যন্তরীণ Object[] অ্যারেগুলিকে অবিচ্ছিন্নভাবে সংরক্ষণ করে, তবুও সেই Object[] এর প্রতিটি উপাদানই একটি হিপ রেফারেন্স। process.services.valueAt(i).connections.valueAt(j).client এর মতো একটি চেইনকে ডিরেফারেন্স করতে পাঁচটি ক্রমিক নির্ভরশীল মেমরি লোডের প্রয়োজন হয়:
-
Object[]ব্যাকএন্ডservicesলোড করুন। -
ServiceRecordঅবজেক্টের হেডার এবং ফিল্ডগুলো লোড করুন। -
Object[]ব্যাকিংconnectionsলোড করুন। -
ConnectionRecordঅবজেক্টটি লোড করুন। - লক্ষ্য
ProcessRecordফিল্ডটি লোড করুন।
যেহেতু প্রতিটি লোডের মেমরি অ্যাড্রেস পূর্ববর্তী লোড থেকে প্রাপ্ত মানের উপর নির্ভর করে, তাই সিপিইউ-এর আউট-অফ-অর্ডার এক্সিকিউশন ইঞ্জিন এবং হার্ডওয়্যার প্রিফেচার সেগুলোকে ওভারল্যাপ করতে পারে না। যদি সেই অবজেক্টগুলো ভিন্ন ভিন্ন সময়ে অ্যালোকেট করা হতো অথবা গার্বেজ কালেকশনের সময় ভিন্ন ভিন্ন অঞ্চলে স্থানান্তরিত করা হতো, তাহলে প্রতিটি হপে L1 বা L2 ক্যাশে মিস হওয়ার ঝুঁকি থাকে।
বক্সড প্রিমিটিভ ( ArrayList<Integer> , HashMap<Long, Boolean> ) এবং জেনেরিক ল্যাম্বডা এই ওভারহেডকে আরও বাড়িয়ে তোলে: প্রতিটি এলিমেন্ট খোঁজার জন্য ভ্যালুটিকে আনবক্স করতে একটি অতিরিক্ত পয়েন্টার ডিরেফারেন্সের প্রয়োজন হয়, এবং জেনেরিক Consumer<T> কলব্যাকগুলো রানটাইম টাইপ-চেক ( CheckCast ) স্টাব যুক্ত করে যা ইন্সট্রাকশন ক্যাশে ( L1-icache ) এর উপর চাপ সৃষ্টি করে।
simpleperf ব্যবহার করে পয়েন্টার চেজিং নির্ণয় করা
বাস্তব-জগতের জাভা এবং কোটলিন ওয়ার্কলোডগুলিতে (যেমন system_server এর OomAdjuster যখন প্রসেস, সার্ভিস এবং প্রোভাইডার রেফারেন্স গ্রাফ ট্র্যাভার্স করে), পয়েন্টার চেজিং খুব কমই একটি সিন্থেটিক ২৫৬ এমবি কলাম-মেজর স্ক্যানের মতো IPC-কে একেবারে ০.১৬ পর্যন্ত নামিয়ে আনে, কারণ ওয়ার্কিং সেটের একটি অংশ L2 বা L3 ক্যাশে এঁটে যায়। এর পরিবর্তে, simpleperf এ এই বৈশিষ্ট্যসূচক সিগনেচারটি খুঁজুন:
- নিম্ন IPC (প্রায় ০.৬ থেকে ০.৯) : সিপিইউ-এর সুপারস্কেলার রিটায়ার উইডথের চেয়ে অনেক কম।
- উচ্চ ব্যাকএন্ড মেমোরি স্টল (
raw-stall-backend-mem) : প্রায়শই সমস্ত সিপিইউ সাইকেলের ৩৫% থেকে ৪৫% ডেটা ক্যাশে পূরণের জন্য অপেক্ষা করতে ব্যয় হয়। - উচ্চ
L1-dcache-load-missesএবংL1-icache-load-misses: যখন হট ট্র্যাভার্সাল লুপ ভার্চুয়াল মেথড এবং জেনেরিক ল্যাম্বডা স্টাব অতিক্রম করে, তখন ডেটা ক্যাশে মিসের উচ্চ হারের সাথে ইন্সট্রাকশন ক্যাশে মিসও দেখা যায়।
আপনি simpleperf stat ব্যবহার করে একটি চলমান প্রসেসের এই কাউন্টারগুলি পরিমাপ করতে পারেন:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
ম্যানেজড কোডে স্থানীয়তা উন্নত করা
- বক্সড কালেকশনের পরিবর্তে প্রিমিটিভ অ্যারে বা AndroidX কালেকশন ব্যবহার করুন : র্যাপার অবজেক্ট বাদ দিতে এবং একটিমাত্র অ্যারে অ্যালোকেশনের মধ্যে ভ্যালুগুলোকে সংলগ্ন রাখতে
IntArray,LongArray,SparseIntArrayবাandroidx.collectionপ্রিমিটিভ (IntList,LongLongMap,ScatterMap) ব্যবহার করুন। - হট ট্র্যাভার্সাল পাথ ফ্ল্যাট করুন : যদি কোনো হট লুপ একটিমাত্র বুলিয়ান বা ইন্টিজার ফ্ল্যাগ পড়ার জন্য কোনো অবজেক্ট গ্রাফ জুড়ে বারবার তিন বা চার হপ অতিক্রম করে, তবে সেই স্টেটটিকে একটি ডেন্স আইডি দ্বারা ইনডেক্স করা ফ্ল্যাট অ্যারে বা বিটমাস্কে হোইস্ট বা ক্যাশ করুন।
- সংকীর্ণ অভ্যন্তরীণ লুপে ক্যাপচারিং বা জেনেরিক ল্যাম্বডা ব্যবহার করা থেকে বিরত থাকুন : ইটারেটর অ্যালোকেশন, মেগামরফিক ডিসপ্যাচ এবং রানটাইম টাইপ-চেক ওভারহেড এড়াতে
forEachবা ইটারেটর চেইনের পরিবর্তেRandomAccessলিস্টের ওপর স্ট্যান্ডার্ড ইনডেক্সডforলুপ ব্যবহার করুন।
← থ্রেড | ↑ উপরে | সার্ভিস বাইন্ডিং →