

Bien que la mémoire soit souvent considérée comme un pool de stockage unique et uniforme, son organisation physique et la façon dont le processeur y accède ont un impact profond sur les performances des applications. Pour écrire du code performant qui utilise efficacement la hiérarchie du cache du processeur, il est essentiel de comprendre la localité de la mémoire.
Hiérarchie du cache du processeur
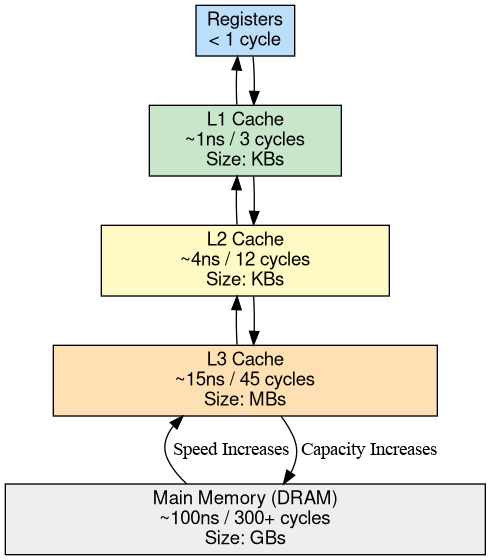
Un processeur mobile moderne est beaucoup plus rapide que la RAM principale (DRAM) du système. Pour combler ce manque de performances, les processeurs utilisent plusieurs niveaux de mémoire petite et extrêmement rapide appelée cache.
- Cache L1 (niveau 1) : le plus petit et le plus rapide (~1 ns). Sur un processeur de 3 GHz, cela représente environ trois cycles d'horloge.
- Cache L2 (niveau 2) : plus grand et légèrement plus lent (~3 à 5 ns, soit ~10 à 15 cycles).
- Cache L3 (niveau 3) : le plus grand cache (~10 à 20 ns, soit ~30 à 60 cycles).
- Mémoire principale (DRAM) : la plus grande et la plus lente (~100 ns ou ~300 cycles et plus).
Contextualiser la latence : le coût d'un blocage
Pour comprendre l'impact de ces chiffres, prenons l'exemple d'un CPU superscalaire moderne qui peut retirer 4 à 8 instructions par cycle d'horloge.
Si le processeur manque tous les caches et doit attendre 100 ns (300 cycles) pour une lecture DRAM :
- Cycles perdus : environ 300 cycles.
- Instructions "gaspillées" : entre 1 200 et 2 400 instructions qui auraient pu être exécutées si les données se trouvaient déjà dans un registre local ou dans le cache L1.
Lorsque votre code présente une mauvaise localité de mémoire, le processeur n'est pas nécessairement occupé par des calculs complexes. Il est souvent "bloqué", c'est-à-dire qu'il reste inactif pendant des milliers d'équivalents d'instructions en attendant le sous-système de mémoire.
Instructions par cycle (IPC)
L'une des principales métriques permettant de mesurer cette efficacité est le nombre d'instructions par cycle (IPC). L'IPC représente le nombre d'instructions que le processeur "retire" (exécute) en moyenne à chaque cycle d'horloge.
- IPC élevé (par exemple, entre 3.0 et 5.0) : le processeur fonctionne avec une efficacité élevée et trouve probablement la plupart de ses données dans les caches ou les registres L1/L2.
- IPC faible (par exemple, < 0,5) : le processeur est fortement limité. Même si le processeur est utilisé à 100 % dans les moniteurs système, il passe en réalité la plupart de son temps à attendre la mémoire, un état connu sous le nom de blocage de la mémoire.
La localité de la mémoire est le principal facteur qui détermine si une boucle à forte intensité de données s'exécute à un IPC élevé ou s'effondre en une série d'arrêts.
Lignes de cache
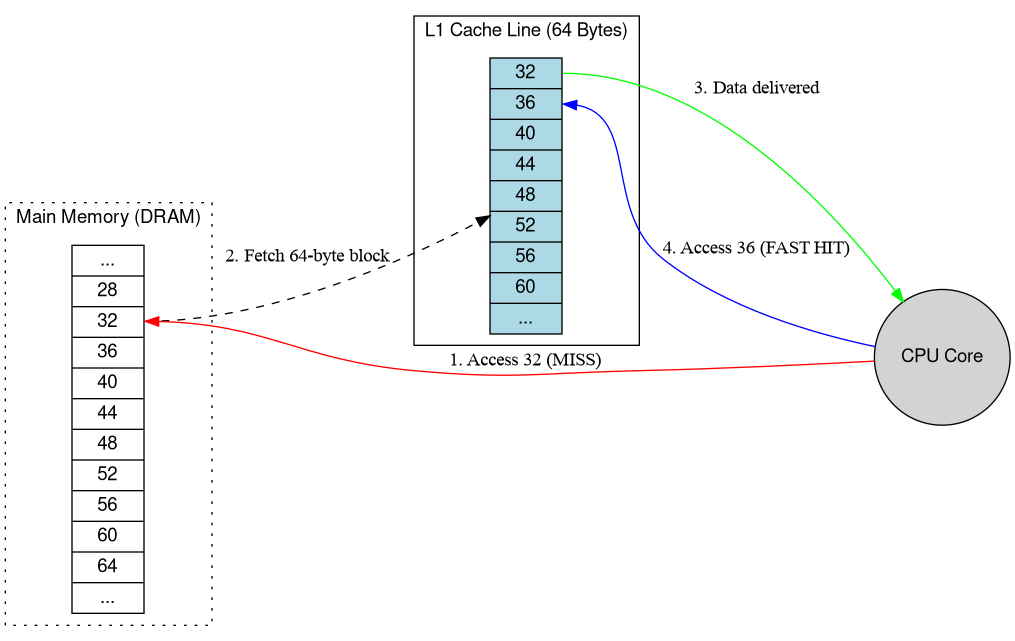
Les processeurs ne chargent pas des octets individuels à partir de la mémoire. Au lieu de cela, ils chargent des blocs de taille fixe appelés lignes de cache, qui font généralement 64 octets. Lorsque vous accédez à une seule variable, le processeur récupère dans le cache l'intégralité du bloc de 64 octets qui la contient.
TLB (tampon de traduction)
Android utilise la mémoire virtuelle. Chaque accès à la mémoire nécessite la traduction d'une adresse virtuelle en adresse physique. La TLB est un cache spécialisé qui stocke les traductions récentes. Un défaut de TLB oblige le noyau à parcourir les tables de pages dans la mémoire principale, ce qui est une opération relativement coûteuse par rapport à un succès de TLB.
Profil matériel : Pixel 10 Pro Fold
Pour les exercices suivants, nous avons utilisé un appareil Pixel 10 Pro Fold. Cet appareil est équipé d'un SoC Google Tensor G5.
Interroger le matériel
Pour comprendre le sous-système de mémoire, nous examinons d'abord la configuration du processeur et les paramètres du cache.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
Décoder les parties du processeur
Les valeurs CPU part dans /proc/cpuinfo sont des identifiants hexadécimaux pour les cœurs de processeur ARM. Pour le SoC Laguna du Pixel 10 Pro Fold, cela correspond à :
0xd8b: ARM Cortex-A520 (cœurs à faible consommation)0xd90: ARM Cortex-A720 (cœurs de performances)0xd8c: ARM Cortex-X4 (cœur principal)
Cette configuration 4+3+1 est courante dans les SoC mobiles modernes, où différents clusters peuvent avoir des tailles et des latences de cache différentes.
Types de localité
Une conception logicielle efficace repose sur deux principaux types de localité :
- Localité spatiale : si un emplacement mémoire est consulté, il est probable que les emplacements mémoire à proximité le soient bientôt. La traversée séquentielle de tableaux est l'exemple classique. Étant donné que le processeur charge une ligne de cache entière, l'accès à l'élément suivant d'un tableau est presque "sans frais" s'il se trouve déjà dans la ligne de cache.
- Localité temporelle : si une zone mémoire est consultée, il est probable que la même zone soit consultée à nouveau prochainement. Les bons algorithmes réutilisent les données tant qu'elles sont encore "chaudes" dans le cache.
Exercice pratique : mesurer la localité avec simpleperf
Dans cet exercice, nous allons utiliser simpleperf pour surveiller les compteurs de performances matérielles lors de l'exécution de deux traversées différentes d'une matrice de 256 Mo.
- Parcours par ligne : accède aux éléments de la matrice dans l'ordre dans lequel ils sont stockés en mémoire. Cette approche est compatible avec le cache et exploite la localité spatiale.
- Parcours par colonne : passe d'un emplacement mémoire à un autre pour accéder aux éléments par colonne. Cela manque fréquemment le cache et le TLB, ce qui force le processeur à s'arrêter.
1. Exécuter avec Simpleperf
Transférez le binaire, assurez-vous qu'il est exécutable et utilisez simpleperf stat pour mesurer les événements de cache et de TLB. Nous utilisons le suffixe :u pour mesurer les événements dans l'espace utilisateur.
Ces commandes nécessitent adb root pour accéder aux compteurs PMU matériels sur la plupart des appareils.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
Profil Row-major :
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
Profil : ordre des colonnes
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. Exemples de mesures (Pixel 10 Pro Fold)
Les résultats suivants ont été mesurés sur un appareil Pixel 10 Pro Fold :
| Métrique | Row-major (Friendly) | Ordre des colonnes (non convivial) | Différence |
|---|---|---|---|
| Durée d'exécution | 0,83 seconde | 68,3 secondes | ~82 fois plus lent |
| Instructions | 5,27 milliards | 10,20 milliards | ~1,9 fois plus |
| Cycles de processeur | 1,20 milliard | 62,18 milliards | ~52 fois plus |
| Instructions par cycle (IPC) | 4.40 | 0,16 | Efficacité 27 fois inférieure |
| Échecs du cache de données L1 | 210 millions | 3 369 millions | 16 fois plus d'échecs |
| Échecs de chargement dTLB | 0,13 million | 2 888 millions | 22 000 fois plus d'échecs |
3. Analyse des résultats
- L'IPC s'effondre : dans le test de l'ordre des lignes, le processeur atteint un IPC de 4,40, ce qui indique qu'il exécute efficacement plusieurs instructions par cycle. Dans le test de l'ordre des colonnes, le CPI tombe à 0,16. Cela signifie que le processeur est à l'arrêt 96% du temps, en attente de l'arrivée des données de la mémoire DRAM.
- Goulot d'étranglement du TLB : la différence la plus flagrante se trouve dans dTLB-load-misses. L'accès séquentiel (ordre des lignes) reste dans les mêmes pages mémoire, ce qui entraîne très peu de défauts TLB. Le fait de passer d'une colonne à l'autre (ordre des colonnes) oblige le processeur à référencer constamment de nouvelles pages, ce qui surcharge le TLB et force des parcours de table de pages coûteux.
- Efficacité du cache : la traversée par colonne génère 16 fois plus d'échecs de cache L1, ce qui oblige le processeur à récupérer constamment des données à partir du cache L3 ou de la mémoire DRAM, beaucoup plus lents.
Observation : Bien que les deux traversées aient effectué la même opération logique sur les mêmes données, la traversée par colonne était plus de 80 fois plus lente. Cette énorme différence est entièrement due à la façon dont le modèle d'accès interagit avec la réalité physique du sous-système de mémoire du processeur.
Chasse aux pointeurs dans les structures de données Java et Kotlin
Alors que le benchmark de matrice 2D démontre la localité spatiale dans les tableaux natifs contigus, la plupart du code d'application et de framework Android est écrit en Java et en Kotlin. Dans les langages gérés, les variables d'objet et les éléments de collection ne stockent pas les objets de manière intégrée. Ils stockent des références (pointeurs) vers des objets alloués au tas et répartis dans le tas ART.
Coût des graphiques de référence imbriqués
Prenons l'exemple d'un modèle courant dans les applications et services système Android : la traversée de collections imbriquées telles qu'un ArrayList d'objets d'état, chacun contenant un ArrayMap ou un ArraySet d'écouteurs ou de connexions, chacun pointant vers un autre enregistrement d'état.
Même si ArrayList, ArrayMap et ArraySet stockent leurs tableaux Object[] internes de manière contiguë, chaque élément de ce Object[] reste une référence de tas. La déréférence d'une chaîne telle que process.services.valueAt(i).connections.valueAt(j).client nécessite cinq chargements de mémoire dépendants séquentiels :
- Chargez le
Object[]de supportservices. - Chargez l'en-tête et les champs de l'objet
ServiceRecord. - Chargez le
Object[]de supportconnections. - Chargez l'objet
ConnectionRecord. - Chargez le champ cible
ProcessRecord.
Comme l'adresse mémoire de chaque chargement dépend de la valeur renvoyée par le chargement précédent, le moteur d'exécution dans le désordre et le préfetcher matériel du processeur ne peuvent pas les chevaucher. Si ces objets ont été alloués à des moments différents ou déplacés vers des régions différentes lors de la récupération de mémoire, chaque saut risque de provoquer un échec du cache L1 ou L2.
Les primitives boxed (ArrayList<Integer>, HashMap<Long, Boolean>) et les lambdas génériques aggravent ce problème : chaque recherche d'élément nécessite une déréférence de pointeur supplémentaire pour déboxer la valeur, et les rappels Consumer<T> génériques insèrent des stubs de vérification du type d'exécution (CheckCast) qui ajoutent une pression sur le cache d'instructions (L1-icache).
Diagnostiquer le suivi de pointeur avec simpleperf
Dans les charges de travail Java et Kotlin réelles (telles que le processus de parcours system_serverOomAdjuster, les graphes de référence de service et de fournisseur), la chasse aux pointeurs réduit rarement l'IPC jusqu'à 0,16 comme une analyse synthétique de 256 Mo en ordre de colonne, car une partie de l'ensemble de travail tient dans le cache L2 ou L3.
Recherchez plutôt cette signature caractéristique dans simpleperf :
- IPC faible (environ 0,6 à 0,9) : bien en dessous de la largeur de retrait superscalaire du processeur.
- Blocages de mémoire backend élevés (
raw-stall-backend-mem) : souvent, 35% à 45 % de tous les cycles de processeur sont consacrés à l'attente du remplissage du cache de données. L1-dcache-load-missesetL1-icache-load-missesélevés : taux élevés de cache miss de données associés à des cache miss d'instructions lorsque les boucles de parcours à chaud sautent par-dessus les méthodes virtuelles et les stubs lambda génériques.
Vous pouvez mesurer ces compteurs sur un processus en cours d'exécution à l'aide de simpleperf stat :
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
Améliorer la localité dans le code géré
- Remplacez les collections boxed par des tableaux primitifs ou des collections AndroidX : utilisez les primitives
IntArray,LongArray,SparseIntArrayouandroidx.collection(IntList,LongLongMap,ScatterMap) pour éliminer les objets wrapper et conserver les valeurs contiguës dans une seule allocation de tableau. - Aplatir les chemins de parcours actifs : si une boucle active parcourt à plusieurs reprises trois ou quatre sauts dans un graphique d'objets pour lire un seul indicateur booléen ou entier, hissez ou mettez en cache cet état dans un tableau plat ou un masque de bits indexé par un ID dense.
- Évitez de capturer des lambdas génériques dans des boucles internes serrées : utilisez des boucles
forindexées standards sur des listesRandomAccessau lieu de chaînes d'itérateursforEachou d'itérateurs pour éviter les allocations d'itérateurs, la répartition mégamorphe et la surcharge de vérification du type d'exécution.
← Threads | ↑ Haut | Liaisons de service →