

मेमोरी को अक्सर स्टोरेज का एक ही पूल माना जाता है. हालांकि, इसके फ़िज़िकल संगठन और सीपीयू के इसे ऐक्सेस करने के तरीके का, ऐप्लिकेशन की परफ़ॉर्मेंस पर काफ़ी असर पड़ता है. मेमोरी लोकैलिटी को समझना, ज़्यादा परफ़ॉर्मेंस वाले कोड को लिखने के लिए ज़रूरी है. इससे सीपीयू की कैश मेमोरी का बेहतर तरीके से इस्तेमाल किया जा सकता है.
सीपीयू कैश मेमोरी की हैरारकी
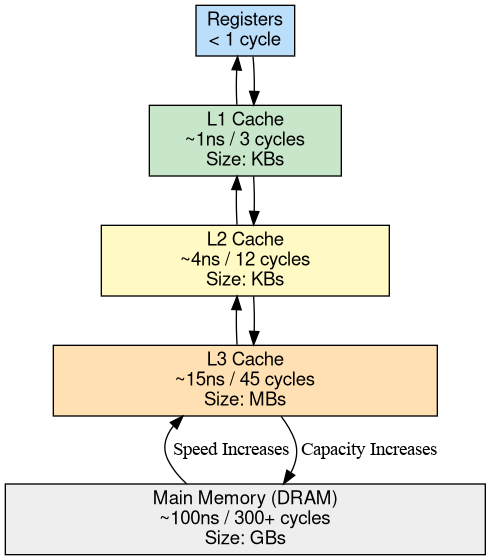
आजकल के मोबाइल सीपीयू, सिस्टम की मुख्य रैम (डीआरएएम) से ज़्यादा तेज़ होते हैं. परफ़ॉर्मेंस में इस अंतर को कम करने के लिए, सीपीयू कई लेवल की छोटी और बहुत तेज़ मेमोरी का इस्तेमाल करते हैं. इसे कैश मेमोरी कहा जाता है.
- L1 कैश मेमोरी (लेवल 1): यह सबसे छोटी और सबसे तेज़ (~1ns) होती है. 3 गीगाहर्ट्ज़ वाले सीपीयू पर, यह करीब तीन क्लॉक साइकल होती है.
- L2 कैश मेमोरी (लेवल 2): यह L1 कैश मेमोरी से बड़ी होती है और इसकी स्पीड थोड़ी कम होती है (~3-5ns या ~10-15 साइकल).
- L3 कैश मेमोरी (लेवल 3): यह सबसे बड़ी कैश मेमोरी होती है (~10-20 नैनोसेकंड या ~30-60 साइकल).
- मुख्य मेमोरी (डीआरएएम): यह सबसे बड़ी और सबसे धीमी (~100 नैनोसेकंड या ~300 से ज़्यादा साइकल) होती है.
लेटेंसी के बारे में जानकारी देना: स्टॉल की लागत
इन नंबरों के असर को समझने के लिए, एक आधुनिक सुपरस्केलर सीपीयू पर विचार करें. यह हर क्लॉक साइकल में चार से आठ निर्देशों को पूरा कर सकता है.
अगर सीपीयू को सभी कैश मेमोरी में डेटा नहीं मिलता है और उसे DRAM से डेटा पढ़ने के लिए 100 नैनोसेकंड (300 साइकल) तक इंतज़ार करना पड़ता है, तो:
- बैटरी की चार्जिंग क्षमता में गिरावट: ~300 साइकल.
- "Wasted" निर्देश: 1,200 से 2,400 निर्देश. अगर डेटा पहले से ही लोकल रजिस्टर या L1 कैश मेमोरी में होता, तो इन निर्देशों को लागू किया जा सकता था.
जब आपके कोड में मेमोरी लोकैलिटी की समस्या होती है, तो ज़रूरी नहीं कि सीपीयू जटिल गणितीय गणनाओं में व्यस्त हो. यह अक्सर "स्थगित" हो जाता है. मेमोरी सबसिस्टम का इंतज़ार करते समय, यह हज़ारों निर्देश-इक्विवेलेंट के लिए निष्क्रिय रहता है.
निर्देश प्रति साइकल (आईपीसी)
इस क्षमता को मेज़र करने के लिए, मुख्य मेट्रिक निर्देश प्रति साइकल (आईपीसी) है. आईपीसी से पता चलता है कि सीपीयू, हर क्लॉक साइकल के दौरान औसतन कितने निर्देशों को "रिटायर" (पूरा) करता है.
- ज़्यादा आईपीसी (जैसे, 3.0 - 5.0): सीपीयू ज़्यादा कुशलता से काम कर रहा है. ऐसा इसलिए हो रहा है, क्योंकि सीपीयू को ज़्यादातर डेटा, L1/L2 कैश या रजिस्टर में मिल रहा है.
- कम आईपीसी (जैसे, < 0.5): सीपीयू पर बहुत ज़्यादा लोड है. सिस्टम मॉनिटर में सीपीयू का "इस्तेमाल" 100% होने पर भी, सीपीयू का ज़्यादातर समय मेमोरी का इंतज़ार करने में बीतता है. इस स्थिति को मेमोरी स्टॉल कहा जाता है.
मेमोरी लोकैलिटी, मुख्य फ़ैक्टर है. इससे यह तय होता है कि डेटा इंटेंसिव लूप, ज़्यादा आईपीसी पर चलेगा या स्टॉल की सीरीज़ में बदल जाएगा.
कैश लाइनें
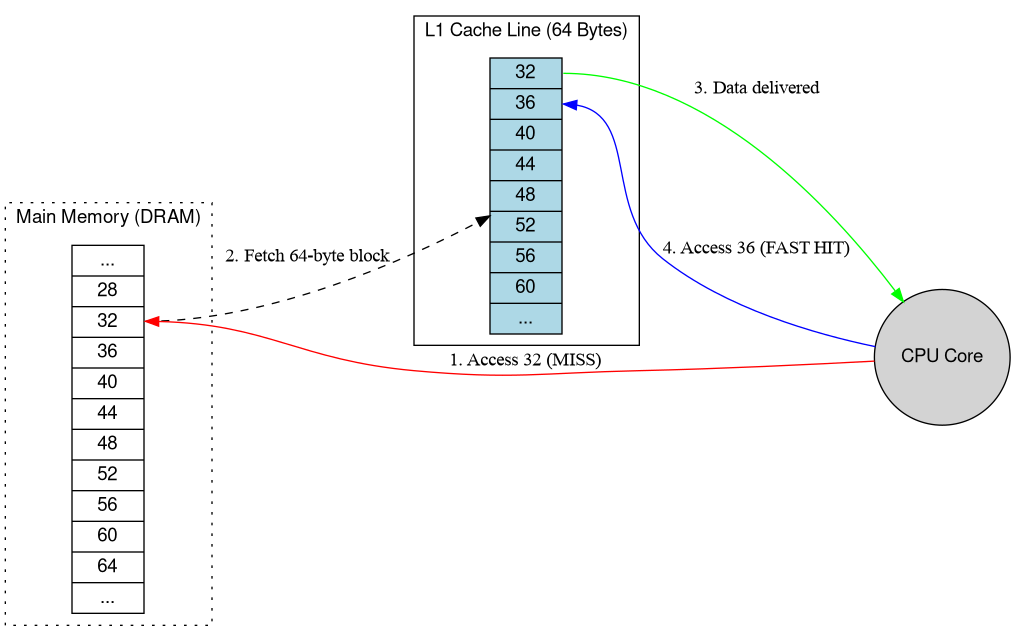
सीपीयू, मेमोरी से सिंगल बाइट लोड नहीं करते. इसके बजाय, वे तय साइज़ वाले ब्लॉक लोड करते हैं. इन्हें कैश लाइनें कहा जाता है. ये आम तौर पर 64 बाइट की होती हैं. किसी एक वैरिएबल को ऐक्सेस करने पर, सीपीयू उस वैरिएबल को शामिल करने वाले पूरे 64-बाइट के चंक को कैश मेमोरी में फ़ेच करता है.
टीएलबी (ट्रांसलेशन लुकसाइड बफ़र)
Android, वर्चुअल मेमोरी का इस्तेमाल करता है. मेमोरी के हर ऐक्सेस के लिए, वर्चुअल पते को फ़िज़िकल पते में बदलना ज़रूरी होता है. टीएलबी एक खास तरह की कैश मेमोरी होती है. इसमें हाल ही में किए गए अनुवादों को सेव किया जाता है. टीएलबी मिस होने पर, कर्नल को मुख्य मेमोरी में पेज टेबल को स्कैन करना पड़ता है. यह टीएलबी हिट की तुलना में ज़्यादा महंगा ऑपरेशन है.
हार्डवेयर प्रोफ़ाइल: Pixel 10 Pro Fold
यहां दिए गए सभी निर्देशों को Pixel 10 Pro Fold हार्डवेयर डिवाइस पर आज़माया गया है. इस डिवाइस में Google Tensor G5 SoC है.
हार्डवेयर की जांच करना
मेमोरी सबसिस्टम को समझने के लिए, हम सबसे पहले सीपीयू कॉन्फ़िगरेशन और कैश पैरामीटर की जांच करते हैं.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
सीपीयू के हिस्सों को डीकोड करना
/proc/cpuinfo में मौजूद CPU part वैल्यू, एआरएम सीपीयू कोर के लिए हेक्साडेसिमल आइडेंटिफ़ायर हैं. Pixel 10 Pro Fold में मौजूद Laguna SoC के लिए, ये इस तरह मैप किए जाते हैं:
0xd8b: ARM Cortex-A520 (एफ़िशिएंसी कोर)0xd90: ARM Cortex-A720 (परफ़ॉर्मेंस कोर)0xd8c: ARM Cortex-X4 (प्राइम कोर)
यह 4+3+1 कॉन्फ़िगरेशन, आधुनिक मोबाइल एसओसी में आम है. इसमें अलग-अलग क्लस्टर में कैश मेमोरी का साइज़ और इंतज़ार का समय (लेटेंसी) अलग-अलग हो सकता है.
इलाके के टाइप
सॉफ़्टवेयर के बेहतर डिज़ाइन के लिए, दो तरह की लोकैलिटी का इस्तेमाल किया जाता है:
- स्पेशल लोकैलिटी: अगर किसी मेमोरी की जगह की जानकारी को ऐक्सेस किया जाता है, तो आस-पास की मेमोरी की जगह की जानकारी को भी जल्द ही ऐक्सेस किया जा सकता है. सीक्वेंशियल ऐरे ट्रैवर्सल इसका सबसे अच्छा उदाहरण है. सीपीयू पूरी कैश लाइन लोड करता है. इसलिए, अगर किसी ऐरे में मौजूद अगला एलिमेंट पहले से ही कैश लाइन में है, तो उसे ऐक्सेस करने में कोई खास समय नहीं लगता.
- टेंपोरल लोकैलिटी: अगर किसी मेमोरी लोकेशन को ऐक्सेस किया जाता है, तो उसी लोकेशन को जल्द ही फिर से ऐक्सेस किए जाने की संभावना होती है. अच्छे एल्गोरिदम, डेटा को तब तक फिर से इस्तेमाल करते हैं, जब तक वह कैश मेमोरी में "हॉट" रहता है.
प्रैक्टिकल: simpleperf की मदद से लोकैलिटी मेज़र करना
इस एक्सरसाइज़ में, हम simpleperf का इस्तेमाल करके, हार्डवेयर की परफ़ॉर्मेंस के काउंटर को मॉनिटर करेंगे. इस दौरान, 256 एमबी की मैट्रिक्स के दो अलग-अलग ट्रैवर्सल चलाए जाएंगे.
- रो-मेजर ट्रैवर्सल: मैट्रिक्स के एलिमेंट को उस क्रम में ऐक्सेस करता है जिस क्रम में वे मेमोरी में सेव होते हैं. यह कैश मेमोरी के साथ काम करता है और इसमें जगह के हिसाब से डेटा को व्यवस्थित किया जाता है.
- कॉलम-मेजर ट्रैवर्सल: यह कॉलम के हिसाब से एलिमेंट ऐक्सेस करने के लिए, मेमोरी में जंप करता है. यह अक्सर कैश मेमोरी और टीएलबी को छोड़ देता है. इससे सीपीयू को रुकना पड़ता है.
1. Simpleperf का इस्तेमाल करके परफ़ॉर्मेंस की जांच करना
बाइनरी को पुश करें. साथ ही, पक्का करें कि वह एक्ज़ीक्यूटेबल हो. इसके बाद, simpleperf stat का इस्तेमाल करके, कैश मेमोरी और टीएलबी इवेंट मेज़र करें. हम userspace में इवेंट मेज़र करने के लिए, :u सफ़िक्स का इस्तेमाल करते हैं.
इन कमांड के लिए, ज़्यादातर डिवाइसों पर हार्डवेयर पीएमयू काउंटर को ऐक्सेस करने के लिए adb root की ज़रूरत होती है.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
प्रोफ़ाइल रो-मेजर:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
प्रोफ़ाइल कॉलम-मेजर:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. सैंपल मेज़रमेंट (Pixel 10 Pro Fold)
नीचे दिए गए नतीजे, Pixel 10 Pro Fold के हार्डवेयर डिवाइस पर मेज़र किए गए थे:
| मेट्रिक | रो-मेजर (आसान) | कॉलम-मेजर (अनफ़्रेंडली) | डिफ़रेंस |
|---|---|---|---|
| लागू करने का समय | 0.83 सेकंड | 68.3 सेकंड | ~82 गुना ज़्यादा समय लगा |
| निर्देश | 527 करोड़ | 10.20 अरब | ~1.9 गुना ज़्यादा |
| सीपीयू साइकल | 120 करोड़ | 62.18 अरब | ~52 गुना ज़्यादा |
| निर्देश प्रति साइकल (आईपीसी) | 4.40 | 0.16 | 27 गुना कम असरदार |
| L1 डेटा कैश मेमोरी मिस होने की संख्या | 21 करोड़ | 33690 लाख | 16 गुना ज़्यादा बार टारगेट नहीं किया गया |
| dTLB Load Misses | 0.13 मिलियन | 2,888 मिलियन | 22,000 गुना ज़्यादा बार चूकना |
3. नतीजों का विश्लेषण
- आईपीसी क्रैश: रो-मेजर टेस्ट में, सीपीयू को 4.40 का आईपीसी मिला. इससे पता चलता है कि यह हर साइकल में कई निर्देशों को कुशलता से पूरा कर रहा है. कॉलम-मेजर टेस्ट में, आईपीसी 0.16 तक गिर जाता है. इसका मतलब है कि सीपीयू, 96% समय तक रुका रहता है. ऐसा इसलिए होता है, क्योंकि उसे DRAM से डेटा मिलने का इंतज़ार करना पड़ता है.
- टीएलबी बॉटलनेक: सबसे बड़ा अंतर dTLB-load-misses में है. सीक्वेंशियल ऐक्सेस (रो-मेजर) एक ही मेमोरी पेज में रहता है. इसलिए, टीएलबी मिस होने की संख्या बहुत कम होती है. कॉलम के हिसाब से (कॉलम-मेजर) डेटा को व्यवस्थित करने पर, सीपीयू को लगातार नए पेजों का रेफ़रंस देना पड़ता है. इससे टीएलबी पर ज़्यादा असर पड़ता है और पेज टेबल को ज़्यादा समय तक स्कैन करना पड़ता है.
- कैश मेमोरी का बेहतर इस्तेमाल: कॉलम-मेजर ट्रैवर्सल से, L1 कैश मेमोरी में 16 गुना ज़्यादा बार डेटा नहीं मिलता. इससे सीपीयू को L3 या DRAM से लगातार डेटा फ़ेच करना पड़ता है, जो बहुत धीमा होता है.
निष्कर्ष: दोनों ट्रैवर्सल ने एक ही डेटा पर एक ही लॉजिकल ऑपरेशन किया. हालांकि, कॉलम-मेजर ट्रैवर्सल, रो-मेजर ट्रैवर्सल से 80 गुना ज़्यादा समय लेता है. यह बड़ा अंतर, ऐक्सेस पैटर्न के सीपीयू के मेमोरी सबसिस्टम की असल स्थिति के साथ इंटरैक्ट करने की वजह से होता है.
Java और Kotlin के डेटा स्ट्रक्चर में पॉइंटर चेज़िंग
2D मैट्रिक्स बेंचमार्क, लगातार नेटिव ऐरे में स्पैटियल लोकैलिटी दिखाता है. हालाँकि, ज़्यादातर Android ऐप्लिकेशन और फ़्रेमवर्क कोड, Java और Kotlin में लिखा जाता है. मैनेज की गई भाषाओं में, ऑब्जेक्ट वैरिएबल और कलेक्शन एलिमेंट, ऑब्जेक्ट को इनलाइन सेव नहीं करते. वे हीप में असाइन किए गए ऑब्जेक्ट के रेफ़रंस (पॉइंटर) सेव करते हैं. ये ऑब्जेक्ट, एआरटी हीप में बिखरे होते हैं.
नेस्ट किए गए रेफ़रंस ग्राफ़ की लागत
Android ऐप्लिकेशन और सिस्टम सेवाओं में एक सामान्य पैटर्न होता है: नेस्ट किए गए कलेक्शन को ट्रैवर्स करना. जैसे, स्टेट ऑब्जेक्ट का ArrayList. इनमें से हर ऑब्जेक्ट में, लिसनर या कनेक्शन का ArrayMap या ArraySet होता है. इनमें से हर ऑब्जेक्ट, किसी अन्य स्टेट रिकॉर्ड की ओर इशारा करता है.
भले ही, ArrayList, ArrayMap, और ArraySet अपने इंटरनल Object[] ऐरे को लगातार सेव करते हैं, लेकिन उस Object[] में मौजूद हर एलिमेंट अब भी हीप रेफ़रंस होता है. process.services.valueAt(i).connections.valueAt(j).client जैसी चेन को डीरेफ़रंस करने के लिए, मेमोरी को पांच बार क्रम से लोड करना पड़ता है:
Object[]बैकिंगservicesलोड करें.ServiceRecordऑब्जेक्ट हेडर और फ़ील्ड लोड करें.Object[]बैकिंगconnectionsलोड करें.ConnectionRecordऑब्जेक्ट लोड करें.- टारगेट
ProcessRecordफ़ील्ड लोड करें.
हर लोड का मेमोरी पता, पिछले लोड से मिली वैल्यू पर निर्भर करता है. इसलिए, सीपीयू का आउट-ऑफ़-ऑर्डर एक्ज़ीक्यूशन इंजन और हार्डवेयर प्रीफ़ेचर, उन्हें ओवरलैप नहीं कर सकते. अगर उन ऑब्जेक्ट को अलग-अलग समय पर मेमोरी में जगह दी गई थी या गार्बेज कलेक्शन के दौरान उन्हें अलग-अलग क्षेत्रों में ले जाया गया था, तो हर हॉप में L1 या L2 कैश मेमोरी मिस होने का खतरा होता है.
बॉक्स वाली प्रिमिटिव (ArrayList<Integer>, HashMap<Long, Boolean>) और सामान्य लैम्ब्डा, इस ओवरहेड को बढ़ाते हैं: हर एलिमेंट को ढूंढने के लिए, वैल्यू को अनबॉक्स करने के लिए एक अतिरिक्त पॉइंटर डीरेफ़रेंस की ज़रूरत होती है. साथ ही, सामान्य Consumer<T> कॉलबैक, रनटाइम टाइप-चेक (CheckCast) स्टब डालते हैं, जो निर्देश कैश मेमोरी (L1-icache) पर दबाव डालते हैं.
simpleperf की मदद से, पॉइंटर चेज़िंग की समस्या का पता लगाना
Java और Kotlin के असली वर्कलोड (जैसे कि system_server के OomAdjuster ट्रैवर्सिंग प्रोसेस, सेवा, और प्रोवाइडर रेफ़रंस ग्राफ़) में, पॉइंटर चेज़िंग की वजह से आईपीसी में गिरावट कभी-कभी ही 0.16 तक होती है. ऐसा सिंथेटिक 256 एमबी कॉलम-मेजर स्कैन की तरह होता है, क्योंकि वर्किंग सेट का कुछ हिस्सा L2 या L3 कैश मेमोरी में फ़िट हो जाता है.
इसके बजाय, simpleperf में इस तरह के सिग्नेचर ढूंढें:
- कम आईपीसी (करीब 0.6 से 0.9): यह सीपीयू की सुपरस्केलर रिटायर विड्थ से काफ़ी कम है.
- बैकएंड मेमोरी स्टॉल (
raw-stall-backend-mem) ज़्यादा होना: अक्सर सभी सीपीयू साइकल का 35% से 45% हिस्सा, डेटा कैश मेमोरी भरने के लिए इंतज़ार करने में खर्च हो जाता है. - बढ़ा हुआ
L1-dcache-load-missesऔरL1-icache-load-misses: डेटा कैश मेमोरी के हिट न होने की दर ज़्यादा होती है. साथ ही, वर्चुअल तरीकों और सामान्य लैम्ब्डा स्टब के बीच हॉट ट्रैवर्सल लूप जंप करने पर, निर्देश कैश मेमोरी के हिट न होने की दर भी ज़्यादा होती है.
simpleperf stat का इस्तेमाल करके, चालू प्रोसेस पर इन काउंटर को मेज़र किया जा सकता है:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
मैनेज किए गए कोड में लोकैलिटी को बेहतर बनाना
- बॉक्स वाले कलेक्शन को प्रिमिटिव ऐरे या AndroidX कलेक्शन से बदलें:
रैपर ऑब्जेक्ट हटाने के लिए,
IntArray,LongArray,SparseIntArrayयाandroidx.collectionप्रिमिटिव (IntList,LongLongMap,ScatterMap) का इस्तेमाल करें. साथ ही, वैल्यू को एक ही ऐरे में लगातार असाइन करें. - बार-बार इस्तेमाल होने वाले ट्रैवर्सल पाथ को फ़्लैट करें: अगर कोई हॉट लूप, किसी ऑब्जेक्ट ग्राफ़ में बार-बार तीन या चार हॉप करता है, ताकि एक बूलियन या पूर्णांक फ़्लैग को पढ़ा जा सके, तो उस स्थिति को फ़्लैट अरे या बिटमास्क में ले जाएं या उसे कैश मेमोरी में सेव करें. इसे डेंस आईडी से इंडेक्स किया जाता है.
- इनर लूप में कैप्चर करने या सामान्य लैम्ब्डा से बचें: इटरेटर के लिए मेमोरी असाइन करने, मेगामॉर्फिक डिस्पैच, और रनटाइम टाइप-चेक के ओवरहेड से बचने के लिए,
forEachया इटरेटर चेन के बजाय,RandomAccessसूचियों पर स्टैंडर्ड इंडेक्स किए गएforलूप का इस्तेमाल करें.
← Threads | ↑ ऊपर जाएं | सेवाओं के साथ इंटिग्रेशन →