

Sebbene la memoria sia spesso considerata un unico pool di archiviazione uniforme, la sua organizzazione fisica e il modo in cui la CPU vi accede hanno un profondo impatto sulle prestazioni delle applicazioni. Comprendere la località della memoria è fondamentale per scrivere codice ad alte prestazioni che utilizzi in modo efficiente la gerarchia della cache della CPU.
La gerarchia della cache della CPU
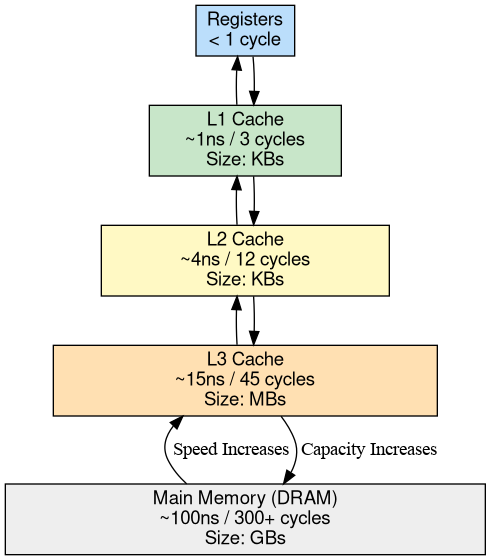
Una CPU mobile moderna è molto più veloce della RAM principale (DRAM) del sistema. Per colmare questo divario di prestazioni, le CPU utilizzano diversi livelli di memoria piccola ed estremamente veloce chiamata cache.
- Cache L1 (livello 1): la più piccola e veloce (~1 ns). Su una CPU da 3 GHz, si tratta di circa 3 cicli di clock.
- Cache L2 (livello 2): più grande e leggermente più lenta (~3-5 ns o ~10-15 cicli).
- Cache L3 (livello 3): la cache più grande (~10-20 ns o ~30-60 cicli).
- Memoria principale (DRAM): la più grande e la più lenta (~100 ns o ~300 cicli).
Contestualizzazione della latenza: il costo di uno stallo
Per comprendere l'impatto di questi numeri, considera una moderna CPU superscalare che può ritirare da 4 a 8 istruzioni per ciclo di clock.
Se la CPU non trova nulla nelle cache e deve attendere 100 ns (300 cicli) per una lettura DRAM:
- Cicli persi: circa 300 cicli.
- Istruzioni "Sprecate": tra 1200 e 2400 istruzioni che avrebbero potuto essere eseguite se i dati fossero già in un registro locale o nella cache L1.
Quando il codice ha una scarsa località di memoria, la CPU non è necessariamente occupata con matematica complessa; è spesso "in stallo", inattiva per migliaia di equivalenti di istruzioni in attesa del sottosistema di memoria.
Istruzioni per ciclo (IPC)
Una metrica chiave per misurare questa efficienza è Istruzioni per ciclo (IPC). IPC rappresenta il numero di istruzioni che la CPU "ritira" (completa) in media durante ogni ciclo di clock.
- IPC elevato (ad es. 3,0 - 5,0): la CPU funziona con un'efficienza elevata, probabilmente trova la maggior parte dei dati nelle cache o nei registri L1/L2.
- IPC basso (ad es. < 0,5): la CPU è gravemente limitata. Anche se la CPU è al 100% di "utilizzo" nei monitor di sistema, in realtà viene utilizzata principalmente per l'attesa della memoria, uno stato noto come stallo della memoria.
La località della memoria è il fattore principale che determina se un ciclo a uso intensivo di dati viene eseguito con un IPC elevato o si riduce a una serie di stalli.
Linee della cache
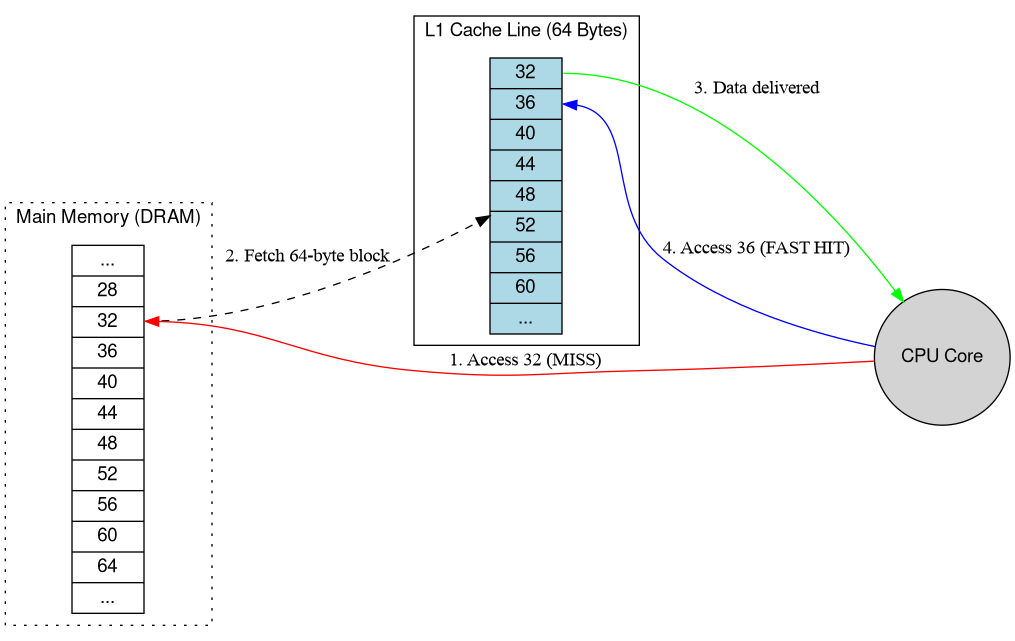
Le CPU non caricano singoli byte dalla memoria. Caricano invece blocchi di dimensioni fisse chiamati linee di cache, che in genere sono di 64 byte. Quando accedi a una singola variabile, la CPU recupera nella cache l'intero blocco di 64 byte che la contiene.
TLB (translation lookaside buffer)
Android utilizza la memoria virtuale. Ogni accesso alla memoria richiede la traduzione di un indirizzo virtuale in un indirizzo fisico. La TLB è una cache specializzata che memorizza le traduzioni recenti. Un TLB miss richiede al kernel di scorrere le tabelle delle pagine nella memoria principale, un'operazione relativamente costosa rispetto a un TLB hit.
Profilo hardware: Pixel 10 Pro Fold
Per i seguenti esercizi, abbiamo utilizzato un dispositivo hardware Pixel 10 Pro Fold. Questo dispositivo è dotato di un SoC Google Tensor G5.
Interrogazione dell'hardware
Per comprendere il sottosistema di memoria, esaminiamo innanzitutto la configurazione della CPU e i parametri della cache.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
Decodifica delle parti della CPU
I valori CPU part in /proc/cpuinfo sono identificatori esadecimali per i core della CPU ARM. Per il SoC Laguna presente in Pixel 10 Pro Fold, questi corrispondono a:
0xd8b: ARM Cortex-A520 (core efficienti)0xd90: ARM Cortex-A720 (core per le prestazioni)0xd8c: ARM Cortex-X4 (core Prime)
Questa configurazione 4+3+1 è comune nei SoC mobili moderni, in cui cluster diversi possono avere dimensioni e latenze della cache diverse.
Tipi di località
La progettazione efficiente del software si basa su due tipi principali di località:
- Località spaziale: se si accede a una posizione di memoria, è probabile che si acceda presto alle posizioni di memoria vicine. L'attraversamento sequenziale dell'array è l'esempio classico. Poiché la CPU carica un'intera riga della cache, l'accesso all'elemento successivo di un array è quasi "senza costi" se si trova già nella riga della cache.
- Località temporale: se si accede a una posizione di memoria, è probabile che si acceda di nuovo alla stessa posizione a breve. I buoni algoritmi riutilizzano i dati mentre sono ancora "caldi" nella cache.
Esercizio pratico: misurare la località con simpleperf
In questo esercizio, utilizzeremo simpleperf per monitorare i contatori delle prestazioni hardware durante l'esecuzione di due diverse traversate di una matrice di 256 MB.
- Attraversamento per righe: accede agli elementi della matrice nell'ordine in cui sono memorizzati. Questo è compatibile con la cache e sfrutta la località spaziale.
- Attraversamento per colonne: salta attraverso la memoria per accedere agli elementi per colonna. Spesso la cache e il TLB non vengono trovati, il che costringe la CPU a bloccarsi.
1. Esegui con Simpleperf
Trasferisci il binario, assicurati che sia eseguibile e utilizza simpleperf stat per misurare
gli eventi di cache e TLB. Utilizziamo il suffisso :u per misurare gli eventi nello spazio utente.
Questi comandi richiedono adb root per accedere ai contatori PMU hardware sulla maggior parte dei dispositivi.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
Profilo Row-major:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
Profilo Column-major:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. Esempi di misurazioni (Pixel 10 Pro Fold)
I seguenti risultati sono stati misurati su un dispositivo hardware Pixel 10 Pro Fold:
| Metrica | Row-major (Friendly) | Column-major (Unfriendly) | Differenza |
|---|---|---|---|
| Tempo di esecuzione | 0,83 secondi | 68,3 secondi | ~82 volte più lento |
| Istruzioni | 5,27 miliardi | 10,20 miliardi | ~1,9 volte in più |
| Cicli CPU | 1,20 miliardi | 62,18 miliardi | Circa 52 volte in più |
| Istruzioni per ciclo (IPC) | 4.40 | 0,16 | Efficienza 27 volte inferiore |
| Mancanze nella cache di dati L1 | 210 milioni | 3369 milioni | 16 volte più errori |
| Errori di caricamento dTLB | 0,13 milioni | 2.888 milioni | 22.000 volte più errori |
3. Analisi dei risultati
- Arresto anomalo IPC: nel test row-major, la CPU raggiunge un IPC di 4,40, il che indica che esegue in modo efficiente più istruzioni per ciclo. Nel test column-major, l'IPC scende a 0,16. Ciò significa che la CPU è inattiva per il 96% del tempo, in attesa dell'arrivo dei dati dalla DRAM.
- Il collo di bottiglia TLB: la differenza più evidente si riscontra in dTLB-load-misses. L'accesso sequenziale (per righe) rimane all'interno delle stesse pagine di memoria, con conseguenti errori TLB molto rari. Il salto tra le colonne (ordine per colonna) fa sì che la CPU faccia costantemente riferimento a nuove pagine, sovraccaricando la TLB e forzando costose ricerche nella tabella delle pagine.
- Efficienza della cache: l'attraversamento column-major genera 16 volte più errori della cache L1, costringendo la CPU a recuperare costantemente i dati dalla cache L3 o dalla DRAM, molto più lente.
Osservazione:anche se entrambi gli attraversamenti hanno eseguito la stessa operazione logica sugli stessi dati, l'attraversamento column-major è stato oltre 80 volte più lento. Questa enorme differenza è dovuta interamente al modo in cui il modello di accesso interagisce con la realtà fisica del sottosistema di memoria della CPU.
Pointer chasing nelle strutture di dati Java e Kotlin
Mentre il benchmark della matrice 2D dimostra la località spaziale in array nativi contigui, la maggior parte del codice dell'app per Android e del framework è scritto in Java e Kotlin. Nei linguaggi gestiti, le variabili oggetto e gli elementi della raccolta non memorizzano gli oggetti inline, ma memorizzano riferimenti (puntatori) a oggetti allocati nell'heap sparsi nell'heap ART.
Il costo dei grafici di riferimento nidificati
Prendi in considerazione un pattern comune nelle app e nei servizi di sistema Android: l'attraversamento
di raccolte nidificate come un ArrayList di oggetti di stato, ognuno contenente un
ArrayMap o un ArraySet di listener o connessioni, ognuno dei quali punta a un altro
record di stato.
Anche se ArrayList, ArrayMap e ArraySet memorizzano i relativi array Object[] interni in modo contiguo, ogni elemento di Object[] è comunque un riferimento all'heap. Il dereferenziamento di una catena come
process.services.valueAt(i).connections.valueAt(j).client richiede cinque
caricamenti sequenziali della memoria dipendente:
- Carica il
Object[]supportoservices. - Carica l'intestazione e i campi dell'oggetto
ServiceRecord. - Carica il
Object[]supportoconnections. - Carica l'oggetto
ConnectionRecord. - Carica il campo di destinazione
ProcessRecord.
Poiché l'indirizzo di memoria di ogni caricamento dipende dal valore restituito dal caricamento precedente, il motore di esecuzione fuori ordine e il prefetcher hardware della CPU non possono sovrapporsi. Se questi oggetti sono stati allocati in momenti diversi o spostati in regioni diverse durante la garbage collection, ogni hop rischia un fallimento della cache L1 o L2.
Le primitive in scatola (ArrayList<Integer>, HashMap<Long, Boolean>) e le espressioni lambda generiche aumentano questo overhead: ogni ricerca di elementi richiede un dereferenziazione del puntatore aggiuntiva per estrarre il valore e i callback generici Consumer<T> inseriscono stub di controllo del tipo di runtime (CheckCast) che aumentano la pressione sulla cache delle istruzioni (L1-icache).
Diagnosi dell'inseguimento del puntatore con simpleperf
Nei carichi di lavoro Java e Kotlin reali (come il processo di attraversamento di system_server
OomAdjuster, i grafici di riferimento di servizi e fornitori),
l'inseguimento dei puntatori raramente riduce l'IPC fino a 0,16 come una scansione sintetica di 256 MB
in ordine di colonna, perché parte del working set rientra nella cache L2 o L3.
Cerca invece questa firma caratteristica in simpleperf:
- IPC basso (circa 0,6-0,9): molto al di sotto della larghezza di ritiro superscalare della CPU.
- Stalli di memoria di backend elevati (
raw-stall-backend-mem): spesso il 35-45% di tutti i cicli della CPU viene speso in attesa del riempimento della cache dei dati. - Elevati
L1-dcache-load-misseseL1-icache-load-misses: tassi elevati di fallimento della cache dei dati associati a fallimenti della cache delle istruzioni quando i loop di attraversamento frequente saltano metodi virtuali e stub lambda generici.
Puoi misurare questi contatori su un processo in esecuzione utilizzando simpleperf stat:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
Miglioramento della località nel codice gestito
- Sostituisci le raccolte in scatola con array primitivi o raccolte AndroidX:
utilizza i primitivi
IntArray,LongArray,SparseIntArrayoandroidx.collection(IntList,LongLongMap,ScatterMap) per eliminare gli oggetti wrapper e mantenere i valori contigui all'interno di una singola allocazione di array. - Appiattisci i percorsi di attraversamento frequenti: se un ciclo frequente attraversa ripetutamente tre o quattro hop in un grafico di oggetti per leggere un singolo flag booleano o intero, sposta o memorizza nella cache questo stato in un array piatto o in una maschera di bit indicizzata da un ID denso.
- Evita di acquisire o utilizzare espressioni lambda generiche in cicli interni stretti: utilizza cicli
forindicizzati standard su elenchiRandomAccessanziché catene di iteratoriforEacho iteratori per evitare allocazioni di iteratori, dispatch megamorfico e overhead di controllo del tipo di runtime.
← Thread | ↑ Su | Associazioni di servizi →