

Pamięć jest często postrzegana jako pojedyncza, jednolita pula pamięci masowej, ale jej fizyczna organizacja i sposób, w jaki procesor uzyskuje do niej dostęp, mają ogromny wpływ na wydajność aplikacji. Zrozumienie lokalności pamięci jest kluczem do pisania kodu o wysokiej wydajności, który efektywnie wykorzystuje hierarchię pamięci podręcznej procesora.
Hierarchia pamięci podręcznej procesora
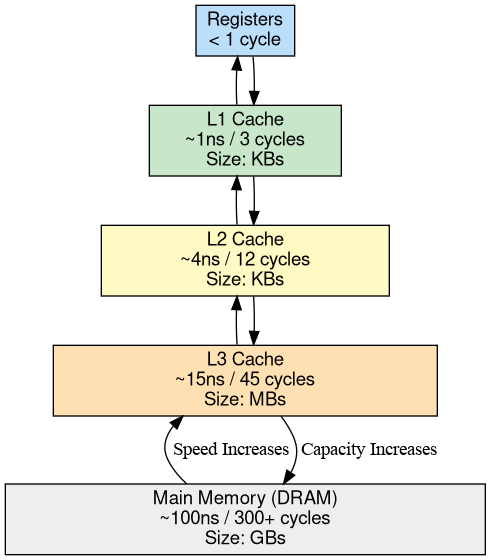
Nowoczesny mobilny procesor jest znacznie szybszy niż główna pamięć RAM systemu (DRAM). Aby zniwelować tę różnicę w wydajności, procesory korzystają z kilku poziomów małej, niezwykle szybkiej pamięci zwanej pamięcią podręczną.
- Pamięć podręczna L1 (poziom 1): najmniejsza i najszybsza (~1 ns). Na procesorze 3 GHz to około 3 cykle zegara.
- Pamięć podręczna L2 (poziom 2): większa i nieco wolniejsza (ok. 3–5 ns lub ok. 10–15 cykli).
- Pamięć podręczna L3 (poziom 3): największa pamięć podręczna (ok. 10–20 ns lub ok. 30–60 cykli).
- Pamięć główna (DRAM): największa i najwolniejsza (~100 ns lub ~300+ cykli).
Kontekstualizacja opóźnienia: koszt przestoju
Aby zrozumieć wpływ tych liczb, weź pod uwagę nowoczesny superskalarny procesor, który może wycofywać od 4 do 8 instrukcji na cykl zegarowy.
Jeśli procesor nie znajdzie danych w żadnej pamięci podręcznej i musi czekać 100 ns (300 cykli) na odczyt z pamięci DRAM:
- Utracone cykle: ok. 300 cykli.
- Instrukcje „Zmarnowane”: od 1200 do 2400 instrukcji,które można było wykonać,gdyby dane były już w rejestrze lokalnym lub w pamięci podręcznej L1.
Gdy kod ma słabą lokalność pamięci, procesor niekoniecznie jest zajęty złożonymi obliczeniami matematycznymi. Często jest „wstrzymywany” i bezczynnie czeka na podsystem pamięci przez tysiące odpowiedników instrukcji.
Instrukcje na cykl (IPC)
Kluczowym wskaźnikiem pomiaru tej wydajności jest liczba instrukcji na cykl (IPC). IPC to średnia liczba instrukcji, które procesor „wycofuje” (wykonuje) w każdym cyklu zegarowym.
- Wysoka liczba instrukcji na cykl zegara (np. 3,0–5,0): procesor działa z wysoką wydajnością, prawdopodobnie większość danych znajduje się w pamięci podręcznej L1/L2 lub rejestrach.
- Niska liczba instrukcji na cykl zegara (np. < 0,5): procesor jest poważnie ograniczony. Nawet jeśli w monitorach systemu procesor jest w 100% „wykorzystywany”, w rzeczywistości większość czasu spędza na oczekiwaniu na pamięć – stan ten jest znany jako zastój pamięci.
Lokalizacja pamięci jest głównym czynnikiem decydującym o tym, czy pętla intensywnie korzystająca z danych działa z wysokim IPC, czy też powoduje serię przestojów.
Wiersze pamięci podręcznej
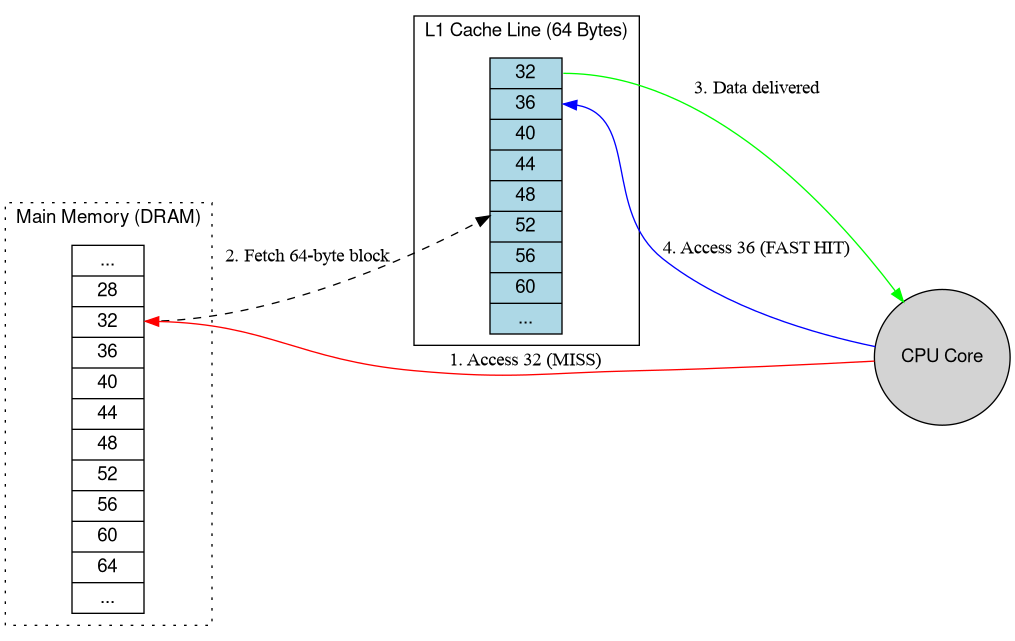
Procesory nie wczytują pojedynczych bajtów z pamięci. Zamiast tego wczytują bloki o stałym rozmiarze, zwane liniami pamięci podręcznej, które zwykle mają 64 bajty. Gdy uzyskujesz dostęp do pojedynczej zmiennej, procesor pobiera do pamięci podręcznej cały 64-bajtowy blok, który ją zawiera.
TLB (translation lookaside buffer)
Android korzysta z pamięci wirtualnej. Każdy dostęp do pamięci wymaga przetłumaczenia adresu wirtualnego na adres fizyczny. TLB to specjalna pamięć podręczna, w której przechowywane są ostatnie tłumaczenia. Brak w TLB wymaga od jądra przeszukiwania tabel stron w pamięci głównej, co jest stosunkowo kosztowną operacją w porównaniu z trafieniem w TLB.
Profil sprzętowy: Pixel 10 Pro Fold
W przypadku poniższych ćwiczeń użyliśmy urządzenia Pixel 10 Pro Fold. To urządzenie jest wyposażone w układ SoC Google Tensor G5.
Sprawdzanie sprzętu
Aby zrozumieć podsystem pamięci, najpierw zbadamy konfigurację procesora i parametry pamięci podręcznej.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
Dekodowanie części procesora
Wartości CPU part w /proc/cpuinfo to szesnastkowe identyfikatory rdzeni procesora ARM. W przypadku układu SoC Laguna w Pixelu 10 Pro Fold odpowiadają one tym wartościom:
0xd8b: ARM Cortex-A520 (rdzenie energooszczędne)0xd90: ARM Cortex-A720 (rdzenie o wysokiej wydajności)0xd8c: ARM Cortex-X4 (rdzeń główny)
Ta konfiguracja 4+3+1 jest powszechna w nowoczesnych mobilnych układach SoC, w których różne klastry mogą mieć różne rozmiary pamięci podręcznej i opóźnienia.
Rodzaje miejscowości
Efektywne projektowanie oprogramowania opiera się na 2 głównych typach lokalności:
- Lokalizacja przestrzenna: jeśli uzyskuje się dostęp do lokalizacji pamięci, wkrótce prawdopodobnie nastąpi dostęp do pobliskich lokalizacji pamięci. Klasycznym przykładem jest sekwencyjne przechodzenie po tablicy. Procesor wczytuje całą linię pamięci podręcznej, więc dostęp do następnego elementu w tablicy jest niemal „bezpłatny”, jeśli znajduje się on już w linii pamięci podręcznej.
- Lokalność czasowa: jeśli nastąpi dostęp do lokalizacji pamięci, prawdopodobnie wkrótce nastąpi ponowny dostęp do tej samej lokalizacji. Dobre algorytmy ponownie wykorzystują dane, dopóki są one „aktywne” w pamięci podręcznej.
Praktyczne ćwiczenie: pomiar lokalności za pomocą narzędzia simpleperf
W tym ćwiczeniu użyjemy narzędzia simpleperf do monitorowania liczników wydajności sprzętu podczas wykonywania 2 różnych przejść po macierzy o rozmiarze 256 MB.
- Przechodzenie wierszami: dostęp do elementów macierzy w kolejności, w jakiej są one przechowywane w pamięci. Jest to rozwiązanie przyjazne dla pamięci podręcznej, które wykorzystuje lokalność przestrzenną.
- Przechodzenie po kolumnach: przeskakuje po pamięci, aby uzyskać dostęp do elementów według kolumn. Często nie trafia do pamięci podręcznej ani TLB, co zmusza procesor do wstrzymania działania.
1. Uruchamianie za pomocą Simpleperf
Wypchnij plik binarny, upewnij się, że jest wykonywalny, i użyj simpleperf stat do pomiaru zdarzeń związanych z pamięcią podręczną i buforem TLB. Do pomiaru zdarzeń w przestrzeni użytkownika używamy sufiksu :u.
Te polecenia wymagają uprawnień adb root, aby uzyskać dostęp do liczników PMU sprzętu na większości urządzeń.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
Profil wierszowy:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
Profil Column-major:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. Przykładowe pomiary (Pixel 10 Pro Fold)
Poniższe wyniki zostały zmierzone na urządzeniu Pixel 10 Pro Fold:
| Wskaźnik | Główny wiersz (przyjazny) | Column-major (Unfriendly) | Różnica |
|---|---|---|---|
| Czas wykonywania | 0,83 sekundy | 68,3 sekundy | ~82 razy wolniejszy |
| Instrukcje | 5,27 mld | 10,20 mld | ~1,9x więcej |
| Cykle procesora | 1,20 mld | 62,18 mld | ~52 razy więcej |
| Instrukcje na cykl (IPC) | 4.40 | 0.16 | 27 razy mniejsza skuteczność |
| L1 Data Cache Misses | 210 mln | 3369 mln | 16 razy więcej niepowodzeń |
| dTLB Load Misses | 0,13 mln | 2,888 mln | 22 000 razy więcej błędów |
3. Analiza wyników
- The IPC Crash: w teście z głównym porządkiem wierszowym procesor osiąga IPC na poziomie 4,40, co oznacza, że efektywnie wykonuje wiele instrukcji w jednym cyklu. W teście z głównym układem kolumn IPC spada do 0, 16. Oznacza to, że procesor jest w 96% czasu wstrzymany i oczekuje na dane z pamięci DRAM.
- Wąskie gardło TLB: najbardziej znacząca różnica występuje w przypadku dTLB-load-misses. Dostęp sekwencyjny (wierszowy) pozostaje w ramach tych samych stron pamięci, co powoduje bardzo małą liczbę błędów TLB. Przeskakiwanie między kolumnami (w kolejności kolumnowej) powoduje, że procesor ciągle odwołuje się do nowych stron, co przeciąża TLB i wymusza kosztowne przeszukiwanie tabeli stron.
- Wydajność pamięci podręcznej: przechodzenie po kolumnach powoduje 16 razy więcej błędów w pamięci podręcznej L1, co zmusza procesor do ciągłego pobierania danych z znacznie wolniejszej pamięci L3 lub DRAM.
Obserwacja: mimo że oba przejścia wykonywały tę samą operację logiczną na tych samych danych, przejście w kolejności kolumnowej było ponad 80 razy wolniejsze. Ta ogromna różnica wynika w całości ze sposobu, w jaki wzorzec dostępu wchodzi w interakcję z fizyczną rzeczywistością podsystemu pamięci procesora.
Śledzenie wskaźników w strukturach danych w Javie i Kotlinie
Chociaż test porównawczy macierzy 2D pokazuje lokalność przestrzenną w przyległych tablicach natywnych, większość kodu aplikacji na Androida i platformy jest napisana w Javie i Kotlinie. W językach zarządzanych zmienne obiektów i elementy kolekcji nie przechowują obiektów wbudowanych, ale odwołania (wskaźniki) do obiektów przydzielonych do sterty, które są rozproszone po stercie ART.
Koszt wykresów zagnieżdżonych odwołań
Rozważmy typowy wzorzec w aplikacjach i usługach systemowych na Androidzie: przechodzenie przez zagnieżdżone kolekcje, takie jak ArrayList obiektów stanu, z których każdy zawiera ArrayMap lub ArraySet słuchaczy lub połączeń, z których każde wskazuje inny rekord stanu.
Mimo że ArrayList, ArrayMap i ArraySet przechowują swoje wewnętrzne tablice Object[] w sposób ciągły, każdy element tej tablicy Object[] jest nadal odwołaniem do sterty. Dereferencja łańcucha takiego jak
process.services.valueAt(i).connections.valueAt(j).client wymaga 5 kolejnych zależnych wczytań z pamięci:
- Załaduj
Object[]podkładservices. - Wczytaj nagłówek i pola obiektu
ServiceRecord. - Załaduj
Object[]podkładconnections. - Wczytaj obiekt
ConnectionRecord. - Wczytaj pole docelowe
ProcessRecord.
Ponieważ adres pamięci każdego wczytania zależy od wartości zwróconej przez poprzednie wczytanie, silnik wykonywania instrukcji poza kolejnością i sprzętowy mechanizm wstępnego pobierania procesora nie mogą się nakładać. Jeśli te obiekty zostały przydzielone w różnych momentach lub przeniesione do różnych regionów podczas odśmiecania pamięci, każdy przeskok może spowodować brak w pamięci podręcznej L1 lub L2.
Typy proste w pudełkach (ArrayList<Integer>, HashMap<Long, Boolean>) i ogólne lambdy zwiększają ten narzut: każde wyszukiwanie elementu wymaga dodatkowego dereferencjonowania wskaźnika w celu rozpakowania wartości, a ogólne wywołania zwrotne Consumer<T> wstawiają w czasie działania procedury sprawdzania typu (CheckCast), które zwiększają obciążenie pamięci podręcznej instrukcji (L1-icache).
Diagnozowanie śledzenia wskaźnika za pomocą narzędzia simpleperf
W rzeczywistych zadaniach w językach Java i Kotlin (takich jak system_serverOomAdjuster przechodzenie przez wykresy odwołań do procesów, usług i dostawców) śledzenie wskaźników rzadko powoduje spadek IPC do 0, 16, jak w przypadku syntetycznego skanowania 256 MB w układzie kolumnowym, ponieważ część zestawu roboczego mieści się w pamięci podręcznej L2 lub L3.
Zamiast tego poszukaj tego charakterystycznego podpisu w simpleperf:
- Obniżona liczba instrukcji na cykl (około 0,6–0,9): znacznie poniżej szerokości wycofywania superskalarnego procesora.
- Duża liczba przestojów pamięci backendu (
raw-stall-backend-mem): często od 35% do 45% wszystkich cykli procesora jest wykorzystywanych na oczekiwanie na wypełnienie pamięci podręcznej danych. - Wysokie wartości
L1-dcache-load-missesiL1-icache-load-misses: wysoki odsetek braków w pamięci podręcznej danych w połączeniu z brakami w pamięci podręcznej instrukcji, gdy pętle gorących przejść przeskakują między metodami wirtualnymi i ogólnymi atrapami lambda.
Te liczniki możesz mierzyć w przypadku działającego procesu za pomocą narzędzia simpleperf stat:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
Poprawa lokalności w kodzie zarządzanym
- Zastąp kolekcje opakowane tablicami typów prostych lub kolekcjami AndroidX: używaj typów prostych
IntArray,LongArray,SparseIntArraylubandroidx.collection(IntList,LongLongMap,ScatterMap), aby wyeliminować obiekty opakowujące i zachować ciągłość wartości w ramach jednej alokacji tablicy. - Spłaszczanie często używanych ścieżek przechodzenia: jeśli często używana pętla wielokrotnie przechodzi przez 3 lub 4 węzły w grafie obiektów, aby odczytać pojedynczą flagę logiczną lub całkowitą, przenieś lub zapisz w pamięci podręcznej ten stan w spłaszczonej tablicy lub masce bitowej indeksowanej przez gęsty identyfikator.
- Unikaj przechwytywania lub ogólnych funkcji lambda w wewnętrznych pętlach: używaj standardowych pętli indeksowanych
forna listachRandomAccesszamiastforEachlub łańcuchów iteratorów, aby uniknąć alokacji iteratorów, megamorficznego wysyłania i narzutu związanego ze sprawdzaniem typu w czasie działania.
← Wątki | ↑ W górę | Powiązania usług →