

Arbeitsspeicher wird oft als ein einzelner, einheitlicher Speicherpool betrachtet. Seine physische Organisation und die Art und Weise, wie die CPU darauf zugreift, haben jedoch einen großen Einfluss auf die Anwendungsleistung. Speicherlokalität ist ein wichtiger Begriff, wenn Sie leistungsstarken Code schreiben möchten, der die Cachehierarchie der CPU effizient nutzt.
Die CPU-Cache-Hierarchie
Eine moderne mobile CPU ist viel schneller als der Haupt-RAM (DRAM) des Systems. Um diese Leistungslücke zu schließen, verwenden CPUs mehrere Ebenen von kleinem, extrem schnellem Speicher, der als Cache bezeichnet wird.
- L1-Cache (Level 1): Der kleinste und schnellste (~1 ns). Auf einer 3-GHz-CPU sind das etwa 3 Taktzyklen.
- L2-Cache (Level 2): Größer und etwas langsamer (~3–5 ns oder ~10–15 Zyklen).
- L3-Cache (Level 3): Der größte Cache (~10–20 ns oder ~30–60 Zyklen).
- Arbeitsspeicher (DRAM): Der größte und langsamste (~100 ns oder ~300 Zyklen).
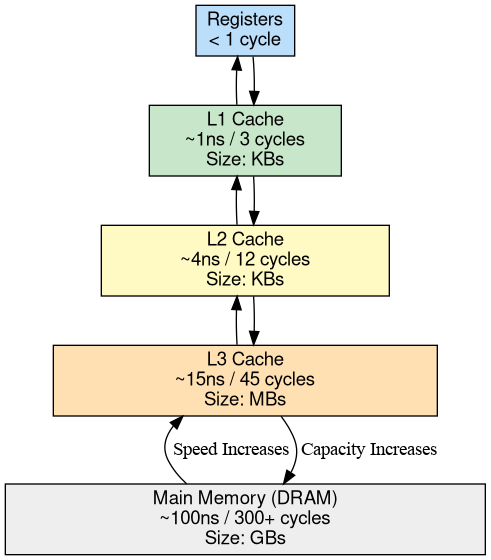
Latenz in den Kontext setzen: Die Kosten eines Stillstands
Um die Auswirkungen dieser Zahlen zu verstehen, betrachten wir eine moderne superskalare CPU, die 4 bis 8 Befehle pro Taktzyklus ausführen kann.
Wenn die CPU alle Caches verpasst und 100 ns (300 Zyklen) auf einen DRAM-Lesevorgang warten muss:
- Verlorene Zyklen: ca. 300 Zyklen
- Verschwendete Anweisungen: Zwischen 1.200 und 2.400 Anweisungen,die hätten ausgeführt werden können,wenn die Daten bereits in einem lokalen Register oder im L1-Cache gewesen wären.
Wenn Ihr Code eine schlechte Speicherlokalität aufweist, ist die CPU nicht unbedingt mit komplexen mathematischen Berechnungen beschäftigt. Sie ist häufig „blockiert“ und wartet Tausende von Befehlsäquivalenten lang auf das Speichersubsystem.
Anweisungen pro Zyklus (Instructions per Cycle, IPC)
Ein wichtiger Messwert für diese Effizienz ist Instructions Per Cycle (IPC). Der IPC gibt an, wie viele Anweisungen die CPU durchschnittlich in jedem Taktzyklus erfolgreich „ausführt“ (abschließt).
- Hohe IPC (z. B. 3,0 bis 5,0): Die CPU arbeitet mit hoher Effizienz und findet die meisten ihrer Daten wahrscheinlich in L1-/L2-Caches oder Registern.
- Niedriger IPC (z. B. < 0,5): Die CPU ist stark überlastet. Auch wenn die CPU in Systemmonitoren zu 100 % „ausgelastet“ ist, wartet sie tatsächlich meistens auf den Arbeitsspeicher – ein Zustand, der als Memory Stall bezeichnet wird.
Die Speicherlokalität ist der primäre Faktor, der bestimmt, ob eine datenintensive Schleife mit hoher IPC ausgeführt wird oder in eine Reihe von Stalls zusammenbricht.
Cache-Zeilen
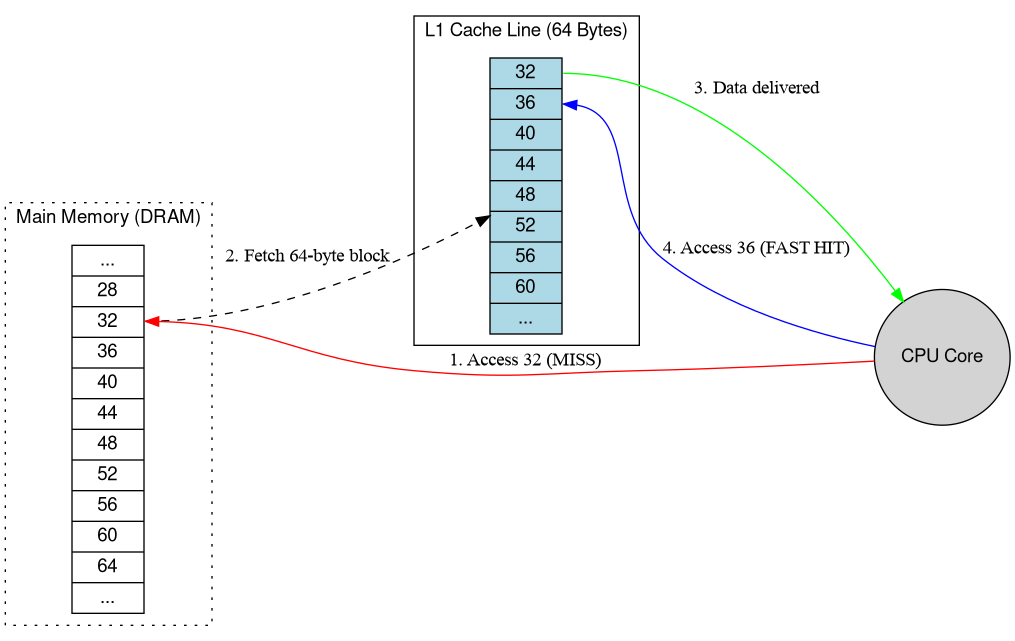
CPUs laden keine einzelnen Byte aus dem Arbeitsspeicher. Stattdessen werden Blöcke mit fester Größe geladen, die als Cache-Zeilen bezeichnet werden und in der Regel 64 Byte groß sind. Wenn Sie auf eine einzelne Variable zugreifen, ruft die CPU den gesamten 64‑Byte-Chunk, der sie enthält, in den Cache ab.
TLB (Translation Lookaside Buffer)
Android verwendet virtuellen Arbeitsspeicher. Für jeden Speicherzugriff muss eine virtuelle Adresse in eine physische Adresse übersetzt werden. Der TLB ist ein spezieller Cache, in dem aktuelle Übersetzungen gespeichert werden. Bei einem TLB-Fehler muss der Kernel Seitentabellen im Hauptspeicher durchlaufen, was im Vergleich zu einem TLB-Treffer ein relativ teurer Vorgang ist.
Hardwareprofil: Pixel 10 Pro Fold
Für die folgenden Übungen haben wir ein Pixel 10 Pro Fold-Hardwaregerät verwendet. Dieses Gerät ist mit einem Google Tensor G5-SoC ausgestattet.
Hardware abfragen
Um das Speichersubsystem zu verstehen, sehen wir uns zuerst die CPU-Konfiguration und die Cache-Parameter an.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
CPU-Teile dekodieren
Die CPU part-Werte in /proc/cpuinfo sind hexadezimale Kennungen für ARM-CPU-Cores. Für den Laguna-SoC im Pixel 10 Pro Fold gilt Folgendes:
0xd8b: ARM Cortex-A520 (Effizienzkern)0xd90: ARM Cortex-A720 (Leistungskerne)0xd8c: ARM Cortex-X4 (Prime-Core)
Diese 4+3+1-Konfiguration ist in modernen mobilen SoCs üblich, da verschiedene Cluster unterschiedliche Cachegrößen und ‑latenzen haben können.
Arten von Orten
Ein effizientes Softwaredesign basiert auf zwei Haupttypen von Lokalität:
- Räumliche Lokalität: Wenn auf einen Speicherort zugegriffen wird, wird wahrscheinlich bald auch auf nahegelegene Speicherorte zugegriffen. Ein klassisches Beispiel ist das sequenzielle Durchlaufen eines Arrays. Da die CPU eine ganze Cachezeile lädt, ist der Zugriff auf das nächste Element in einem Array fast „kostenlos“, wenn es sich bereits in der Cachezeile befindet.
- Zeitliche Lokalität: Wenn auf einen Speicherort zugegriffen wird, wird wahrscheinlich bald wieder auf denselben Ort zugegriffen. Bei guten Algorithmen werden Daten wiederverwendet, solange sie noch „heiß“ im Cache sind.
Praxisübung: Lokalität mit Simpleperf messen
In dieser Übung verwenden wir simpleperf, um Hardware-Leistungszähler zu beobachten, während zwei verschiedene Durchläufe einer 256 MB großen Matrix ausgeführt werden.
- Zeilenweise Durchlauf: Auf die Matrixelemente wird in der Reihenfolge zugegriffen, in der sie im Arbeitsspeicher gespeichert sind. Das ist cachefreundlich und nutzt die räumliche Lokalität.
- Spaltenweise Durchlauf: Es wird im Speicher gesprungen, um auf Elemente nach Spalte zuzugreifen. Dabei werden häufig der Cache und der TLB nicht gefunden, was zu einem Stillstand der CPU führt.
1. Mit Simpleperf ausführen
Stellen Sie das Binärprogramm bereit, achten Sie darauf, dass es ausführbar ist, und verwenden Sie simpleperf stat, um Cache- und TLB-Ereignisse zu messen. Wir verwenden das Suffix :u, um Ereignisse im Nutzerbereich zu messen.
Für diese Befehle ist adb root erforderlich, um auf den meisten Geräten auf PMU-Hardwarezähler zuzugreifen.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
Profil – Zeilenweise:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
Profil – spaltenweise:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. Beispielmessungen (Pixel 10 Pro Fold)
Die folgenden Ergebnisse wurden auf einem Pixel 10 Pro Fold-Hardwaregerät gemessen:
| Messwert | Zeilenweise (freundlich) | Spaltenweise (nicht benutzerfreundlich) | Differenz |
|---|---|---|---|
| Ausführungszeit | 0,83 Sekunden | 68,3 Sekunden | ~82-mal langsamer |
| Anleitung | 5,27 Milliarden | 10,20 Milliarden | ca.1,9-mal mehr |
| CPU-Zyklen | 1,20 Milliarden | 62,18 Milliarden | ~52-mal mehr |
| Instructions Per Cycle (IPC) | 4,40 | 0,16 | 27-mal geringere Effizienz |
| L1-Daten-Cache-Fehler | 210 Millionen | 3.369 Millionen | 16-mal mehr verpasste Anrufe |
| dTLB Load Misses | 0,13 Millionen | 2.888 Millionen | 22.000-mal mehr verpasste Anrufe |
3. Ergebnisse analysieren
- IPC-Absturz: Im zeilenorientierten Test erreicht die CPU einen IPC von 4,40, was darauf hindeutet, dass sie mehrere Befehle pro Zyklus effizient ausführt. Im spaltenorientierten Test sinkt der IPC auf 0, 16. Das bedeutet, dass die CPU 96% der Zeit im Leerlauf ist und darauf wartet, dass Daten aus dem DRAM eintreffen.
- TLB-Engpass: Der größte Unterschied besteht bei dTLB-load-misses. Beim sequenziellen Zugriff (zeilenweise) wird auf dieselben Speicherseiten zugegriffen, was zu sehr wenigen TLB-Fehlern führt. Wenn Sie spaltenweise (spaltenweise) durch die Spalten springen, muss die CPU ständig auf neue Seiten verweisen, was den TLB überfordert und kostspielige Page-Table-Walks erzwingt.
- Cache-Effizienz: Beim spaltenweisen Durchlauf treten 16-mal mehr L1-Cache-Fehler auf, sodass die CPU ständig Daten aus dem viel langsameren L3- oder DRAM-Cache abrufen muss.
Beobachtung:Obwohl bei beiden Durchläufen dieselbe logische Operation für dieselben Daten ausgeführt wurde, war der spaltenweise Durchlauf über 80 Mal langsamer. Dieser enorme Unterschied ist ausschließlich darauf zurückzuführen, wie das Zugriffsmuster mit der physischen Realität des Speichersubsystems der CPU interagiert.
Pointer Chasing in Java- und Kotlin-Datenstrukturen
Während der 2D-Matrix-Benchmark die räumliche Lokalität in zusammenhängenden nativen Arrays demonstriert, wird der Großteil des Android-Anwendungs- und Framework-Codes in Java und Kotlin geschrieben. In verwalteten Sprachen werden Objektvariablen und Sammlungselemente nicht inline gespeichert, sondern es werden Verweise (Pointer) auf Heap-zugewiesene Objekte gespeichert, die über den ART-Heap verteilt sind.
Kosten für verschachtelte Referenzdiagramme
Ein häufiges Muster in Android-Apps und Systemdiensten ist das Durchlaufen verschachtelter Sammlungen wie einer ArrayList von Statusobjekten, die jeweils eine ArrayMap oder ArraySet von Listenern oder Verbindungen enthalten, die jeweils auf einen anderen Statusdatensatz verweisen.
Auch wenn ArrayList, ArrayMap und ArraySet ihre internen Object[]-Arrays zusammenhängend speichern, ist jedes Element in diesem Object[] weiterhin ein Heap-Verweis. Für das Dereferenzieren einer Kette wie process.services.valueAt(i).connections.valueAt(j).client sind fünf aufeinanderfolgende abhängige Speicherladevorgänge erforderlich:
- Laden Sie die
Object[]Sicherungservices. - Laden Sie den Header und die Felder des
ServiceRecord-Objekts. - Laden Sie die
Object[]Sicherungconnections. - Laden Sie das Objekt
ConnectionRecord. - Laden Sie das Zielfeld
ProcessRecord.
Da die Speicheradresse jedes Ladevorgangs vom Wert des vorherigen Ladevorgangs abhängt, können die Out-of-Order-Ausführungs-Engine und der Hardware-Prefetcher der CPU die Ladevorgänge nicht überlappen. Wenn diese Objekte zu unterschiedlichen Zeiten zugewiesen oder während der automatischen Speicherbereinigung in andere Regionen verschoben wurden, besteht bei jedem Hop das Risiko eines L1- oder L2-Cache-Fehlers.
Gekapselte Primitiven (ArrayList<Integer>, HashMap<Long, Boolean>) und generische Lambdas verstärken diesen Mehraufwand: Für jede Elementsuche ist eine zusätzliche Dereferenzierung des Zeigers erforderlich, um den Wert zu entpacken. Generische Consumer<T>-Rückrufe fügen Stubs für die Laufzeittypüberprüfung (CheckCast) ein, die den Befehls-Cache (L1-icache) belasten.
Pointer Chasing mit simpleperf diagnostizieren
Bei realen Java- und Kotlin-Arbeitslasten (z. B. beim Durchlaufen von Prozess-, Dienst- und Anbieterreferenzdiagrammen von system_serverOomAdjuster) sinkt die IPC durch Pointer Chasing selten auf 0,16 wie bei einem synthetischen spaltenweisen Scan von 256 MB, da ein Teil des Arbeitssets in den L2- oder L3-Cache passt.
Suchen Sie stattdessen in simpleperf nach dieser charakteristischen Signatur:
- Niedriger IPC (ca. 0,6 bis 0,9): Deutlich unter der superskalaren Retire-Breite der CPU.
- Hohe Anzahl von Backend-Speicher-Stalls (
raw-stall-backend-mem): Häufig werden 35% bis 45 % aller CPU-Zyklen mit dem Warten auf das Füllen des Datencache verbracht. - Erhöhte
L1-dcache-load-misses- undL1-icache-load-misses-Werte: Hohe Daten-Cache-Fehlerraten in Kombination mit Instruction-Cache-Fehlern, wenn Hot-Traversal-Schleifen über virtuelle Methoden und generische Lambda-Stubs springen.
Sie können diese Zähler für einen laufenden Prozess mit simpleperf stat messen:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
Lokalität in verwaltetem Code verbessern
- Boxed-Sammlungen durch primitive Arrays oder AndroidX-Sammlungen ersetzen: Verwenden Sie die Primitiven
IntArray,LongArray,SparseIntArrayoderandroidx.collection(IntList,LongLongMap,ScatterMap), um Wrapper-Objekte zu entfernen und Werte in einer einzelnen Array-Zuweisung zusammenhängend zu halten. - Häufig genutzte Pfade vereinfachen: Wenn in einer häufig genutzten Schleife wiederholt drei oder vier Hops in einem Objektgraphen ausgeführt werden, um ein einzelnes boolesches oder ganzzahliges Flag zu lesen, sollten Sie diesen Status in ein flaches Array oder eine Bitmaske verschieben oder zwischenspeichern, die nach einer dichten ID indexiert wird.
- Vermeiden Sie das Erfassen oder generische Lambdas in engen inneren Schleifen: Verwenden Sie standardmäßige indexierte
for-Schleifen fürRandomAccess-Listen anstelle vonforEach- oder Iteratorketten, um Iteratorzuweisungen, megamorphe Dispatch- und Laufzeittypüberprüfungs-Overhead zu vermeiden.
← Threads | ↑ Nach oben | Dienstverknüpfungen →