

While memory is often thought of as a single, uniform pool of storage, its physical organization and the way the CPU accesses it have a profound impact on application performance. درک کردن محلی بودن حافظه کلید نوشتن کد با عملکرد بالا است که بهطور کارآمد از سلسلهمراتب حافظه نهان CPU استفاده میکند.
سلسله مراتب حافظه نهان واحد پردازش مرکزی
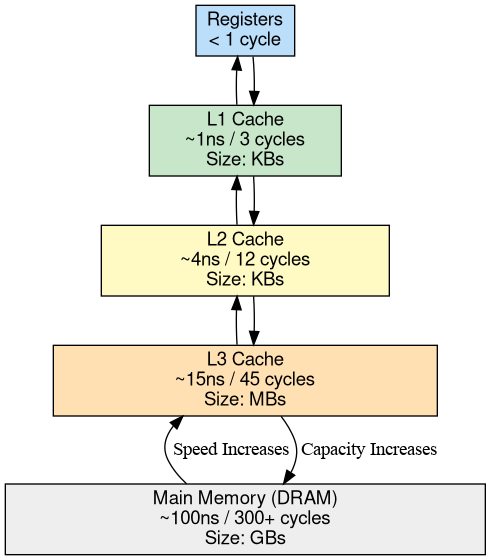
یک CPU مدرن تلفن همراه بسیار سریعتر از RAM اصلی سیستم (DRAM) است. برای پر کردن این شکاف عملکردی، CPUها از چند سطح حافظه کوچک و بسیار سریع به نام حافظه نهان استفاده میکنند.
- حافظه نهان L1 (سطح ۱): کوچکترین و سریعترین (حدود ۱ نانوثانیه). در یک واحد پردازش مرکزی ۳ گیگاهرتزی، این حدود ۳ چرخه ساعت است.
- حافظه نهان L2 (سطح ۲): بزرگتر و کمی کندتر (حدود ۳ تا ۵ نانوثانیه، یا حدود ۱۰ تا ۱۵ چرخه).
- حافظه نهان L3 (سطح ۳): بزرگترین حافظه نهان (~۱۰-۲۰ نانوثانیه، یا ~۳۰-۶۰ چرخه).
- حافظه اصلی (DRAM): بزرگترین و کندترین (بیشاز ۱۰۰ نانوثانیه، یا بیشاز ۳۰۰ چرخه).
زمینهسازی تأخیر: هزینه توقف
برای درک تأثیر این اعداد، یک CPU سوپراسکالر مدرن را درنظر بگیرید که میتواند ۴ تا ۸ دستورالعمل را در هر چرخه ساعت بازنشسته کند.
اگر CPU همه حافظههای پنهان را ازدست بدهد و باید ۱۰۰ نانوثانیه (۳۰۰ چرخه) برای خواندن DRAM منتظر بماند:
- چرخههای ازدسترفته: حدود ۳۰۰ چرخه.
- دستورالعملهای «هدررفته»: بین ۱٬۲۰۰ تا ۲٬۴۰۰ دستورالعمل که اگر دادهها ازقبل در ثبات محلی یا حافظه پنهان L1 بودند، میتوانستند اجرا شوند.
وقتی کد شما محلیت حافظه ضعیفی دارد، واحد پردازش مرکزی لزوماً مشغول ریاضیات پیچیده نیست؛ بلکه اغلب «متوقف» میشود و برای هزاران معادل دستورالعمل درحالیکه منتظر زیرسیستم حافظه است، بیکار میماند.
دستورالعمل در هر چرخه (IPC)
یکی از سنجههای کلیدی برای اندازهگیری این کارایی دستورالعملها در هر چرخه (IPC) است. IPC نشاندهنده تعداد دستورالعملهایی است که واحد پردازش مرکزی بهطور میانگین درطول هر چرخه ساعت با موفقیت «بازنشسته» (تکمیل) میکند.
- دستورالعمل در هر چرخه بالا (مثلاً ۳٫۰ تا ۵٫۰): واحد پردازش مرکزی با کارایی بالا کار میکند، احتمالاً بیشتر دادههایش را در حافظههای نهان L1/L2 یا ثباتها پیدا میکند.
- دستورالعمل در هر چرخه پایین (مثلاً کمتر از ۰٫۵): واحد پردازش مرکزی بهشدت دچار گلوگاه شده است. حتی اگر CPU در پایشگرهای سیستم در وضعیت «استفاده» ۱۰۰٪ باشد، درواقع بیشتر وقت آن صرف انتظار برای حافظه میشود—وضعیتی که بهعنوان توقف حافظه شناخته میشود.
محلی بودن حافظه عامل اصلی تعیینکننده این است که آیا یک حلقه دادهمحور با IPC بالا اجرا میشود یا به مجموعهای از توقفها تبدیل میشود.
خطوط حافظه نهان
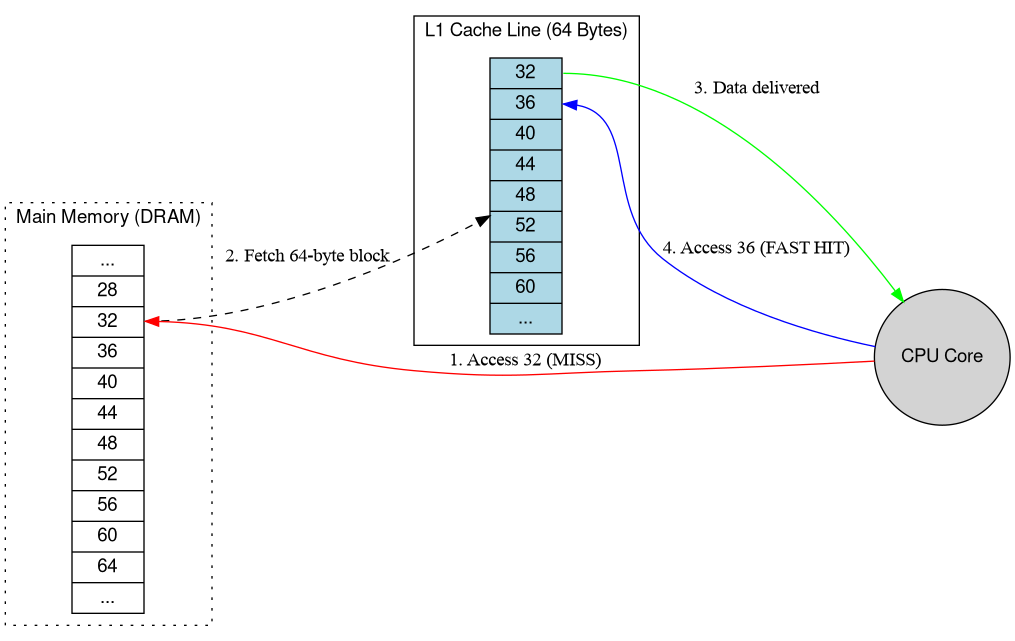
واحد پردازش مرکزی بایتهای تکی را از حافظه بار نمیکند. درعوض، بلوکهای با اندازه ثابت را بار میکنند که خطوط حافظه نهان نامیده میشوند و معمولاً ۶۴ بایت هستند. وقتی به یک متغیر تکی دسترسی پیدا میکنید، CPU کل قطعه ۶۴ بایتی حاوی آن را به حافظه پنهان منتقل میکند.
TLB (میانگیر جستجوی ترجمه)
Android از حافظه مجازی استفاده میکند. هر دسترسی به حافظه مستلزم ترجمه نشانی مجازی به نشانی فیزیکی است. TLB حافظه پنهان تخصصی است که ترجمههای اخیر را ذخیره میکند. خطای TLB مستلزم این است که هسته جدولهای صفحه را در حافظه اصلی پیمایش کند که درمقایسه با موفقیت TLB، عملیاتی نسبتاً پرهزینه است.
نمایه سختافزاری: Pixel 10 Pro Fold
برای تمرینهای زیر، از دستگاه سختافزاری Pixel 10 Pro Fold استفاده کردیم. این دستگاه دارای یک Google Tensor G5 SoC است.
درحال بازجویی از سختافزار
برای درک زیرسیستم حافظه، ابتدا پیکربندی واحد پردازش مرکزی و پارامترهای حافظه نهان را بررسی میکنیم.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
رمزگشایی بخشهای CPU
مقادیر CPU part در /proc/cpuinfo شناسههای شانزدهشانزدهی برای هستههای
واحد پردازش مرکزی ARM هستند. برای Laguna SoC موجود در Pixel 10 Pro Fold، این موارد به این صورت نگاشت میشوند:
0xd8b: ARM Cortex-A520 (هستههای کارایی)0xd90: ARM Cortex-A720 (هستههای عملکرد)0xd8c: ARM Cortex-X4 (هسته اصلی)
این پیکربندی ۱+۳+۴ در SoCهای مدرن تلفن همراه رایج است، جایی که خوشههای مختلف ممکن است اندازههای حافظه پنهان و تأخیرهای متفاوتی داشته باشند.
انواع محل
طراحی نرمافزار کارآمد به دو نوع اصلی از محلیسازی متکی است:
- محلیت فضایی: اگر به یک مکان حافظه دسترسی پیدا شود، احتمالاً بهزودی به مکانهای حافظه نزدیک نیز دسترسی پیدا خواهد شد. پیمایش آرایه ترتیبی نمونه کلاسیک آن است. چون CPU کل خط حافظه نهان را بار میکند، دسترسی به عنصر بعدی در آرایه تقریباً «رایگان» است اگر ازقبل در خط حافظه نهان باشد.
- محل زمانی: اگر به یک مکان حافظه دسترسی پیدا شود، احتمالاً بهزودی دوباره به همان مکان دسترسی پیدا خواهد شد. الگوریتمهای خوب از دادهها درحالیکه هنوز در حافظه نهان «داغ» هستند، دوباره استفاده میکنند.
تمرین عملی: اندازهگیری محلی بودن با simpleperf
در این تمرین، از simpleperf برای نظارت بر شمارندههای عملکرد سختافزار درحین اجرای دو پیمایش مختلف از ماتریس ۲۵۶ مگابایتی استفاده خواهیم کرد.
- پیمایش ردیف-اصلی: به عناصر ماتریس به ترتیبی که در حافظه ذخیره شدهاند دسترسی پیدا میکند. این روش با حافظه پنهان سازگار است و از محلیسازی فضایی بهره میبرد.
- پیمایش ستونمحور: برای دسترسی به عناصر براساس ستون، در حافظه جابهجا میشود. این امر اغلب باعث میشود حافظه پنهان و TLB ازدست برود و CPU متوقف شود.
۱. اجرا با Simpleperf
باینری را ارسال کنید، مطمئن شوید که قابلاجرا است، و از simpleperf stat برای اندازهگیری
رویدادهای حافظه نهان و TLB استفاده کنید. ما از پسوند :u برای اندازهگیری رویدادها در فضای کاربر استفاده میکنیم.
این فرمانها در اکثر دستگاهها به adb root نیاز دارند تا به شمارندههای PMU سختافزار دسترسی پیدا کنند.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
نمایه Row-major:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
نمایه ستون-محور:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
۲. اندازهگیریهای نمونه (Pixel 10 Pro Fold)
نتایج زیر در دستگاه سختافزاری Pixel 10 Pro Fold اندازهگیری شده است:
| متریک | ردیف-اصلی (دوستانه) | ستون-اصلی (نامناسب) | تفاوت |
|---|---|---|---|
| زمان اجرا | ۰٫۸۳ ثانیه | ۶۸٫۳ ثانیه | ~۸۲ برابر کندتر |
| دستورالعمل | ۵٫۲۷ میلیارد | ۱۰٫۲۰ میلیارد | تقریباً ۱٫۹ برابر بیشتر |
| چرخههای CPU | ۱٫۲۰ میلیارد | ۶۲٫۱۸ میلیارد | ~۵۲ برابر بیشتر |
| دستورالعمل در هر چرخه (IPC) | ۴٫۴۰ | ۰٫۱۶ | ۲۷ برابر کارایی کمتر |
| L1 Data Cache Misses | ۲۱۰ میلیون | ۳٬۳۶۹ میلیون | ۱۶ برابر موارد ازدسترفته بیشتر |
| dTLB Load Misses | ۰٫۱۳ میلیون | ۲٬۸۸۸ میلیون | ۲۲٬۰۰۰ برابر موارد ازقلمافتاده بیشتر |
۳. تحلیل نتایج
- The IPC Crash: در آزمایش ردیفمحور، واحد پردازش مرکزی به IPC ۴٫۴۰ دست مییابد، که نشان میدهد بهطور کارآمدی چندین دستورالعمل را در هر چرخه اجرا میکند. در آزمایش ستونمحور، IPC به ۰٫۱۶ کاهش مییابد. این یعنی CPU ۹۶٪ مواقع متوقف شده است و منتظر است تا دادهها از DRAM برسند.
- گلوگاه TLB: چشمگیرترین تفاوت در dTLB-load-misses است. دسترسی متوالی (سطر-اصلی) در همان صفحات حافظه باقی میماند، که منجر به تعداد بسیار کمی از دست رفتن TLB میشود. پرش بین ستونها (ستون-اصلی) باعث میشود CPU دائماً به صفحههای جدید ارجاع دهد، که این امر TLB را تحت فشار قرار میدهد و منجر به پیمایشهای پرهزینه جدول صفحه میشود.
- کارایی حافظه پنهان: پیمایش ستونمحور ۱۶ برابر بیشتر خطای حافظه پنهان L1 ایجاد میکند و واحد پردازش مرکزی را مجبور میکند تا بهطور مداوم دادهها را از حافظه پنهان L3 یا DRAM بسیار کندتر واکشی کند.
مشاهده: بااینکه هر دو پیمایش عملیات منطقی یکسانی را روی دادههای یکسان انجام دادند، پیمایش ستونمحور بیشاز ۸۰ برابر کندتر بود. این تفاوت عظیم کاملاً بهدلیل نحوه تعامل الگوی دسترسی با واقعیت فیزیکی زیرسیستم حافظه CPU است.
تعقیب اشارهگر در ساختارهای داده Java و Kotlin
درحالیکه محک ماتریس دوبعدی محلیسازی فضایی را در آرایههای بومی مجاور نشان میدهد، اکثر کدهای برنامه و چارچوب Android به زبان Java و Kotlin نوشته شدهاند. در زبانهای مدیریتشده، متغیرهای شیء و عناصر مجموعه اشیاء را بهصورت درونخطی ذخیره نمیکنند؛ آنها ارجاعها (اشارهگرها) را به اشیاء اختصاصیافته به توده که در سراسر توده ART پراکنده شدهاند ذخیره میکنند.
هزینه نمودارهای مرجع تودرتو
الگوی رایجی را در برنامههای Android و سرویسهای سیستم درنظر بگیرید: پیمایش
مجموعههای تودرتو مانند ArrayList از اشیای وضعیت، که هرکدام حاوی
ArrayMap یا ArraySet از شنوندگان یا اتصالات هستند، و هرکدام به رکورد وضعیت دیگری
اشاره میکنند.
اگرچه ArrayList، ArrayMap، و ArraySet آرایههای داخلی Object[] خود را بهصورت متوالی ذخیره میکنند، هر عنصر در آن Object[] همچنان یک مرجع پشته است. ارجاعزدایی زنجیرهای مانند
process.services.valueAt(i).connections.valueAt(j).client به پنج
بارگذاری حافظه وابسته متوالی نیاز دارد:
Object[]پشتیبانservicesرا بار کنید.- سرصفحه و فیلدهای شیء
ServiceRecordرا بار کنید. Object[]پشتیبانconnectionsرا بار کنید.- شیء
ConnectionRecordرا بار کنید. - فیلد
ProcessRecordهدف را بار کنید.
چون نشانی حافظه هر بارگذاری به مقدار برگرداندهشده توسط بارگذاری قبلی بستگی دارد، موتور اجرای نامرتب CPU و پیشواکشی سختافزار نمیتوانند آنها را همپوشانی کنند. اگر آن اشیاء در زمانهای مختلف اختصاص داده شده باشند یا درطول جمعآوری زباله به مناطق مختلف منتقل شده باشند، هر پرش با خطر ازدست رفتن حافظه نهان L1 یا L2 مواجه میشود.
Boxed primitives (ArrayList<Integer>, HashMap<Long, Boolean>) and generic
lambdas compound this overhead: every element lookup requires an extra pointer
dereference to unbox the value, and generic Consumer<T> callbacks insert
runtime type-check (CheckCast) stubs that add instruction cache (L1-icache)
pressure.
درحال عیبیابی تعقیب اشارهگر با simpleperf
در حجمهای کاری واقعی Java و Kotlin (مانند
OomAdjuster پیمایش فرایند، سرویس، و نمودارهای مرجع ارائهدهنده system_server)،
تعقیب اشارهگر بهندرت IPC را تا ۰٫۱۶ کاهش میدهد، مانند اسکن ستونمحور مصنوعی ۲۵۶ مگابایتی،
زیرا بخشی از مجموعه کاری در حافظه پنهان L2 یا L3 جا میشود.
درعوض، این امضای مشخصه را در simpleperf جستجو کنید:
- IPC کاهشیافته (حدود ۰٫۶ تا ۰٫۹): بسیار پایینتر از پهنای بازنشستگی سوپراسکالر CPU.
- توقفهای زیاد حافظه پسنهایی (
raw-stall-backend-mem): اغلب ۳۵٪ تا ۴۵٪ از کل چرخههای CPU صرف انتظار برای پر شدن حافظه نهان داده میشود. L1-dcache-load-missesوL1-icache-load-missesبالا: نرخ بالای عدم دسترسی به حافظه نهان داده همراه با عدم دسترسی به حافظه نهان دستورالعمل زمانی که حلقههای پیمایش داغ بین روشهای مجازی و کدهای آماده لامبدا عمومی جابهجا میشوند.
میتوانید این شمارندهها را در فرایند درحال اجرا بااستفاده از simpleperf stat اندازهگیری کنید:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
بهبود محلیسازی در کد مدیریتشده
- مجموعههای جعبهای را با آرایههای اولیه یا مجموعههای AndroidX جایگزین کنید:
از
IntArray،LongArray،SparseIntArray، یاandroidx.collectionاولیه (IntList،LongLongMap،ScatterMap) برای حذف اشیای پوشاننده و حفظ مقادیر پیوسته در یک تخصیص آرایه استفاده کنید. - مسیرهای پیمایش داغ را مسطح کنید: اگر یک حلقه داغ بهطور مکرر سه یا چهار گام در یک گراف شیء حرکت میکند تا یک پرچم بولی یا عدد صحیح را بخواند، آن حالت را به یک آرایه مسطح یا ماسک بیتی که با یک شناسه متراکم نمایهسازی شده است، منتقل یا ذخیره کنید.
- از ضبط یا لامبداهای عمومی در حلقههای داخلی تنگ اجتناب کنید: از حلقههای نمایهشده استاندارد
forروی فهرستهایRandomAccessبهجایforEachیا زنجیرههای تکرارکننده استفاده کنید تا از تخصیص تکرارکننده، ارسال مگامورفیک، و سربار بررسی نوع زمان اجرا اجتناب کنید.
← رشتهها | ↑ بالا | اتصالهای سرویس →