

Android menawarkan dukungan bawaan untuk SQLite, database SQL yang efisien. Ikuti praktik terbaik ini untuk mengoptimalkan performa aplikasi Anda, memastikannya tetap cepat dan dapat diprediksi dengan cepat seiring pertumbuhan data Anda. Dengan menggunakan praktik terbaik ini, Anda juga mengurangi kemungkinan terjadinya masalah performa yang sulit direproduksi dan dipecahkan.
Untuk mencapai performa yang lebih cepat, ikuti prinsip performa berikut:
Membaca lebih sedikit baris dan kolom: Optimalkan kueri untuk mengambil data yang diperlukan saja. Minimalkan jumlah data yang dibaca dari database, karena pengambilan data yang berlebihan dapat memengaruhi performa.
Mendorong tugas ke mesin SQLite: Lakukan operasi komputasi, pemfilteran, dan pengurutan dalam kueri SQL. Menggunakan mesin kueri SQLite dapat meningkatkan performa secara signifikan.
Mengubah skema database: Desain skema database Anda untuk membantu SQLite membuat rencana kueri dan representasi data yang efisien. Indeks tabel dengan benar dan optimalkan struktur tabel untuk meningkatkan performa.
Selain itu, Anda dapat menggunakan alat pemecahan masalah yang tersedia untuk mengukur performa database SQLite untuk membantu mengidentifikasi area yang memerlukan pengoptimalan.
Sebaiknya gunakan library Jetpack Room.
Mengonfigurasi database untuk meningkatkan performa
Ikuti langkah-langkah di bagian ini untuk mengonfigurasi database Anda agar performanya optimal di SQLite.
Mengaktifkan Write-Ahead Logging
SQLite menerapkan mutasi dengan menambahkannya ke log, yang terkadang dipadatkan ke dalam database. Tindakan ini disebut Write-Ahead Logging (WAL).
Aktifkan WAL
kecuali jika Anda menggunakan ATTACH DATABASE.
Aktifkan WAL melalui framework, bukan menjalankan PRAGMA journal_mode=WAL
sendiri. Room mengaktifkan WAL secara default di perangkat yang bukan perangkat dengan RAM rendah.
Tanpa Room, gunakan salah satu dari berikut ini:
- Metode
enableWriteAheadLogging - Flag terbuka
ENABLE_WRITE_AHEAD_LOGGING - Metode
setWriteAheadLoggingEnableddariSQLiteOpenHelper
Saat framework mengetahui bahwa database menggunakan WAL, framework akan membuka kumpulan
koneksi sehingga operasi baca dapat berjalan secara serentak dengan operasi tulis, dan menerapkan
mode sinkron WAL yang dijelaskan di bagian berikutnya. Jika Anda menjalankan
PRAGMA journal_mode=WAL sendiri, framework akan tetap memperlakukan database sebagai
database rollback journal. Mode ini menggunakan satu koneksi, dan commit mempertahankan mode sinkron FULL default.
Melonggarkan mode sinkronisasi
SQLite memiliki opsi untuk mengontrol mode sinkron. Dalam mode FULL, setiap
commit akan mengeluarkan fsync untuk membantu memastikan bahwa data mencapai disk. Hal ini meningkatkan ketahanan data, tetapi memperlambat commit Anda. Dengan WAL, mode NORMAL
tidak disinkronkan pada setiap commit dan tetap melindungi database dari
kerusakan.
Saat Anda mengaktifkan WAL melalui framework, Android akan menerapkan mode sinkron WAL default perangkat, yaitu NORMAL di AOSP untuk Android 9 dan yang lebih tinggi.
Produsen perangkat dapat mengubah default ini, dan database yang tidak menggunakan WAL
akan ditetapkan secara default ke FULL. Untuk memastikan database Anda menggunakan NORMAL, tetapkan saat Anda membuka database:
// When opening the database
val params = SQLiteDatabase.OpenParams.Builder()
    .addOpenFlags(SQLiteDatabase.ENABLE_WRITE_AHEAD_LOGGING)
    // SYNC_MODE_NORMAL is available in API level 33 and higher.
    // On API levels 28 to 32, pass "NORMAL" instead.
    .setSynchronousMode(SQLiteDatabase.SYNC_MODE_NORMAL)
    .build()
// With SQLiteOpenHelper, call setOpenParams(params) in your constructor.

// Or: after having opened the database
db.execSQL("PRAGMA synchronous = NORMAL")
Di setelan ini, commit dapat ditampilkan sebelum data disimpan di disk. Jika penonaktifan perangkat terjadi, misalnya karena kehilangan daya atau kernel panic, data yang di-commit bisa saja hilang. Namun, karena logging, database Anda tidak rusak.
Jika hanya aplikasi Anda yang error, data akan tetap masuk ke disk. Untuk sebagian besar aplikasi, setelan ini menghasilkan peningkatan performa tanpa biaya material.
Mengelola koneksi dan memori
Setiap koneksi database yang terbuka menyimpan memori SQLite: cache halaman, pengalokasi lookaside, dan cache pernyataan yang dikompilasi. Halaman file database juga tetap berada di cache halaman kernel. Ikuti praktik di bagian ini untuk menjaga memori ini tetap terkendali tanpa memperlambat kueri Anda.
Buka setiap database satu kali
Gunakan satu instance SQLiteOpenHelper atau RoomDatabase per file database
untuk seluruh proses Anda, misalnya dengan menjadikannya singleton. Setiap instance memiliki
kumpulan koneksi, cache halaman, dan cache pernyataan sendiri, dan dua instance
yang membuka file yang sama tidak dapat membagikannya. Dalam satu benchmark, menggabungkan dua
helper yang membuka file yang sama menjadi satu akan mengurangi memori cache halaman SQLite
hampir setengahnya dan mengurangi latensi kueri p95 lebih dari setengahnya.
Untuk menemukan instance duplikat, periksa dumpsys dbinfo untuk jalur database yang sama di bawah lebih dari satu judul Connection pool for.
Menjaga perubahan skema di luar callback terbuka
Callback onOpen dari SQLiteOpenHelper berjalan setiap kali database
dibuka, begitu juga callback onOpen dari RoomDatabase.Callback. Tempatkan
pernyataan seperti CREATE TABLE IF NOT EXISTS dan CREATE INDEX IF NOT EXISTS
di onCreate dan onUpgrade, atau di migrasi Room. Jangan panggil
setVersion di onOpen, karena SQLiteOpenHelper sudah menetapkan versi
setelah onCreate dan onUpgrade. Meskipun skema sudah ada, pernyataan ini tetap berjalan pada setiap pembukaan, dan setVersion menulis ke file database.
Menentukan ukuran cache pernyataan yang disiapkan
Android meng-cache pernyataan yang dikompilasi untuk setiap koneksi. Cache menyimpan 25 pernyataan secara default, dan Anda dapat menaikkannya hingga MAX_SQL_CACHE_SIZE (100) dengan setMaxSqlCacheSize. Jika database
menjalankan lebih dari 25 pernyataan berbeda di jalur panasnya, cache akan mengalami thrashing dan
SQLite akan mengompilasi pernyataan yang sama berulang kali.
Pertama, buat parameter kueri Anda. Tidak ada ukuran cache yang dapat membantu SQL yang dibuat dengan penyambungan string, karena setiap string adalah pernyataan baru. Kemudian, periksa cache ditemukan dan cache tidak ditemukan pernyataan di bagian POOL STATS di
dumpsys meminfo. Misalnya, database phenotype.db
dalam contoh output bagian tersebut memiliki 147.921 hit dan 89.616 miss, yang merupakan
rasio miss 38%. Meningkatkan ukuran cache pada database seperti ini dapat menghapus
hampir semua kesalahan. Setiap pernyataan yang di-cache menggunakan beberapa kilobyte memori.
Untuk meningkatkan ukuran cache, ganti onConfigure di subclass SQLiteOpenHelper Anda:
override fun onConfigure(db: SQLiteDatabase) {
    db.setMaxSqlCacheSize(SQLiteDatabase.MAX_SQL_CACHE_SIZE)
}
Jika Anda menggunakan Room, panggil metode yang sama pada SupportSQLiteDatabase di
callback onOpen dari RoomDatabase.Callback.
Menutup database yang tidak ada aktivitas, tetapi tetap membuka database yang sibuk
Database yang terbuka akan mempertahankan koneksi, cache, dan deskriptor filenya meskipun tidak aktif. Dalam satu benchmark, database Room yang tidak ada aktivitas dalam mode WAL yang tetap terbuka menyimpan sekitar 678 KB memori cache halaman SQLite dan 5 deskriptor file. Jika Anda hanya menggunakan database sesekali, misalnya selama sinkronisasi harian, tutup database setelah selesai.
Untuk menutup database yang tidak ada aktivitas dengan aman, ikuti panduan berikut:
- Room dapat menutup database yang tidak ada aktivitas untuk Anda dengan
setAutoCloseTimeout, yang merupakan API eksperimental. Room akan membuka kembali database pada akses berikutnya dan menjalankan callbackonOpenAnda lagi, jadi tempatkan konfigurasi koneksi di sana. - Hindari metode
setIdleConnectionTimeoutdariSQLiteOpenHelperdanSQLiteDatabase.OpenParams.Builder. Metode ini tidak digunakan lagi di level API 29 karena menutup koneksi tanpa memulihkan setelan yang Anda terapkan dengan pernyataanPRAGMA. - Jangan tutup database yang Anda kueri setiap beberapa detik. Waktu tunggu yang lebih singkat daripada jeda antara kueri Anda akan membuat database ditutup dan dibuka kembali berulang kali, sehingga cache halaman dan cache pernyataan akan dihapus setiap kali dan membuat kueri berikutnya menjadi lebih lambat.
Memperhitungkan memori SQLite
Memori SQLite mungkin sulit dikenali. Cache halaman dan cache pernyataan SQLite adalah
alokasi heap native. Namun, Android tidak mengaktifkan I/O yang dipetakan memori dari SQLite secara default, sehingga SQLite membaca file database dengan pembacaan file reguler, dan konten file yang di-cache kernel adalah halaman file yang tidak dipetakan. Proses ini tidak
diperhitungkan dalam PSS aplikasi Anda di dumpsys meminfo. Pada perangkat yang menggunakan akuntansi memori
cgroup v2, kernel masih membebankan halaman ini ke cgroup memori
aplikasi Anda. Untuk mengurangi jejak tersembunyi ini, baca lebih sedikit halaman dengan menggunakan indeks dan hanya membaca baris dan kolom yang Anda butuhkan. Menutup database yang tidak diperlukan
juga akan mengosongkan cache SQLite-nya.
Menentukan skema tabel yang efisien
Untuk mengoptimalkan performa dan meminimalkan konsumsi data, tentukan skema tabel yang efisien. SQLite membuat data dan rencana kueri yang efisien, yang mengarah ke pengambilan data yang lebih cepat. Bagian ini memberikan praktik terbaik untuk membuat skema tabel.
Pertimbangkan INTEGER PRIMARY KEY
Untuk contoh ini, tentukan dan isi tabel sebagai berikut:
CREATE TABLE Customers(
  id INTEGER,
  name TEXT,
  city TEXT
);
INSERT INTO Customers Values(456, 'John Lennon', 'Liverpool, England');
INSERT INTO Customers Values(123, 'Michael Jackson', 'Gary, IN');
INSERT INTO Customers Values(789, 'Dolly Parton', 'Sevier County, TN');
Output tabelnya adalah sebagai berikut:
| rowid | id | nama | kota |
|---|---|---|---|
| 1 | 456 | John Lennon | Liverpool, Inggris |
| 2 | 123 | Michael Jackson | Gary, IN |
| 3 | 789 | Dolly Parton | Sevier County, TN |
Kolom rowid adalah
indeks yang mempertahankan urutan penyisipan. Kueri yang
memfilter menurut rowid diimplementasikan sebagai penelusuran hierarki B yang cepat, tetapi kueri yang
memfilter menurut id merupakan pemindaian tabel yang lambat.
Jika berencana melakukan pencarian menurut id, Anda dapat menghindari penyimpanan
kolom rowid untuk mendapatkan lebih sedikit data dalam penyimpanan dan database
yang lebih cepat secara keseluruhan:
CREATE TABLE Customers(
  id INTEGER PRIMARY KEY,
  name TEXT,
  city TEXT
);
Tabel Anda sekarang terlihat seperti berikut:
| id | nama | kota |
|---|---|---|
| 123 | Michael Jackson | Gary, IN |
| 456 | John Lennon | Liverpool, Inggris |
| 789 | Dolly Parton | Sevier County, TN |
Karena Anda tidak perlu menyimpan kolom rowid, kueri id dapat dipercepat. Perhatikan
bahwa tabel kini diurutkan berdasarkan id, bukan urutan penyisipan.
Mempercepat kueri dengan indeks
SQLite menggunakan
indeks
untuk mempercepat kueri. Saat memfilter (WHERE), mengurutkan (ORDER BY), atau
menggabungkan (GROUP BY) kolom, jika tabel memiliki indeks untuk kolom tersebut, kueri akan dipercepat.
Pada contoh sebelumnya, pemfilteran menurut city mengharuskan pemindaian seluruh tabel:
SELECT id, name
WHERE city = 'London, England';
Untuk aplikasi dengan banyak kueri kota, Anda dapat mempercepat kueri tersebut dengan indeks:
CREATE INDEX city_index ON Customers(city);
Indeks diterapkan sebagai tabel tambahan, yang diurutkan berdasarkan kolom indeks dan
dipetakan ke rowid:
| kota | rowid |
|---|---|
| Gary, IN | 2 |
| Liverpool, Inggris | 1 |
| Sevier County, TN | 3 |
Perhatikan bahwa biaya penyimpanan kolom city sekarang menjadi dua kali lipat, karena kolom tersebut
kini ada di tabel asli dan indeks. Karena Anda menggunakan
indeks, biaya penyimpanan tambahan sebanding dengan keuntungannya, yaitu kueri yang lebih cepat.
Namun, jangan mempertahankan indeks yang tidak Anda gunakan agar tidak membayar
biaya penyimpanan tanpa mendapatkan peningkatan performa kueri.
Membuat indeks multi-kolom
Jika kueri menggabungkan beberapa kolom, Anda dapat membuat indeks multi-kolom untuk sepenuhnya mempercepat kueri. Anda juga dapat menggunakan indeks di kolom luar dan memungkinkan penelusuran di dalam dilakukan sebagai pemindaian linear.
Misalnya, dengan kueri berikut:
SELECT id, name
WHERE city = 'London, England'
ORDER BY city, name
Anda dapat mempercepat kueri dengan indeks multi-kolom dalam urutan yang sama seperti yang ditentukan dalam kueri:
CREATE INDEX city_name_index ON Customers(city, name);
Namun, jika Anda hanya memiliki indeks di city, pengurutan di luar tetap
dipercepat, sedangkan pengurutan di dalam memerlukan pemindaian linear.
Hal ini juga berfungsi dengan pertanyaan awalan. Misalnya, indeks
ON Customers (city, name) juga mempercepat pemfilteran, pengurutan, dan pengelompokan
menurut city, karena tabel indeks untuk indeks multi-kolom diurutkan menurut
indeks tertentu dalam urutan tertentu.
Mempertimbangkan WITHOUT ROWID
Secara default, SQLite membuat kolom rowid untuk tabel Anda, dengan rowid sebagai
INTEGER PRIMARY KEY AUTOINCREMENT implisit. Jika Anda sudah memiliki kolom yang
merupakan INTEGER PRIMARY KEY, kolom ini akan menjadi alias dari rowid.
Untuk tabel yang memiliki kunci utama selain INTEGER atau gabungan
kolom, pertimbangkan WITHOUT ROWID.
Menyimpan data kecil sebagai BLOB dan data besar sebagai file
Jika ingin mengaitkan data besar dengan baris, seperti thumbnail gambar
atau foto untuk kontak, Anda dapat menyimpan data tersebut dalam kolom BLOB atau dalam
file, lalu menyimpan jalur dalam kolom.
File biasanya dibulatkan ke atas hingga tambahan 4 KB. Untuk file yang sangat kecil, dengan
error pembulatan yang signifikan, akan lebih efisien untuk menyimpannya dalam
database sebagai BLOB. SQLite meminimalkan panggilan sistem file dan
lebih cepat daripada sistem file yang mendasarinya dalam beberapa kasus.
Meningkatkan performa kueri
Ikuti praktik terbaik ini untuk meningkatkan performa kueri di SQLite dengan meminimalkan waktu respons dan memaksimalkan efisiensi pemrosesan.
Hanya baca baris yang diperlukan
Filter memungkinkan Anda mempersempit hasil dengan menentukan kriteria tertentu, seperti rentang tanggal, lokasi, atau nama. Batas memungkinkan Anda mengontrol jumlah hasil yang dilihat:
db.rawQuery("""
    SELECT name
    FROM Customers
    LIMIT 10;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        // Process cursor data
    }
}
Hanya baca kolom yang diperlukan
Hindari memilih kolom yang tidak diperlukan, yang dapat memperlambat kueri dan membuang resource. Sebagai gantinya, hanya pilih kolom yang digunakan.
Pada contoh berikut, Anda memilih id, name, dan phone:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery(
    """
    SELECT id, name, phone
    FROM customers;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        val name = cursor.getString(1)
        // Further processing
    }
}
Namun, Anda hanya memerlukan kolom name:
db.rawQuery("""
    SELECT name
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        val name = cursor.getString(0)
        // Further processing
    }
}
Membuat parameter kueri
String kueri Anda mungkin menyertakan parameter yang hanya diketahui saat runtime, seperti berikut:
fun getNameById(id: Long): String?
    db.rawQuery(
        "SELECT name FROM customers WHERE id=$id", null
    ).use { cursor ->
        return if (cursor.moveToFirst()) {
            cursor.getString(0)
        } else {
            null
        }
    }
}
Dalam kode sebelumnya, setiap kueri membuat string yang berbeda, sehingga tidak mendapatkan manfaat dari cache pernyataan. Setiap panggilan memerlukan SQLite untuk mengompilasinya
sebelum dapat dieksekusi. Sebagai gantinya, Anda dapat mengganti argumen id dengan
parameter dan
mengikat nilai dengan selectionArgs:
fun getNameById(id: Long): String? {
    db.rawQuery(
        """
          SELECT name
          FROM customers
          WHERE id=?
        """.trimIndent(), arrayOf(id.toString())
    ).use { cursor ->
        return if (cursor.moveToFirst()) {
            cursor.getString(0)
        } else {
            null
        }
    }
}
Sekarang kueri dapat dikompilasi sekali dan di-cache. Kueri yang dikompilasi digunakan kembali
di antara berbagai pemanggilan getNameById(long).
Lakukan iterasi di SQL, bukan di kode
Gunakan satu kueri yang menampilkan semua hasil yang ditargetkan, bukan loop terprogram yang melakukan iterasi pada kueri SQL untuk menampilkan hasil individual. Loop terprogram sekitar 1.000 kali lebih lambat daripada satu kueri SQL.
Menggunakan DISTINCT untuk nilai unik
Menggunakan kata kunci DISTINCT dapat meningkatkan performa kueri dengan
mengurangi jumlah data yang perlu diproses. Misalnya, jika Anda ingin
menampilkan nilai unik saja dari kolom, gunakan DISTINCT:
db.rawQuery("""
    SELECT DISTINCT name
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        // Only iterate over distinct names in Kotlin
        // Process distinct name
    }
}
Menggunakan fungsi gabungan jika memungkinkan
Gunakan fungsi agregat untuk hasil gabungan tanpa data baris. Misalnya, kode berikut memeriksa apakah ada setidaknya satu baris yang cocok:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery("""
    SELECT id, name
    FROM Customers
    WHERE city = 'Paris';
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToFirst()) {
        // At least one customer from Paris
        // Handle found
    } else {
        // No customers from Paris
        // Handle not found
}
Untuk mengambil baris pertama saja, Anda dapat menggunakan EXISTS() untuk menampilkan 0 jika tidak ada
baris yang cocok, dan 1 jika satu atau beberapa baris cocok:
db.rawQuery("""
    SELECT EXISTS (
        SELECT null
        FROM Customers
        WHERE city = 'Paris';
    );
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToFirst() && cursor.getInt(0) == 1) {
        // At least one customer from Paris
        // Handle found
    } else {
        // No customers from Paris
        // Handle not found
    }
}
Gunakan fungsi agregat SQLite dalam kode aplikasi Anda:
COUNT: menghitung jumlah baris dalam kolom.SUM: menambahkan semua nilai numerik dalam kolom.MINatauMAX: menentukan nilai terendah atau tertinggi. Berfungsi untuk kolom numerik, jenisDATE, dan jenis teks.AVG: menemukan nilai numerik rata-rata.GROUP_CONCAT: menyambungkan string dengan pemisah opsional.
Menggunakan COUNT(), bukan Cursor.getCount()
Dalam
contoh berikut, fungsi
Cursor.getCount()
membaca semua baris dari database dan menampilkan semua nilai baris:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery("""
    SELECT id
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    val count = cursor.getCount()
    // Use count
}
Namun, dengan menggunakan COUNT(), database hanya menampilkan
jumlah:
db.rawQuery("""
    SELECT COUNT(*)
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    cursor.moveToFirst()
    val count = cursor.getInt(0)
    // Use count
}
Kueri Nest, bukan kode
SQL adalah composable dan mendukung subkueri, gabungan, dan batasan kunci asing. Anda dapat menggunakan hasil dari satu kueri untuk kueri lain tanpa memeriksa kode aplikasi. Hal ini mengurangi kebutuhan untuk menyalin data dari SQLite dan memungkinkan mesin database mengoptimalkan kueri Anda.
Pada contoh berikut, Anda dapat menjalankan kueri untuk menemukan kota yang memiliki pelanggan terbanyak, lalu menggunakan hasil dalam kueri lain untuk menemukan semua pelanggan dari kota tersebut:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery("""
    SELECT city
    FROM Customers
    GROUP BY city
    ORDER BY COUNT(*) DESC
    LIMIT 1;
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToFirst()) {
        val topCity = cursor.getString(0)
        db.rawQuery("""
            SELECT name, city
            FROM Customers
            WHERE city = ?;
        """.trimIndent(),
        arrayOf(topCity)).use { innerCursor ->
            while (innerCursor.moveToNext()) {
                // Process inner cursor data
            }
        }
    }
}
Untuk mendapatkan hasilnya dengan durasi waktu setengah saja dari contoh sebelumnya, gunakan satu kueri SQL dengan pernyataan bertingkat:
db.rawQuery("""
    SELECT name, city
    FROM Customers
    WHERE city IN (
        SELECT city
        FROM Customers
        GROUP BY city
        ORDER BY COUNT (*) DESC
        LIMIT 1;
    );
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToNext()) {
        // Process cursor data
    }
}
Memeriksa keunikan di SQL
Jika baris tidak boleh disisipkan kecuali nilai kolom tertentu bersifat unik dalam tabel, akan lebih efisien untuk menerapkan keunikan tersebut sebagai batasan kolom.
Dalam contoh berikut, satu kueri dijalankan untuk memvalidasi baris yang akan disisipkan dan baris lain untuk benar-benar disisipkan:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery(
    """
    SELECT EXISTS (
        SELECT null
        FROM customers
        WHERE username = ?
    );
    """.trimIndent(),
    arrayOf(customer.username)
).use { cursor ->
    if (cursor.moveToFirst() && cursor.getInt(0) == 1) {
        throw AddCustomerException(customer)
    }
}
db.execSQL(
    "INSERT INTO customers VALUES (?, ?, ?)",
    arrayOf(
        customer.id.toString(),
        customer.name,
        customer.username
    )
)
Daripada memeriksa batasan unik di Kotlin, Anda dapat memeriksanya di SQL saat menentukan tabel:
CREATE TABLE Customers(
  id INTEGER PRIMARY KEY,
  name TEXT,
  username TEXT UNIQUE
);
SQLite melakukan hal yang sama dengan berikut ini:
CREATE TABLE Customers(...);
CREATE UNIQUE INDEX CustomersUsername ON Customers(username);
Sekarang Anda dapat menyisipkan baris dan membiarkan SQLite memeriksa batasannya:
try {
    db.execSQL(
        "INSERT INTO Customers VALUES (?, ?, ?)",
        arrayOf(customer.id.toString(), customer.name, customer.username)
    )
} catch(e: SQLiteConstraintException) {
    throw AddCustomerException(customer, e)
}
SQLite mendukung indeks unik dengan beberapa kolom:
CREATE TABLE table(...);
CREATE UNIQUE INDEX unique_table ON table(column1, column2, ...);
SQLite memvalidasi batasan lebih cepat dan dengan overhead yang lebih sedikit daripada kode Kotlin. Praktik terbaiknya adalah menggunakan SQLite, bukan kode aplikasi
Mengelompokkan beberapa penyisipan dalam satu transaksi
Suatu transaksi meng-commit beberapa operasi, yang tidak hanya meningkatkan efisiensi, tetapi juga ketepatan. Untuk meningkatkan konsistensi data dan mempercepat performa, Anda dapat mengelompokkan penyisipan:
db.beginTransaction()
try {
    customers.forEach { customer ->
        db.execSQL(
            "INSERT INTO Customers VALUES (?, ?, ?)",
            arrayOf(customer.id.toString(), customer.name, "customerValue")
        )
    }
    db.setTransactionSuccessful()
} finally {
    db.endTransaction()
}
Di luar transaksi eksplisit, setiap penulisan berjalan dalam transaksi implisitnya sendiri dan membayar biaya penuh commit, termasuk fsync dalam mode sinkron FULL. Pembuatan batch membayar biaya tersebut sekali, yang dapat membuat batch penulisan menjadi jauh lebih cepat.
Menggunakan alat pemecahan masalah
SQLite menyediakan alat pemecahan masalah berikut untuk membantu mengukur performa.
Menggunakan perintah interaktif SQLite
Jalankan SQLite di komputer Anda untuk menjalankan kueri dan belajar.
Versi platform Android yang berbeda menggunakan revisi SQLite yang berbeda. Untuk menggunakan
mesin yang sama dengan yang ada di perangkat Android, gunakan adb shell dan
jalankan sqlite3 di perangkat target Anda.
Anda dapat meminta SQLite untuk menghitung waktu kueri:
sqlite> .timer on
sqlite> SELECT ...
Run Time: real ... user ... sys ...
EXPLAIN QUERY PLAN
Anda dapat meminta SQLite untuk menjelaskan cara menjawab kueri dengan menggunakan
EXPLAIN QUERY PLAN:
sqlite> EXPLAIN QUERY PLAN
SELECT id, name
FROM Customers
WHERE city = 'Paris';
QUERY PLAN
`--SCAN Customers
Contoh sebelumnya memerlukan pemindaian tabel penuh tanpa indeks untuk menemukan semua pelanggan dari Paris. Hal ini disebut kompleksitas linear. SQLite perlu membaca semua baris dan hanya menyimpan baris yang cocok dengan pelanggan dari Paris. Untuk memperbaikinya, Anda dapat menambahkan indeks:
sqlite> CREATE INDEX Idx1 ON Customers(city);
sqlite> EXPLAIN QUERY PLAN
SELECT id, name
FROM Customers
WHERE city = 'Paris';
QUERY PLAN
`--SEARCH test USING INDEX Idx1 (city=?
Jika menggunakan shell interaktif, Anda dapat meminta SQLite untuk selalu menjelaskan rencana kueri:
sqlite> .eqp on
Untuk mengetahui informasi selengkapnya, lihat Perencanaan Kueri.
Penganalisis SQLite
SQLite menawarkan antarmuka command line (CLI) sqlite3_analyzer untuk membuang
informasi tambahan yang dapat digunakan untuk memecahkan masalah performa. Untuk menginstal,
buka Halaman Download SQLite.
Anda dapat menggunakan adb pull untuk mendownload file database dari perangkat target ke workstation
untuk dianalisis:
adb pull /data/data/<app_package_name>/databases/<db_name>.db
Browser SQLite
Anda juga dapat menginstal alat GUI Browser SQLite di halaman Download SQLite.
Logging Android
Android akan menghitung waktu kueri SQLite dan mencatatnya untuk Anda:
# Enable query time logging
$ adb shell setprop log.tag.SQLiteTime VERBOSE
# Disable query time logging
$ adb shell setprop log.tag.SQLiteTime ERROR
Di Android 13 dan yang lebih baru, Anda juga dapat mencatat hanya operasi yang lambat. Tetapkan nilai minimum dalam milidetik, lalu mulai ulang aplikasi Anda agar dapat membaca tag log:
$ adb shell setprop log.tag.SQLiteSlowQueries VERBOSE
$ adb shell setprop db.log.slow_query_threshold 100
$ adb shell am force-stop <package-name>
Operasi yang lambat muncul di logcat di bawah tag SQLiteConnection dengan
durasi, SQL, dan jalur database-nya. Untuk menetapkan batas untuk satu aplikasi, gunakan
db.log.slow_query_threshold.<uid>, dengan <uid> adalah UID aplikasi.
Pelacakan Perfetto
Saat mengonfigurasi Perfetto, tambahkan kategori atrace database untuk menyertakan
operasi SQLite dalam rekaman aktivitas. Untuk melihat apa yang dilakukan setiap thread saat menjalankan SQL, tambahkan juga peristiwa penjadwal:
data_sources {
  config {
    name: "linux.ftrace"
    ftrace_config {
      ftrace_events: "sched/sched_switch"
      ftrace_events: "sched/sched_waking"
      ftrace_events: "sched/sched_blocked_reason"
      atrace_categories: "database"
    }
  }
}
Android melacak setiap operasi database sebagai slice yang diberi nama sesuai operasi
dan SQL-nya, misalnya
executeForCursorWindow SELECT * FROM message WHERE body LIKE ?. SQL mempertahankan placeholder ?-nya dan dipotong menjadi 256 karakter. Argumen binding tidak disertakan. Operasi mencakup open, close, prepare, execute, dan varian executeFor. Slice prepare tidak berarti cache pernyataan tidak ditemukan.
Tata letak jalur bergantung pada versi Android:
- Di Android 17 dan yang lebih tinggi, setiap koneksi memiliki jalur asinkron dalam proses aplikasi
bernama
SQLiteConnection-yang diikuti dengan nomor koneksi. Transaksi muncul sebagai sliceTRANSACTION-EXCLUSIVE,TRANSACTION-IMMEDIATE, atauTRANSACTION-DEFERRED, dengan pernyataan yang dijalankan di dalamnya bertingkat di bawahnya. Thread yang menjalankan operasi juga mendapatkan peristiwa instanSTART-danEND-di jalur thread-nya, untuk setiap transaksi dan untuk setiap pernyataan di luar transaksi. Nama peristiwa ini diakhiri dengan nama jalur koneksi, misalnya-SQLiteConnection-0. - Di Android 16 dan yang lebih rendah, setiap pernyataan SQL yang berbeda memiliki jalur asinkronnya sendiri dalam proses aplikasi, dan transaksi tidak dilacak.
Nomor koneksi dimulai ulang dari 0 untuk setiap database, sehingga koneksi utama semua database dalam suatu proses berbagi jalur SQLiteConnection-0. Jika aplikasi Anda menggunakan lebih dari satu database secara bersamaan, ukur durasi dengan peristiwa START- dan END- di jalur thread.
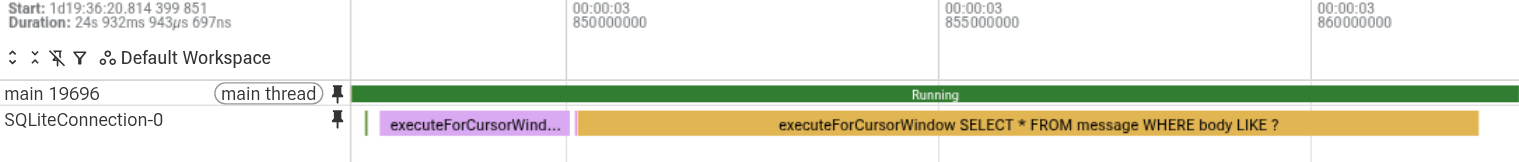
Gambar 1. Pemindaian tabel lengkap pada thread utama di Android 17.
Anda dapat menganalisis slice ini dengan PerfettoSQL di UI Perfetto atau dengan
trace_processor. Kueri berikut menemukan operasi SQLite yang paling sering dilakukan di setiap proses. Kueri ini berfungsi di semua versi Android:
INCLUDE PERFETTO MODULE slices.with_context;

SELECT process_name, name AS operation, COUNT(*) AS count
FROM process_slice
WHERE name GLOB 'open *' OR name GLOB 'close *'
  OR name GLOB 'prepare *' OR name GLOB 'execute*'
  OR name GLOB 'TRANSACTION-*'
GROUP BY process_name, name
ORDER BY count DESC
LIMIT 10;
Kueri berikut mencantumkan operasi SQLite yang memerlukan waktu lebih dari 1 md di thread utama di Android 17 dan yang lebih tinggi:
INCLUDE PERFETTO MODULE slices.with_context;

WITH marks AS (
  SELECT process_name, utid, is_main_thread, ts, name,
    LEAD(ts) OVER (PARTITION BY utid ORDER BY ts) AS end_ts,
    LEAD(name) OVER (PARTITION BY utid ORDER BY ts) AS end_name
  FROM thread_slice
  WHERE name GLOB 'START-*' OR name GLOB 'END-*'
)
SELECT process_name, ts, ROUND((end_ts - ts) / 1e6, 1) AS dur_ms,
  substr(name, 7) AS operation
FROM marks
WHERE name GLOB 'START-*'
  AND end_name = 'END-' || substr(name, 7)
  AND is_main_thread
  AND end_ts - ts > 1e6
ORDER BY dur_ms DESC
LIMIT 10;
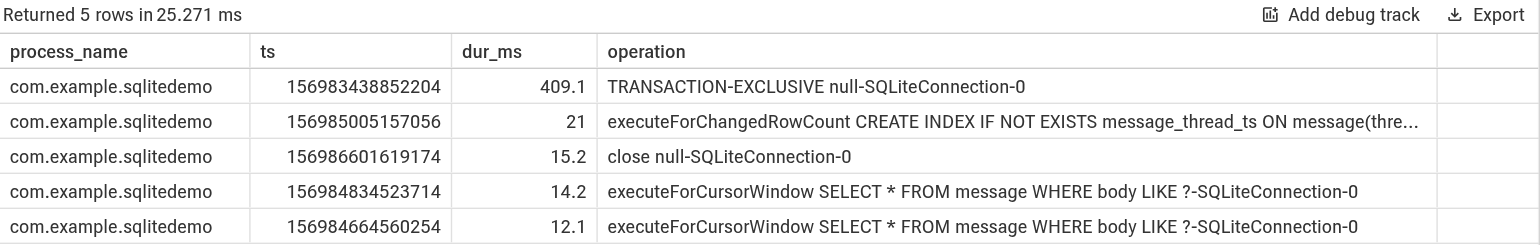
Gambar 2. Operasi SQLite yang lebih lama dari 1 md di thread utama.
Kueri berikut menemukan thread yang menulis di luar transaksi eksplisit, dengan setiap penulisan membayar commit-nya sendiri, di Android 17 dan yang lebih tinggi:
INCLUDE PERFETTO MODULE slices.with_context;

WITH ops AS (
  SELECT process_name, thread_name, utid, name,
    upper(ltrim(substr(name, instr(name, ' ') + 1))) AS sql
  FROM thread_slice
  WHERE name GLOB 'START-*'
)
SELECT process_name, thread_name,
  SUM(name GLOB 'START-TRANSACTION-*') AS transactions,
  SUM(name GLOB 'START-execute*' AND (sql GLOB 'INSERT *'
    OR sql GLOB 'UPDATE *' OR sql GLOB 'DELETE *' OR sql GLOB 'REPLACE *'))
    AS autocommit_writes
FROM ops
GROUP BY utid
HAVING autocommit_writes > 0
ORDER BY autocommit_writes DESC
LIMIT 10;
dumpsys meminfo
adb shell dumpsys meminfo <package-name> mencetak statistik yang terkait dengan penggunaan memori aplikasi, termasuk detail tentang SQLite di bagian DATABASES. Misalnya, ini diambil dari output
adb shell dumpsys meminfo com.google.android.gms.persistent di perangkat
developer:
DATABASES
      pgsz     dbsz   Lookaside(b) cache hits cache misses cache size  Dbname
PER CONNECTION STATS
         4       52             45     8    41     6  /data/user/10/com.google.android.gms/databases/gaia-discovery
         4        8                    0     0     0    (attached) temp
         4       52             56     5    23     6  /data/user/10/com.google.android.gms/databases/gaia-discovery (1)
         4      252             95   233   124    12  /data/user_de/10/com.google.android.gms/databases/phenotype.db
         4        8                    0     0     0    (attached) temp
         4      252             17     0    17     1  /data/user_de/10/com.google.android.gms/databases/phenotype.db (1)
         4     9280            105 103169 69805    25  /data/user/10/com.google.android.gms/databases/phenotype.db
         4       20                    0     0     0    (attached) temp
         4     9280            108 13877  6394    25  /data/user/10/com.google.android.gms/databases/phenotype.db (2)
         4        8                    0     0     0    (attached) temp
         4     9280            105 12548  5519    25  /data/user/10/com.google.android.gms/databases/phenotype.db (3)
         4        8                    0     0     0    (attached) temp
         4     9280            107 18328  7886    25  /data/user/10/com.google.android.gms/databases/phenotype.db (1)
         4        8                    0     0     0    (attached) temp
         4       36             51   156    29     5  /data/user/10/com.google.android.gms/databases/mobstore_gc_db_v0
         4       36             97    47    27    10  /data/user/10/com.google.android.gms/databases/context_feature_default.db
         4       36             56     3    16     4  /data/user/10/com.google.android.gms/databases/context_feature_default.db (2)
         4      300             40  2111    24     5  /data/user/10/com.google.android.gms/databases/gservices.db
         4      300             39     3    17     4  /data/user/10/com.google.android.gms/databases/gservices.db (1)
         4       20             17     0    14     1  /data/user/10/com.google.android.gms/databases/gms.notifications.db
         4       20             33     1    15     2  /data/user/10/com.google.android.gms/databases/gms.notifications.db (1)
         4      120             40   143   163     4  /data/user/10/com.google.android.gms/databases/android_pay
         4      120            123    86    32    19  /data/user/10/com.google.android.gms/databases/android_pay (1)
         4       28             33     4    17     3  /data/user/10/com.google.android.gms/databases/googlesettings.db
POOL STATS
     cache hits  cache misses    cache size  Dbname
             13            68            81  /data/user/10/com.google.android.gms/databases/gaia-discovery
            233           145           378  /data/user_de/10/com.google.android.gms/databases/phenotype.db
         147921         89616        237537  /data/user/10/com.google.android.gms/databases/phenotype.db
            156            30           186  /data/user/10/com.google.android.gms/databases/mobstore_gc_db_v0
             50            57           107  /data/user/10/com.google.android.gms/databases/context_feature_default.db
           2114            43          2157  /data/user/10/com.google.android.gms/databases/gservices.db
              1            31            32  /data/user/10/com.google.android.gms/databases/gms.notifications.db
            229           197           426  /data/user/10/com.google.android.gms/databases/android_pay
              4            18            22  /data/user/10/com.google.android.gms/databases/googlesettings.db
Android 14 dan yang lebih tinggi mencetak tabel PER CONNECTION STATS dan POOL STATS
yang ditampilkan dalam contoh. Android 13 dan yang lebih rendah hanya mencetak tabel per koneksi, dengan statistik cache digabungkan ke dalam satu kolom cache sebagai hits/misses/size.
Di bagian PER CONNECTION STATS, Anda akan menemukan:
pgsz: ukuran satu halaman database, dalam KB.dbsz: ukuran seluruh file database, dalam KB.Lookaside(b): jumlah slot memori lookaside yang digunakan koneksi. Meskipun ada(b)di header, ini adalah jumlah slot, bukan byte.cache hits,cache misses, dancache size: statistik untuk cache pernyataan yang disiapkan dari koneksi. Nilai ini menghitung pernyataan SQL yang dikompilasi, bukan halaman database.Dbname: jalur ke file database. Koneksi tambahan ke database yang sama memiliki nomor dalam tanda kurung yang ditambahkan, seperti(1). Dengan WAL, database dapat memiliki beberapa koneksi sehingga pembacaan dapat berjalan secara paralel.
Di bagian POOL STATS, Anda akan menemukan statistik cache pernyataan yang disiapkan untuk setiap
kumpulan koneksi:
cache hits: SQLite meng-cache pernyataan yang disiapkan dan mencoba menggunakannya kembali saat menjalankan kueri, untuk menghemat upaya dan memori dalam mengompilasi pernyataan SQL. Ini adalah jumlah cache ditemukan untuk pernyataan.cache misses: jumlah cache pernyataan yang tidak ditemukan.cache size: di Android 16 QPR2 dan yang lebih tinggi, jumlah pernyataan yang disiapkan dalam cache, dijumlahkan di seluruh koneksi yang tidak ada aktivitas di pool. Di Android 14 hingga Android 16 QPR1, nilai ini adalah jumlah hit dan miss, dan tidak mewakili ukuran cache.
Gunakan statistik ini untuk memutuskan apa yang perlu diperbaiki:
- Rasio kegagalan yang tinggi berarti SQLite mengompilasi pernyataan yang sama berulang kali.
Pertama, cari SQL yang dibuat dengan penyambungan string dan
parameterkan. Jika kueri Anda sudah
diberi parameter dan
cache sizeper koneksi berada pada batas 25, tingkatkan ukuran cache. - Jalur database yang muncul lebih dari sekali tanpa akhiran bergaya
(1)berarti aplikasi Anda membuka file yang sama dua kali. Buka setiap database satu kali. - Database yang jarang digunakan aplikasi Anda masih menyimpan memori saat terbuka. Tutup setelah selesai.
dumpsys dbinfo
adb shell dumpsys dbinfo <package-name> mencetak status setiap kumpulan koneksi di aplikasi Anda. Tambahkan -v untuk mencantumkan pernyataan dalam cache pernyataan yang disiapkan dari setiap koneksi. Contoh output berikut berasal dari
Android 17, dengan jalur dan baris panjang yang dipersingkat:
** Database info for pid 2705 [com.example.app] **
Connection pool for /data/user/0/com.example.app/databases/settings.db:
  Open: true
  Max connections: 4
  Total execution time (ms): 4963
  Total statements executed: 231239
  Average time per statement (ms): 0
  Configuration: openFlags=805306368, ..., journalMode=WAL, syncMode=NORMAL
  IsReadOnlyDatabase: false
  Available primary connection:
    <none>
  Available non-primary connections:
    <none>
  Acquired connections:
    <none>
  Connection waiters:
    <none>
Connection pool for /data/user/0/com.example.app/databases/events.db:
  Open: true
  Max connections: 1
  Total execution time (ms): 842
  Total statements executed: 840
  Average time per statement (ms): 1
  Configuration: openFlags=268435456, ..., journalMode=TRUNCATE, syncMode=FULL
  IsReadOnlyDatabase: false
  Available primary connection:
    Connection #0:
      isPrimaryConnection: true
      onlyAllowReadOnlyOperations: false
      totalLongOperations: 0
      Most recently executed operations:
        0: [10-26 04:22:32.133] executeForChangedRowCount took 0ms -
           succeeded, sql="DELETE FROM params WHERE app_id=?", path=...
        1: [10-26 04:22:32.133] prepare took 0ms - succeeded,
           sql="DELETE FROM params WHERE app_id=?", path=...
        ...
Cari hal berikut:
Configuration: mode jurnal dan mode sinkron pool. Di Android 13 dan yang lebih tinggi, baris ini menampilkan mode yang diterapkan framework, termasuk default platform. Dalam contoh ini,events.dbmenggunakan jurnal rollback dengan mode sinkronFULL, sehingga setiap commit menunggu sinkronisasi penuh. Baris ini tidak mencerminkan pernyataanPRAGMAyang Anda jalankan sendiri.Max connections: nilai 1 untuk database yang dapat ditulis berarti framework tidak menganggap database berada dalam mode WAL, sehingga pembacaan dan penulisan berbagi satu koneksi.Total execution time,Total statements executed, danAverage time per statement: tersedia di Android 13 dan yang lebih tinggi. Gunakan diagram ini untuk menemukan database yang paling sibuk.Most recently executed operations: 20 operasi terakhir pada setiap koneksi, dengan durasi dan SQL-nya. Cari pola seperti kueri yang sama yang berjalan dalam loop, atau banyak penulisan berturut-turut di luar transaksi. Di Android 15 QPR1 dan yang lebih tinggi, daftar ini juga menyertakan transaksi eksplisit.totalLongOperationsdanOperations exceeding 2000ms: tersedia di Android 15 QPR1 dan yang lebih baru. Dasbor ini menunjukkan jumlah operasi dan transaksi yang memerlukan waktu lebih dari 2 detik, dan mencantumkan 10 operasi dan transaksi terakhir.Acquired connectionsdanConnection waiters: koneksi yang sedang digunakan dan thread yang sedang menunggu koneksi. Waiter menunjukkan pertentangan, seperti transaksi tulis panjang yang memblokir operasi tulis lainnya.Prepared statement cache: dicetak dengan-v. Banyak entri yang hanya berbeda dalam nilai literal mengarah ke SQL yang dibuat dengan penyambungan string.- Jalur yang sama di bawah lebih dari satu judul
Connection pool forberarti aplikasi Anda membuka file yang sama dua kali.
Referensi lainnya
Konten penayangan
Direkomendasikan untuk Anda
- Catatan: teks link ditampilkan saat JavaScript nonaktif
- Menjalankan benchmark dalam Continuous Integration
- Periode frozen
- Membuat dan mengukur Profil Dasar Pengukuran tanpa Macrobenchmark